OpenAI 多模型分工指南:便宜模型做路由、強模型啃難題的官方選型方法

所有請求都發給最強旗艦模型太慢又費額度?按 OpenAI 官方模型選型指南整理:先用旗艦建質素基線、再逐節點下探最輕檔位,讓輕量模型承擔意圖路由與護欄提取、強模型專注複雜多步推理。

NNathaniel bigo··原創首發·AI 輔助撰寫
8 分鐘讀完
資料核對於 2026-11-18 · 依據官方文檔與公開資料整理 Plus 帳號

結論先說

  1. 官方推薦的選型順序是「從強往輕降(Top-down)」,而不是從最弱模型硬調:先拿最強旗艦模型跑通原型並定好驗收基線,再把簡單節點逐步替換成輕量模型。
  2. 不要讓一把錘子敲所有釘子:意圖分類、輸入合規攔截、格式提取交給便宜高吞吐模型;跨服務排錯、衝突方案權衡留給旗艦模型。
  3. 換模型之前先調推理強度(reasoning.effort):同一模型從高檔降到低檔就能顯著縮短等待時間並省下大量推理 token。
  4. 在代碼層有兩種現成落地方式:API 應用用 Agents SDK 的分診交接(handoffs),本地研發用 Codex 的子代理角色配置(.codex/agents/)。
  5. 路由之外一定要順手接住提示詞緩存(Prompt caching),把固定系統指令與工具定義放在前綴不動,重複請求的輸入成本能降一大截。
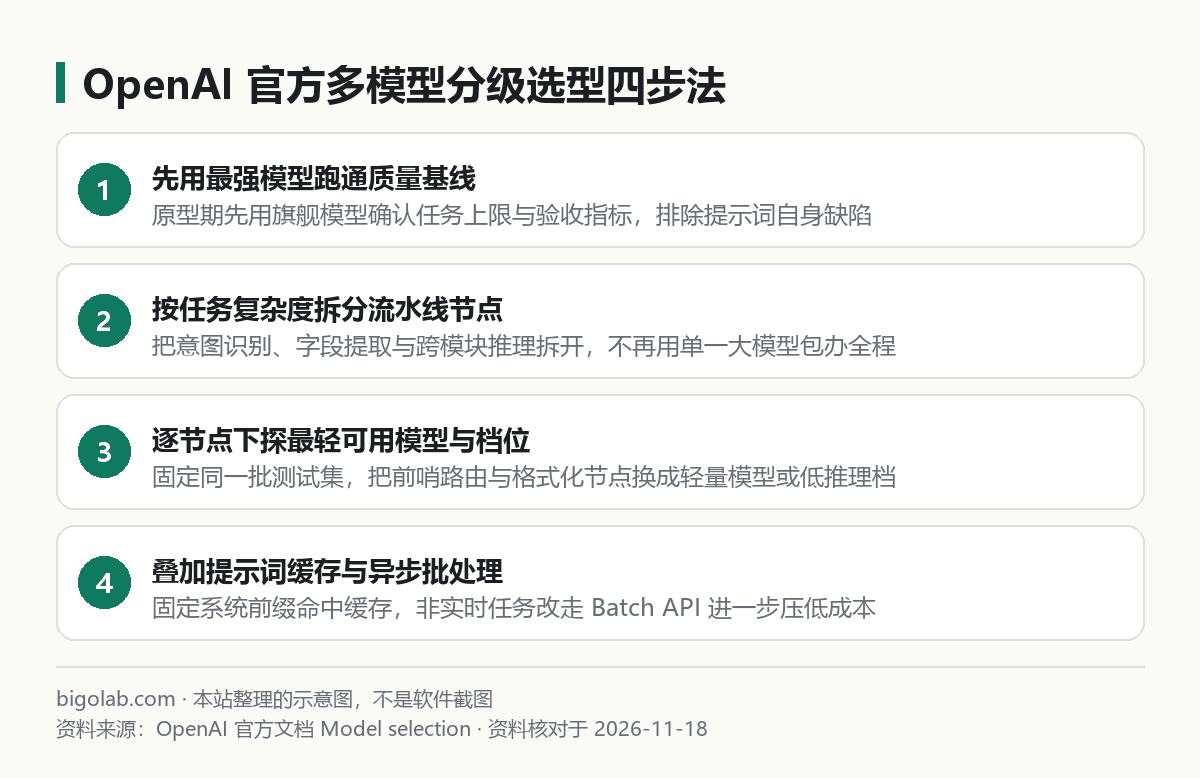
OpenAI 官方多模型分級選型四步法

圖:本站根據 OpenAI 開發者文檔:Model selection 整理的示意圖

本文根據 OpenAI 官方開發者文檔《Model selection》、Codex 文檔《Models》與 Agents SDK 文檔整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。如果你主要想看 Codex 客戶端裏四個主力模型的對比,請看 Codex 用哪個模型好:按任務推薦。

適用於誰

  • 做 AI 應用或多智能體流水線,把所有請求一刀切全扔給最強模型,結果首字延遲高、帳單居高不下的開發者;
  • 一上來直接用最便宜的小模型寫複雜業務,分不清效果差是「提示詞沒寫好」還是「模型能力不夠」的人;
  • 想在 OpenAI API、Agents SDK 或 Codex 裏落地「輕量模型做分診路由 + 強模型攻克難題」的人。

一、為什麼官方建議「先上旗艦定基線,再往下換輕模型」

很多團隊為了省預算,第一天就拿最便宜的小模型調複雜多步任務,調了一週不出效果,根本分不清到底是業務邏輯有漏洞,還是模型本身撐不住。OpenAI 官方指南給出的標準工程節奏分四步:

  1. 用旗艦模型探明上限:先用最強模型(例如在 Codex 與 Responses API 中使用 gpt-6.2-astra)把業務跑通,證明這套提示詞和工具定義確實能產出合格結果,並沉澱出幾十條代表性測試樣本。
  2. 拆解工作流顆粒度:把原本糊在一大段提示詞裏的任務拆成清晰的階段——哪一步只是判斷用戶想幹什麼?哪一步是從長文本里抽 JSON 字段?哪一步才真正需要多步權衡?
  3. 固定輸入逐層下探(Downshift):拿着同一批測試樣本,把前哨分類、數據提取環節換成 gpt-6-luna 等輕量模型,把常規編碼和文稿起草換成 gpt-6.2-sol,保留「剛剛好能穩定通過驗收標準的最輕配置」。
  4. 疊加緩存與異步通道:實時對話保持固定前綴吃滿提示詞緩存;夜間批量跑報表、離線評測等不急着等結果的任務改走異步 Batch API。

二、典型三級分工架構與代碼落地
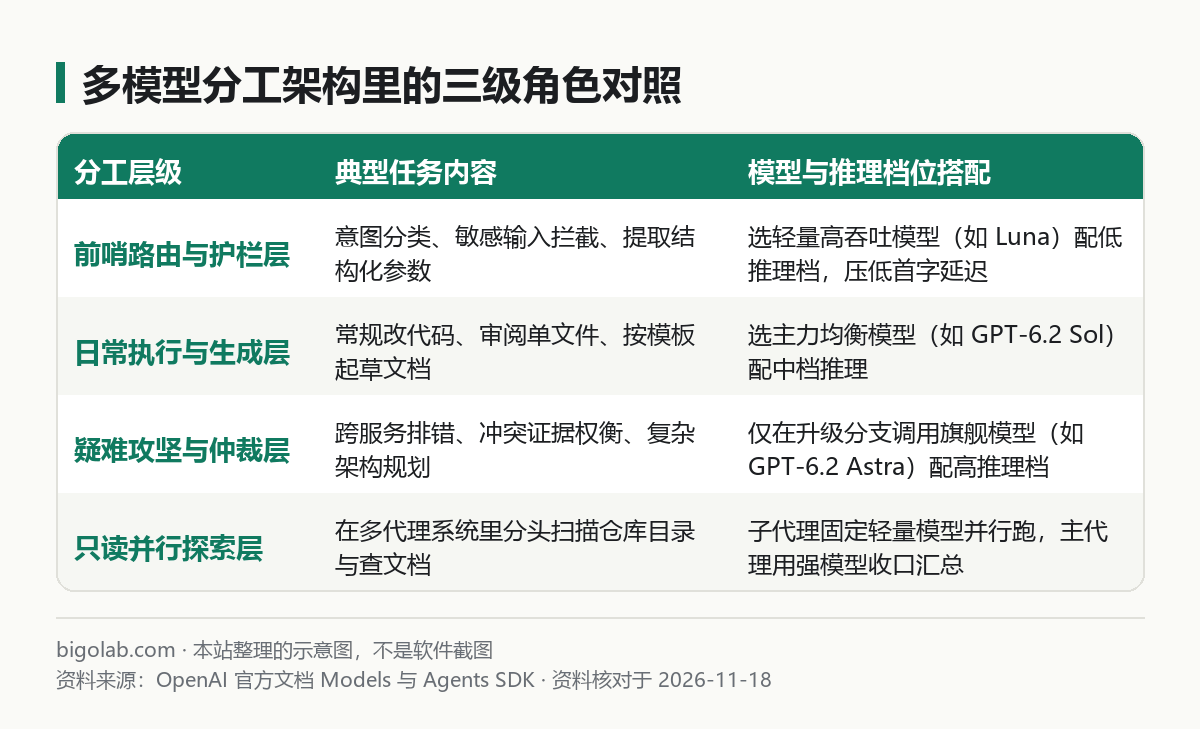
多模型分工架構裏的三級角色對照

圖:本站根據 Codex 官方文檔:Models 與 Agents SDK 整理的示意圖

1. 在 OpenAI Agents SDK 裏用便宜模型做分診路由

在客服、工單或研發助手系統裏,80% 的入口流量只是查狀態或簡單問答。我們可以給入口分診台和輸入護欄掛輕量模型,只有識別出疑難故障時才通過 handoffs 交接給旗艦模型(交接與護欄細則見 Agents SDK Handoffs 與 Agents as Tools 及 Guardrails 與 Tracing 詳解):

python
from agents import Agent, Runner

# 簡單高頻問答:繼續用均衡或輕量模型直接回復
faq_agent = Agent(
    name="FAQ Agent",
    model="gpt-6.2-sol",
    handoff_description="處理常規配置查詢、基礎語法與文檔問答",
    instructions="簡明解答用戶的常規使用問題。",
)

# 複雜跨模組排錯:升級到強推理旗艦模型
deep_debug_agent = Agent(
    name="Deep Debugger",
    model="gpt-6.2-astra",
    handoff_description="處理跨服務線上故障、並發競態與架構取捨難題",
    instructions="深入分析調用鏈與邊界條件,給出驗證步驟與最小修複方案。",
)

# 入口路由層:只做意圖識別與分發,用最輕快的模型壓低首跳延遲
router_agent = Agent(
    name="Router",
    model="gpt-6-luna",
    instructions="只判斷問題複雜度並立即交接給對應專員,不要自己展開長篇作答。",
    handoffs=[faq_agent, deep_debug_agent],
)

result = Runner.run_sync(router_agent, "兩個微服務在高並發扣庫存時偶發死鎖,附日誌如下……")
print(result.final_output)

2. 在 Codex 本地開發裏給探索子代理配輕量模型

不寫 SDK 代碼、只用 Codex 寫項目時,同樣能跑多模型分工:主會話保持 gpt-6.2-sol 或 gpt-6.2-astra 把握全局方案,同時在 .codex/agents/ 下把翻目錄、搜引用、查文檔的只讀子代理固定為 gpt-6-luna(完整配置見 Codex 多 Agent 與子代理怎麼用)。這樣既保住了主線程上下文乾淨,又不會讓幾十次文件搜尋把套餐窗口瞬間刷空。

想要在日常開發中解鎖 GPT-6.2 Sol 與 Astra 等多檔模型自由切換搭配,個人可在本站查看 ChatGPT Plus 充值說明,團隊共享空間可看 ChatGPT Business 團隊版定製。

常見問題

問:前面多加一層輕量路由模型,會不會反而讓總響應變慢?

答:不會拖慢整體體驗,反而能顯著降低平均耗時。路由層只輸出十幾個 token 的工具交接指令,輕量模型通常幾百毫秒內就能完成分發,讓佔大頭的簡單請求徹底避開重型模型的長思考排隊。

問:如果便宜路由模型偶爾分錯了類怎麼辦?

答:給下游常規執行智能體保留一條「向上升級(Escalate)」的交接通道——當常規模型發現問題超出預期複雜度時,允許它再交接給旗艦專家兜底。

問:在同一個對話裏來回切換不同模型會影響提示詞緩存嗎?

答:會。不同模型各自維護獨立的提示詞緩存池,頻繁在同一條長線程裏切模型會導致首次請求重算整段前綴;因此通過子代理或 as_tool() 把不同模型的上下文拆開往往更划算。

相關教學

參考資料

  • OpenAI 官方文檔:Model selection — https://developers.openai.com/api/docs/guides/model-selection
  • Codex 官方文檔:Models — https://learn.chatgpt.com/docs/models
  • OpenAI Agents SDK 官方文檔:Handoffs — https://openai.github.io/openai-agents-python/handoffs/

Nathaniel 的更多內容

  1. 01

    LangGraph 流式輸出(Streaming)詳解:逐字 Token 流、節點進度與自定義事件寫法

    多步智能體如果等全部節點跑完才返回,網頁前端就會白屏乾等十幾秒。本文按 LangGraph 官方文檔講清 updates、messages、custom 與 values 四種 stream_mode 的區別,以及組合訂閱逐字打字機輸出加工具內部實時進度的完整代碼。

    其他 AI 工具0
  2. 02

    LangGraph 持久化與長期記憶怎麼配:Checkpointer、Store 與 PostgreSQL 實戰

    在生產環境跑 LangGraph,單靠 InMemorySaver 一重啟就會丟失全部對話。本文按官方文檔講清線程內短期檢查點(Checkpointer)與跨線程長期記憶(Store)的分工,以及用 langgraph-checkpoint-postgres 對接 PostgreSQL 的完整步驟。

    其他 AI 工具0
  3. 03

    LangGraph 多智能體怎麼寫:Supervisor 主管包與 Subgraph 隔離子圖實戰

    在 LangGraph 裏把單個圖擴展成多智能體協作有兩條官方路線:快速原型用預置包 langgraph-supervisor,大型生產系統用原生子圖(Subgraph)嵌套。本文講清兩種寫法的完整代碼、私有狀態隔離防 Token 膨脹技巧以及檢查點傳播規則。

    其他 AI 工具0
  4. 04

    LangGraph 人工介入審批怎麼寫:interrupt 暫停圖運行與 Command 恢復實戰

    企業之所以選 LangGraph,很大程度看中它能安全掛起等待人工審批(Human-in-the-Loop)。本文按官方最新規範講清 interrupt() 動態暫停、Checkpointer 必備條件、Command(resume=...) 恢復執行,以及防止副作用重複運行的重入規則。

    其他 AI 工具0
  5. 05

    多 Agent 協作平台怎麼選:Dify、釦子(Coze)、n8n 與 LangGraph 多智能體機制對比

    搜「多agent協作平台」時,Dify、釦子、n8n 和 LangGraph 都宣稱支持多智能體,但底層的調度方式完全不同。本文跳過基礎安裝,專門從多 Agent 角色跳轉、子代理工具調用、上下文隔離與私有化部署四個維度幫你一次選準。

    其他 AI 工具0
  6. 06

    企業微信有官方 MCP 和 CLI 嗎:@wecom/cli 安裝初始化、長連接機器人與接入教學

    搜「企業 微信 有 mcp 嗎」不用再東拼西湊民間群機器人腳本了:企業微信官方已推出 @wecom/cli 命令行工具並內置 stdio 模式的 MCP Server。本文按官方開發者文檔講清安裝、智能機器人長連接初始化、業務命令與接入 Claude Code 步驟。

    Claude其他 AI 工具0

同模型

  1. 01

    OpenAI Agents SDK 的 Guardrails 與 Tracing 怎麼用:安全護欄與鏈路追蹤詳解

    多智能體上線怕跑偏或出錯難查?按 OpenAI Agents SDK 官方文檔整理:@input_guardrail 與 @output_guardrail 熔斷機制、多代理鏈路裏的護欄生效位置,以及用 trace() 合併追蹤與脫敏控制。

    ChatGPT其他 AI 工具0
  2. 02

    OpenAI Agents SDK 多代理教學:Handoffs 交接與 Agents as Tools 怎麼選

    用 OpenAI Agents SDK 搭多智能體系統時,該用 handoffs 交接會話,還是用 agent.as_tool() 把子智能體當工具調?按官方文檔講清兩者的控制權差異、上下文過濾、Python 代碼寫法與選型標準。

    ChatGPT其他 AI 工具0
  3. 03

    GPT-6 發佈時間與更新了什麼:從 GPT-6 Astra 到聊天版 GPT-6(2026 年 9 月至 10 月時間線)

    GPT-6 什麼時候發佈?9 月 3 日 Astra 先向有限組織開放,9 月 22 日 Sol 和 Luna 進 Work 和 Codex,10 月 7 日 GPT-6 與 Intelligent UI 進入聊天。按時間線講更新了什麼。

    ChatGPT0
  4. 04

    GPT-6 怎麼用:在 ChatGPT 裏選到 GPT-6、各套餐能用哪幾檔,Intelligent UI 能讓它做什麼(可複製的提問)

    GPT-6 怎麼用?在 ChatGPT 模型選單選 GPT-6,再用 Thinking 滑桿選檔,Plus 有 Medium 和 High。講各套餐能用哪幾檔,以及 Intelligent UI 的用法和可複製的提問。

    ChatGPT0
  5. 05

    GPT-6 Pro(Astra)怎麼用、哪些套餐有:怎麼選到 Pro 檔、用量限制和 Pro 三檔價格

    GPT-6 Pro(Astra)怎麼用、哪些套餐有?按 OpenAI 幫助中心核對:聊天裏 Pro 檔給 Pro 100、Pro 200、Business 和 Enterprise;Plus 在 Work 和 Codex 裏含 Astra。講怎麼選到、用量上限和官方 Pro 價格。

    ChatGPT0
  6. 06

    OpenAI Agents SDK 教學:安裝、第一個智能體、工具與多智能體交接(Python)

    OpenAI Agents SDK 是什麼、怎麼上手?按官方 README 和 Quickstart 講清安裝命令、設定 API Key、十行代碼跑起第一個智能體、給它加函數工具、用 handoffs 做多智能體分工、在 Trace viewer 裏看調用過程,以及它的核心概念各是什麼。

    ChatGPT其他 AI 工具0

同產品的其他教學

  1. 01

    AutoGen 現在怎麼樣了?微軟官方演進路線與 Microsoft Agent Framework 入門

    搜 AutoGen 新教學常被 0.2、0.4、社區分支和 Semantic Kernel 繞暈。按微軟官方文檔,微軟已將 AutoGen 與 Semantic Kernel 兩支團隊合併推出統一的開源框架 Microsoft Agent Framework。本文講清現狀與 Python 快速上手。

    ChatGPT其他 AI 工具0
  2. 02

    多 Agent 的成本為什麼翻倍、怎麼控制:Token 膨脹根源與五項降本措施

    剛把單智能體拆成多 Agent,用量往往暴漲好幾倍。Anthropic 工程報告統計單智能體約為聊天的 4 倍 Token,多智能體可達約 15 倍。本文拆解固定前綴重複加載、歷史搬運、工具鏈定義與緩存失效四大根源,並給出五條實操控費辦法。

    ChatGPTClaude0
  3. 03

    多 Agent 協同開發怎麼落地:「一個寫、一個審」雙代理工作流搭建指南

    多 Agent 協同開發裏投入產出比最高的模式就是「一個寫、一個審」。本文依據 Anthropic 與 OpenAI 官方編碼最佳實踐,講清為什麼同會話自審容易漏問題,以及用只讀子代理、跨模型交叉審查(Claude Code + Codex)和自動化閉環落地的具體方法。

    ClaudeCodex0
  4. 04

    多 Agent 編排模式詳解:編排者-工作者、交接(Handoffs)、並行與評估循環怎麼選

    搜「multi-agent orchestration 中文」會被各家框架的不同術語繞暈。本文對照 Anthropic《Building effective agents》與 OpenAI 智能體指南,把編排者-工作者、去中心化交接、並行分片投票與生成-評估循環四種標準編排拓撲講透。

    ChatGPTClaude0
  5. 05

    多智能體(Multi-Agent)是什麼、什麼時候該用:Anthropic 與 OpenAI 官方判斷標準

    多智能體不是代理越多越聰明。本文依據 Anthropic 研究系統架構文章與 OpenAI 官方智能體指南,講清確定性工作流、單智能體與多智能體的區別,以及哪三類瓶頸才值得上多智能體協同。

    ChatGPTClaude0
  6. 06

    codebase-memory 類 MCP 是什麼、怎麼用:基於語法樹圖譜的本地代碼索引原理與配置

    codebase-memory-mcp(DeusData/codebase-memory-mcp)是一類本地代碼圖譜 MCP 伺服器:用 Tree-sitter 把倉庫解析成函數與調用關係的 SQLite 圖庫,幫編碼助手查調用鏈並省下讀整份文件的額度。

    ClaudeCodex0

0 條評論

登入 後參與評論

還沒有評論,來搶沙發~