
結論先說
- 所有主流多 Agent 框架底層的編排拓撲,拆開來都不出四種基本模式:編排者-工作者(中心主管)、去中心化交接(Handoffs)、並行化(分片與投票)、生成-評估循環。
- 需要一箇中心大腦統攬全局、動態拆題並彙總多方結果時,選「編排者-工作者」(OpenAI 稱為 Manager / Agents as Tools)。
- 對話主題已經徹底轉向另一個專業領域、前序節點無需再插手時,選「交接(Handoffs)」,直接把當前會話控制權移交給下游專家。
- 子任務彼此無依賴、只想縮短總等待時間或交叉核驗時,選「並行化」,在應用代碼層並發調用再合併結果。
- 複雜工程裏四種模式常常嵌套組合——比如中心主管在底層並發派出三個檢索工作者,拿到彙總初稿後再走一輪評估代理質檢。
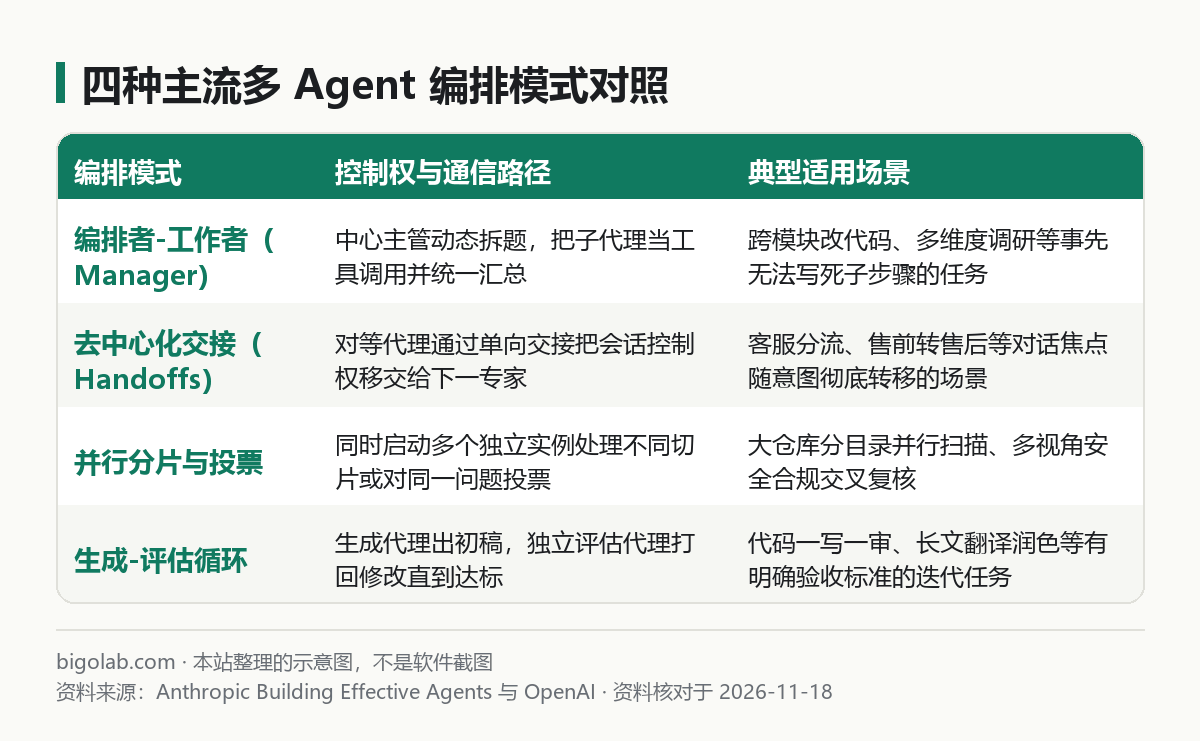
圖:本站根據 Anthropic Building Effective Agents 與 OpenAI 指南 整理的示意圖
本文根據 Anthropic 官方工程指南《Building effective agents》與 OpenAI 官方指南《A practical guide to building agents》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方網站。
適用於誰
- 搜「multi-agent orchestration 中文」「多 agent 編排模式」的人;
- 已經決定要做多智能體(判斷依據見 /guides/multi-agent-what-is-when-to-use),但不知道代理之間該設成「上下級彙報」還是「平級轉交」的開發者;
- 看不同開源框架文檔時,被 Supervisor、Manager、Swarm、Handoffs、Fan-out 等名詞搞混的人。
一、模式一:編排者-工作者(Orchestrator-Workers / Manager)
這是軟件研發與深度研究助手裏最常用的主從結構。中心有一個編排者(Orchestrator / Manager),手下掛載若干專職工作者(Workers)。
它的關鍵特徵是「動態拆解 + 控制權不外放」:
- 子步驟不是寫死的:面對用戶一句話需求(比如「重構鑑權模組並補齊受影響接口的測試」),事先沒法在代碼裏硬編碼到底要改幾個文件。中心編排者先讀現場情況,再動態決定派哪幾個工作者、傳什麼任務描述;
- 子代理表現為一個工具調用:工作者在自己的隔離上下文裏幹完活,把結果作為工具返回值交回中心編排者,始終由編排者跟用戶對話並負最終合成責任。
落地提示:編排者負責全局判斷,建議配強推理模型;底下的只讀檢索或格式提取工作者配輕量模型即可,模型分級思路見 /guides/openai-multi-model-routing-cheap-vs-strong。
二、模式二:去中心化交接(Decentralized / Handoffs)
OpenAI 在指南里把「交接(Handoffs)」與上面的中心主管模式並列為兩大核心多代理拓撲(SDK 代碼級對比見 /guides/openai-agents-sdk-handoffs-vs-agents-as-tools)。
在這套拓撲裏,各個代理是對等節點(Peers),沒有高高在上的總管:
- 前台接待代理先識別用戶來意;
- 一旦確認用戶要辦「退訂退款」,接待代理調用一次交接函數,單向把活躍會話的控制權和必要歷史轉移給售後專員代理,自己隨即退出本輪執行;
- 接下來用戶的追問直接由售後專員代理接住,不再每次繞回前台傳話。
這種模式省掉了中心主管每輪中轉複述的延遲和 Token 開銷,特別適合多輪客服分流、按業務線切分的企業內網門戶。但設計時必須防住一個坑:避免 A 交接給 B、B 覺得不歸自己管又交接回 A 的死循環,務必在運行器上設最大跳轉次數並加好輸入輸出護欄(見 /guides/openai-agents-sdk-guardrails-tracing)。
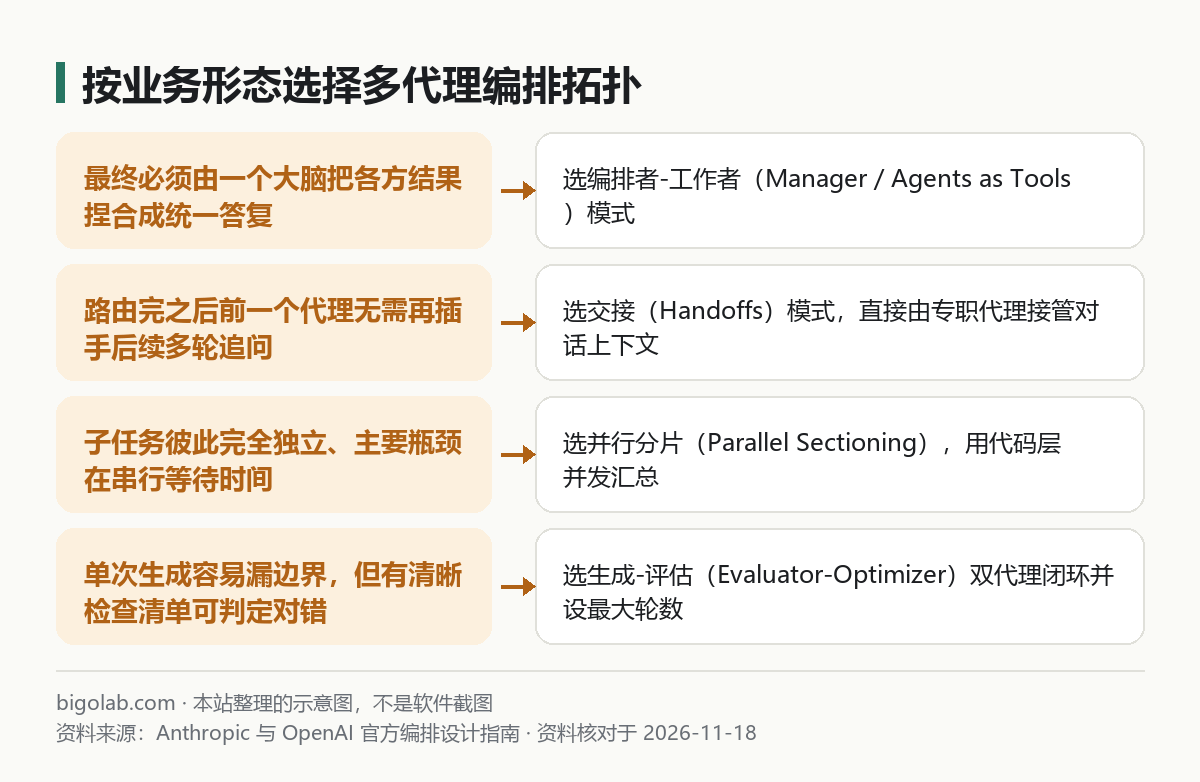
圖:本站根據 Anthropic 與 OpenAI 官方編排設計指南 整理的示意圖
三、模式三:並行化(Parallelization:分片與投票)
Anthropic 把並行模式細分為兩種截然不同的用法,它們的共同點是不靠大模型臨時想怎麼拆,而是由你寫好的確定性代碼並發發出請求(例如 Python 的 asyncio.gather 或 TypeScript 的 Promise.all):
- 分片(Sectioning):把一件大事按固定維度切成互不干擾的幾塊同時跑。比如審閱一份 Pull Request 時,代碼同時發給三個專職提示詞:一個只查 SQL 注入與鑑權安全,一個只查性能慢查詢,一個只核對接口命名規範,最後合併成一份評審列表,總耗時只取決於最慢的那一路;
- 投票(Voting):把同一道高風險判斷題同時發給多個不同視角或不同提示詞的調用,按多數票或「一票否決」做決斷。常見於內容合規篩查或高危線上變更審批,用幾倍的輸入成本換取更低的漏報率。
四、模式四:生成-評估循環(Evaluator-Optimizer)
當你發現單次提示詞無論怎麼調,模型寫出來的長代碼或複雜翻譯總是顧此失彼時,可以把「創作者」和「挑刺者」拆成兩個獨立代理形成反饋閉環:
- 生成代理(Generator) 按需求給出第一版產出;
- 評估代理(Evaluator) 對照一份明確的驗收清單逐項打分,如果未通過,給出具體的缺陷位置和修改方向(但不自己動手重寫);
- 生成代理拿到反饋改出第二版,直到評估通過或達到你設定的最大迭代輪數(通常設 2 到 3 輪即可,再多邊際收益遞減)。
平時在網頁端或客戶端驗證這套多角色提示詞、對比不同主力模型的指令遵循度時,若需要穩定的個人訂閱環境,可參考 /chongzhi/claude-pro 或 /chongzhi/chatgpt-plus 的官方套餐說明。
常見問題
Q:「路由(Routing)」和「交接(Handoffs)」是一回事嗎?
路由通常是單輪入口處的輕量分類器(識別問題類型後分發給一條獨立鏈路,做完即結束);而交接面向的是持續多輪的有狀態智能體對話,即使在對話中途需求變了,當前專家也能再次把控制權交接給下一個專家。
Q:編排者-工作者和並行分片怎麼區分?
看「子任務清單是誰定的」。如果每次固定拆成安全、性能、規範三路,代碼直接並發調就行,這是並行分片;如果必須先讓大模型讀完用戶問題才能決定今天要派幾個代理、各查哪張表,這就是編排者-工作者。
Q:真實項目裏要把這四種全用上嗎?
千萬別為了湊模式而堆疊層級。每多套一層編排,端到端延遲和排查難度就會翻一截。每次只針對當前最卡脖子的那個痛點引入一種模式,用追蹤日誌驗證確有提升後再保留。
相關教學
- /guides/multi-agent-what-is-when-to-use:多智能體是什麼、什麼時候值得用
- /guides/openai-agents-sdk-handoffs-vs-agents-as-tools:OpenAI Agents SDK 交接與工具化代理代碼對比
- /guides/openai-agents-sdk-guardrails-tracing:多代理護欄攔截與鏈路追蹤實戰
- /guides/openai-multi-model-routing-cheap-vs-strong:多模型分級路由與成本優化
參考資料
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI:A practical guide to building agents — https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
0 條評論
還沒有評論,來搶沙發~