
結論先說
- 想半小時搭出「中心主管 + 幾個專職代理」的原型,裝官方擴展包
langgraph-supervisor,調用create_supervisor即可自動生成調度邊。 - 上正式生產環境,更推薦用原生「隔離子圖(Subgraph)」寫法:把每個專家團隊編譯成擁有獨立私有
State的子圖,父圖通過一個薄包裝函數調用它,只傳精簡指令、只拿回最終結論。 - 檢查點儲存器(Checkpointer)千萬別在父圖和子圖裏重複傳:只需在最外層父圖
parent.compile(checkpointer=...)傳一次,LangGraph 會自動向下傳播持久化能力。 - 想看清嵌套子圖內部長什麼樣,導出流程圖時加上
xray=True參數就能一鍵把黑盒展開。
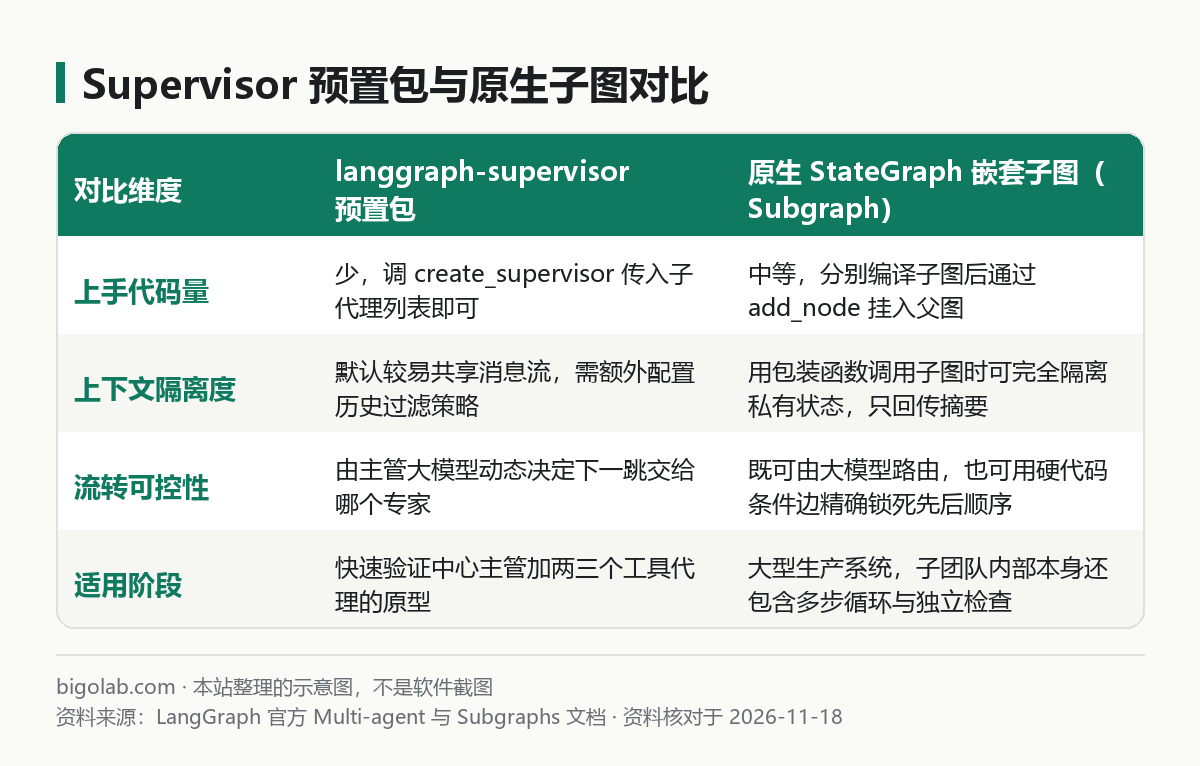
圖:本站根據 LangGraph 官方 Multi-agent 與 Subgraphs 文檔 整理的示意圖
本文根據 LangChain / LangGraph 官方文檔《Multi-agent systems》《Subgraphs》與langgraph-supervisor-py官方倉庫整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 LangChain 官方網站。
適用於誰
- 搜「langgraph 多智能體」「langgraph supervisor 怎麼用」「langgraph subgraph 子圖」的開發者;
- 已經寫順了單個
StateGraph(基礎見 /guides/langgraph-quickstart-install-first-graph),準備把臃腫的二十個工具拆給「檢索專家」「分析專家」等多個角色協同的工程師; - 把所有子代理全塞進同一個
MessagesState後,發現前一個代理的幾十條查庫報錯把後一個代理徹底繞暈的人。
一、路線一:用 langgraph-supervisor 快速搭中心主管模式
如果你的業務正好是標準的「編排者-工作者」拓撲(原理見 /guides/multi-agent-orchestration-patterns),不想自己手寫主管的路由工具,可以直接安裝官方維護的預置包:
bash
pip install -U langgraph langgraph-supervisor langchain-openai
只需先把底下的專職工作者建好(記得給每個工作者起清晰的英文 name),再交給 create_supervisor 彙總編譯:
python
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent
from langgraph_supervisor import create_supervisor

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# 定義兩個職責分明的底層工作者
sql_worker = create_react_agent(
    model=model,
    tools=[],  # 此處掛載只讀數據庫查詢工具
    name="sql_expert",
    prompt="你只負責查詢訂單與庫存統計數字,如實返回數據結果。",
)

doc_worker = create_react_agent(
    model=model,
    tools=[],  # 此處掛載內部退換貨規則檢索工具
    name="policy_expert",
    prompt="你只負責核對公司售後條款細則,給出明確條款依據。",
)

# 組裝中心主管工作流
workflow = create_supervisor(
    [sql_worker, doc_worker],
    model=ChatOpenAI(model="gpt-4o", temperature=0),
    prompt="你是客服主管,先視需求調度 sql_expert 與 policy_expert 收集事實,最後統一作答。",
)

app = workflow.compile()
注意主管模式的一個調優參數:預設情況下如果把子代理內部的中間工具調用全攤進主對話流,Token 消耗會漲得很快(原因見 /guides/multi-agent-token-cost-why-high-how-to-control),建議檢查 output_mode 參數只向主管保留子代理的最後一條總結消息。
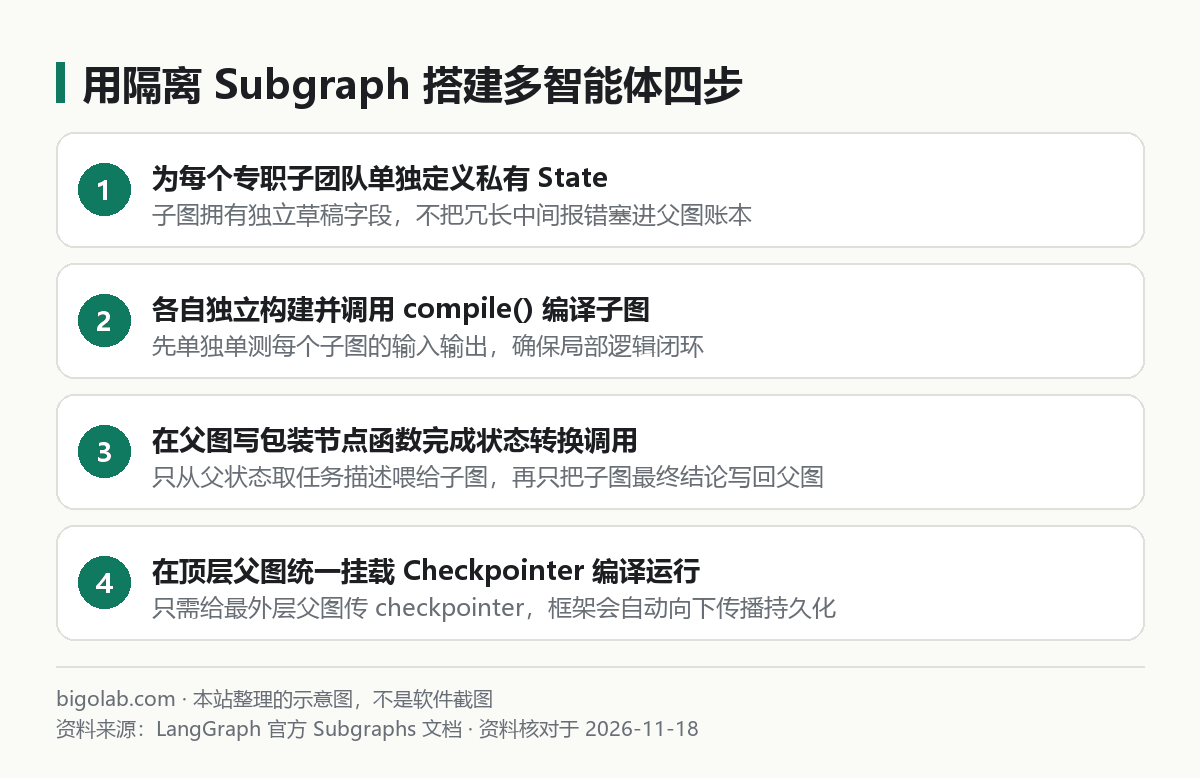
圖:本站根據 LangGraph 官方 Subgraphs 文檔 整理的示意圖
二、路線二:用原生 Subgraph(子圖)實現徹底的上下文隔離
當某個專家角色內部本身就需要走三四個固定步驟(比如「生成 SQL → 校驗語法 → 跑查詢 → 脫敏彙總」),並且你希望它內部的 raw_rows、retry_count 等髒草稿絕不污染頂層父圖的共享帳本時,原生子圖是上限最高的寫法。
官方文檔給出了兩種掛載子圖的方式:
- 共享鍵名直接掛載:父子
State包含同名字段時,直接parent.add_node("team_a", compiled_sub); - 包裝函數轉換狀態(強烈推薦):父子
State完全獨立,在父圖節點函數里手動調用compiled_sub.invoke(...),做好輸入輸出的「上下文防火牆」。
下面是一個完整的「私有狀態子圖」代碼骨架:
python
from typing import TypedDict
from langgraph.graph import StateGraph, START, END

# 1. 子圖擁有完全私有的內部狀態字段(父圖看不見 scratchpad)
class AuditSubState(TypedDict):
    target_text: str
    scratchpad: str
    verdict: str

def scan_risk_node(state: AuditSubState):
    # 模擬子團隊內部多步分析,中間草稿留在 scratchpad
    found = "含外部未核實連結" if "http" in state["target_text"] else "無異常"
    return {"scratchpad": f"內部掃描日誌: {found}", "verdict": found}

sub_builder = StateGraph(AuditSubState)
sub_builder.add_node("scan", scan_risk_node)
sub_builder.add_edge(START, "scan")
sub_builder.add_edge("scan", END)
# 注意:子圖直接無參 compile(),不要單獨傳 checkpointer
audit_subgraph = sub_builder.compile()

# 2. 頂層父圖狀態乾淨清爽,只存業務主幹數據
class MainState(TypedDict):
    draft_article: str
    audit_summary: str

# 3. 用包裝函數連接父圖與子圖,實現精確的輸入輸出裁剪
def call_audit_team(state: MainState):
    sub_out = audit_subgraph.invoke({
        "target_text": state["draft_article"],
        "scratchpad": "",
        "verdict": "",
    })
    # 只把精簡結論帶回父圖,丟棄子圖內部的冗長 scratchpad
    return {"audit_summary": sub_out["verdict"]}

parent_builder = StateGraph(MainState)
parent_builder.add_node("audit_team", call_audit_team)
parent_builder.add_edge(START, "audit_team")
parent_builder.add_edge("audit_team", END)

main_graph = parent_builder.compile()
三、子圖調試與持久化注意事項
- 展開查看嵌套連線:調用
main_graph.get_graph(xray=True).draw_mermaid()時,如果子圖是直接掛入節點的,Mermaid 圖會把子圖內部拓撲一併展開(可視化與 Studio 調試方法見 /guides/langgraph-debug-visualize-studio-guide); - 子圖內同樣支持
interrupt()人工審批:只要頂層父圖編譯時掛載了checkpointer,子圖深處觸發的斷點也能被外層正常捕獲並用同一個thread_id恢復;除非你明確需要某個子圖維護脫離父會話的獨立記憶,否則不要給子圖設checkpointer=True。
平時研發階段藉助前沿大模型快速拆分父子狀態 Schema 與編寫單測用例時,個人官方訂閱參考資訊可見 /chongzhi/chatgpt-plus。
常見問題
Q:包裝函數里調子圖時,怎麼讓外層的流式輸出也能實時看到子圖內部的進度?
在父圖的 stream 或 astream 調用裏傳入 subgraphs=True 參數(例如 main_graph.stream(inputs, subgraphs=True)),流事件就會帶上命名空間前綴把子圖內部每一步的變化一併吐出來。
Q:一張父圖底下最多適合掛多少個子圖?
工程上單層主管直接調度的子代理或子圖建議控制在 3 到 6 個以內;如果業務模組超過十個,建議先在入口用確定性分類節點分流到對應二級主管,避免單個主管在十幾個相似角色描述之間搖擺選錯。
Q:兩個平級子圖之間可以直接用 Command(goto=...) 互相跳轉做交接嗎?
可以。新版 LangGraph 支持在子圖節點返回 Command(goto="另一個節點名", graph=Command.PARENT),不需要中心主管居中傳話就能把執行控制權直接移交給父圖裏的下一個平級專家節點,適合多階段順序或按需轉辦流程。
相關教學
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安裝與第一個狀態圖
- /guides/multi-agent-orchestration-patterns:編排者-工作者與去中心化交接原理
- /guides/multi-agent-token-cost-why-high-how-to-control:為什麼隔離上下文能大幅壓低多代理成本
- /guides/langgraph-debug-visualize-studio-guide:用
xray=True與 Studio 調試複雜狀態圖
參考資料
- LangChain / LangGraph 官方文檔:Subgraphs & Multi-agent — https://docs.langchain.com/
langchain-ai/langgraph-supervisor-py官方倉庫 — https://github.com/langchain-ai/langgraph-supervisor-py
0 條評論
還沒有評論,來搶沙發~