
結論先說
- 新版 LangGraph 原生支持用數組同時訂閱多種流模式(如
stream_mode=["updates", "messages", "custom"]),不再需要去啃繁瑣難記的舊版事件過濾。 - 想要聊天框逐字打字機效果,開
stream_mode="messages":每次產出(message_chunk, metadata),並且可以用metadata["langgraph_node"]精準過濾只把最終答覆節點的字推給用戶。 - 想要頂部步驟條顯示「剛跑完哪個節點」,開
stream_mode="updates"。 - 想在耗時工具函數內部主動往外報進度(比如「已抓取第 3/10 篇文檔」),開
stream_mode="custom",並在節點或工具裏調get_stream_writer()推送任意字典。
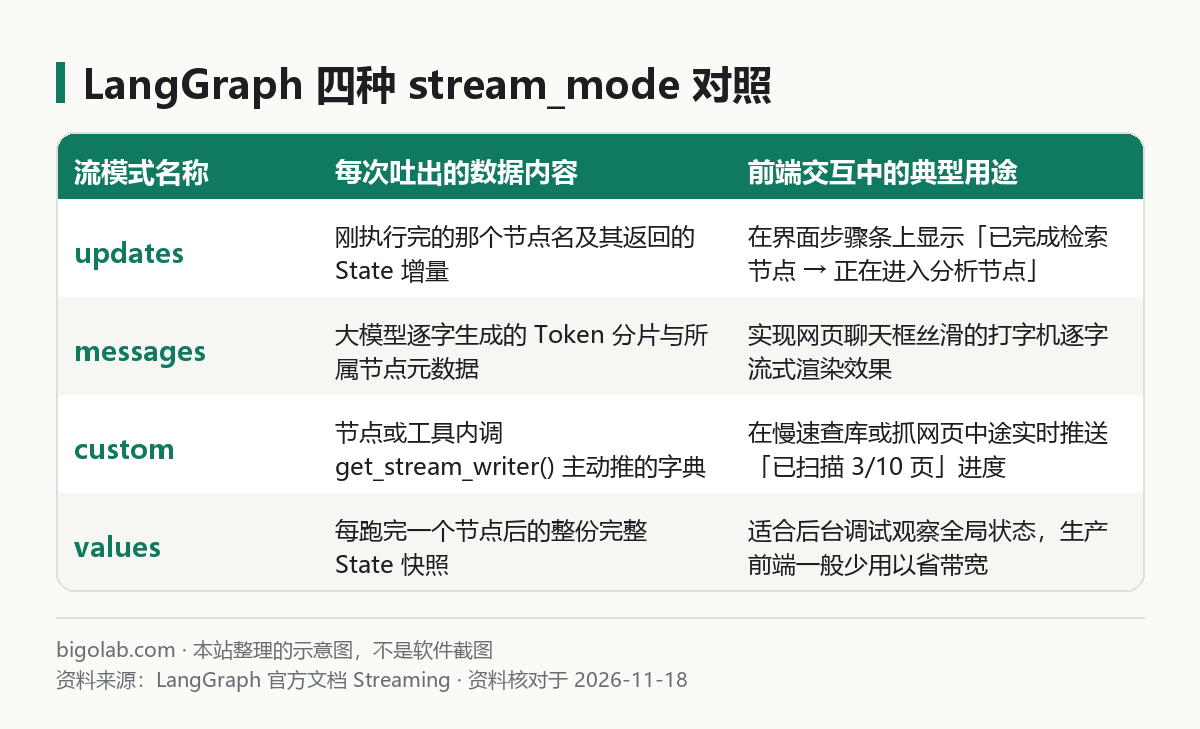
圖:本站根據 LangGraph 官方文檔 Streaming 整理的示意圖
本文根據 LangChain / LangGraph 官方文檔《Streaming》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 LangChain 官方網站。
適用於誰
- 搜「langgraph 流式輸出」「langgraph stream_mode messages」「langgraph 怎麼逐字返回」的前後端開發者;
- 用
graph.invoke()跑多節點智能體時前端轉圈等待超過十秒,想做成一邊顯示「正在查庫…」、一邊逐字蹦出最終答覆的工程師; - 搞不清新版原生
stream_mode="messages"和早期astream_events該用哪個、或者遇到內部路由節點把醜陋 JSON 也直接推上前端螢幕的人。
如果你熟悉單次直接調底層接口的流式寫法(可對照 /guides/openai-api-streaming 與 /guides/claude-api-streaming),會發現狀態圖的難點在於同時流式傳遞「圖走到哪一步了」和「當前模型吐到哪個字了」。
一、一段代碼同時打通「工具內部進度 + 節點切換 + 逐字輸出」
假設我們的狀態圖(基礎結構見 /guides/langgraph-quickstart-install-first-graph)包含一個「內部意圖分類節點」和一個「對外答覆節點」。我們既不想讓分類節點的中間 JSON 露在用戶螢幕上,又想在慢工具運行期間實時彙報百分比進度:
python
import asyncio
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.config import get_stream_writer
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition

@tool
async def batch_sync_records(batch_name: str) -> str:
    """批量校驗歸檔數據記錄。"""
    # 在工具內部直接獲取寫入器,主動向前端推送自定義進度
    writer = get_stream_writer()
    for step in (30, 70, 100):
        await asyncio.sleep(0.3)
        writer({"stage": "syncing", "batch": batch_name, "percent": step})
    return f"批次 {batch_name} 共 120 條記錄核驗無誤"

tools = [batch_sync_records]
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0).bind_tools(tools)

async def responder_node(state: MessagesState):
    res = await llm.ainvoke(state["messages"])
    return {"messages": [res]}

builder = StateGraph(MessagesState)
builder.add_node("responder", responder_node)
builder.add_node("tools", ToolNode(tools))
builder.add_edge(START, "responder")
builder.add_conditional_edges("responder", tools_condition)
builder.add_edge("tools", "responder")
graph = builder.compile()

async def main():
    # 當傳入列表訂閱多路模式時,每次迭代返回 (mode_name, payload) 二元組
    async for mode, chunk in graph.astream(
        {"messages": [("user", "請校驗批次 B2026 的數據並總結")]},
        stream_mode=["custom", "updates", "messages"],
    ):
        if mode == "custom":
            print(f"\n[實時進度] {chunk}")
        elif mode == "updates":
            finished_nodes = list(chunk.keys())
            print(f"\n[節點流轉] 剛完成節點: {finished_nodes}")
        elif mode == "messages":
            msg_chunk, meta = chunk
            # 關鍵過濾:只渲染 responder 節點的文本分片,忽略空內容與工具入參分片
            if meta.get("langgraph_node") == "responder" and msg_chunk.content:
                print(msg_chunk.content, end="", flush=True)

if __name__ == "__main__":
    asyncio.run(main())
把上面三個 if / elif 分支包裝成 FastAPI 的 StreamingResponse(按 SSE event: token、event: progress 格式發給瀏覽器),就是一套體驗非常完整的現代 AI 助手流式接口。
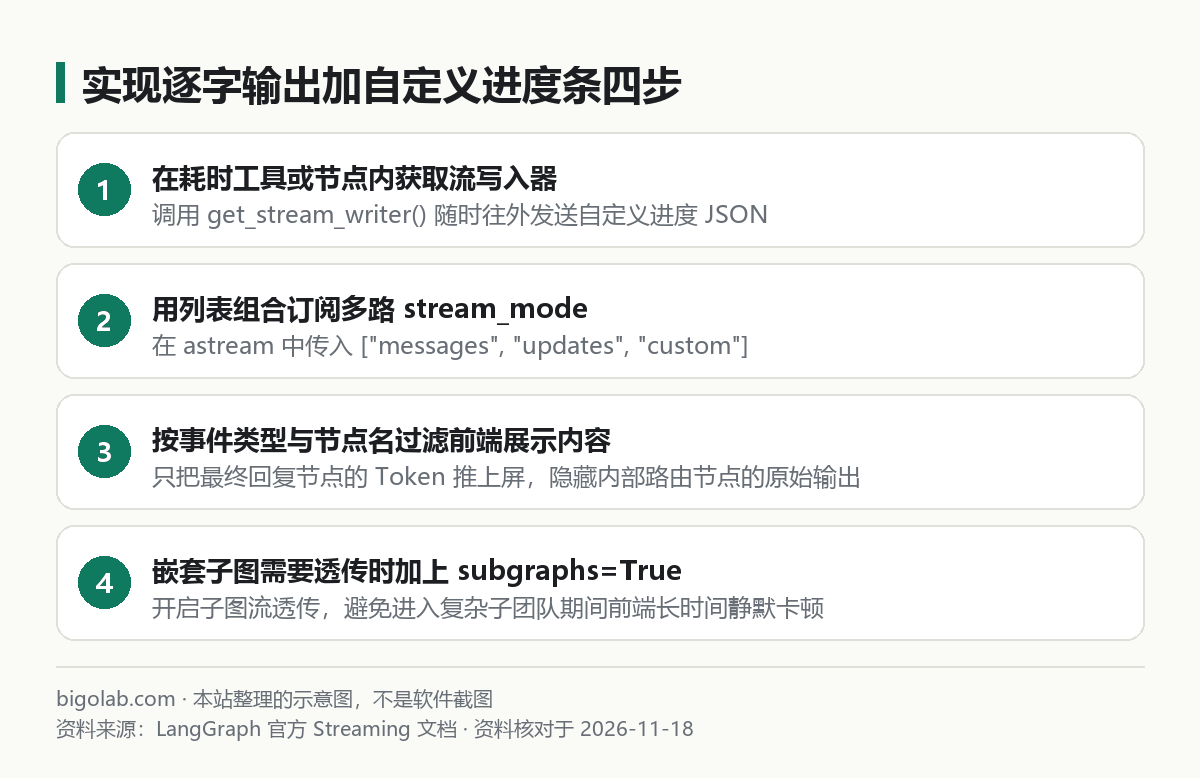
圖:本站根據 LangGraph 官方 Streaming 文檔 整理的示意圖
二、生產接流式時最常踩的三個坑
- 節點裏用了同步調用或非流式包裝導致整段一次性蹦出來:在異步
astream模式下,節點內部請盡量使用異步的await llm.ainvoke(...)。在 Python 3.11 及以上版本中,LangGraph 會自動攔截節點內部ainvoke的底層流分片餵給"messages"通道;如果在低版本 Python 遇到不逐字吐詞,顯式將config: RunnableConfig透傳進await llm.ainvoke(..., config=config)即可修復; - 多 Agent 嵌套子圖期間流突然中斷幾秒沒動靜:當你的主圖把任務派給了嵌套子圖(寫法見 /guides/langgraph-multi-agent-supervisor-subgraph-guide)時,預設外層只發頂層節點事件。只需在
graph.astream(..., subgraphs=True)加上subgraphs=True,就能把子圖內部的進度和 Token 透傳出來; - 前置 Nginx 反向代理把流攢在緩衝區:後端代碼明明寫了
flush,網頁還是等五秒才蹦一大段,九成是被網關緩存了——記得在響應頭加上X-Accel-Buffering: no與Cache-Control: no-cache。
平時前後端聯調 SSE 流式解析協議、藉助 Claude 排查異步協程阻塞點時,個人官方訂閱說明也可參考 /chongzhi/claude-pro。
常見問題
Q:那以前教學裏寫的 graph.astream_events(..., version="v2") 還能用嗎?
依然可以使用,它屬於來自 langchain_core 的通用底層回調流。但對於純 LangGraph 項目,原生 stream_mode=["messages", "updates", "custom"] 返回的結構乾淨得多,而且天生支持 get_stream_writer() 自定義業務進度,新寫代碼建議直接用原生 stream_mode。
Q:同一張圖裏有三個不同的大模型節點,怎麼防止內部思考節點的草稿暴露給前端用戶?
除了上面代碼演示的檢查 meta.get("langgraph_node") == "對外節點名" 之外,你也可以在初始化內部路由所用的模型實例時加上標籤(如 ChatOpenAI(..., tags=["internal_router"])),在前端推送層遇到帶該標籤的分片直接跳過即可。
Q:用戶在網頁端點了「停止生成」按鈕,後端正在流式運行的狀態圖怎麼及時中止?
在 FastAPI 等異步服務框架中,當檢測到客戶端斷開 SSE 連接(await request.is_disconnected())或收到取消信號時,直接跳出 async for ... in graph.astream(...) 循環或取消對應的異步 Task 即可。只要編譯時掛載了檢查點儲存器,前一個已經跑完的完整節點狀態依然會安全留在庫裏,不會造成髒數據損壞。
Q:開啟 "messages" 逐字流後,大模型發起工具調用的參數 JSON 也會被拆碎吐出來嗎?
會的,模型生成工具調用入參時同樣會產生帶 tool_call_chunks 屬性的消息分片,而此時文本字段 msg_chunk.content 通常為空字符串。因此前端只展示文字對話時,務必加上 if msg_chunk.content: 判斷,就能天然過濾掉底層的工具參數拼裝碎片。
相關教學
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安裝與第一個狀態圖
- /guides/langgraph-multi-agent-supervisor-subgraph-guide:LangGraph 多智能體與
subgraphs=True嵌套實戰 - /guides/openai-api-streaming:OpenAI API 原生流式輸出處理指南
- /guides/claude-api-streaming:Claude API 流式響應事件詳解
參考資料
- LangChain / LangGraph 官方文檔:Streaming — https://docs.langchain.com/
langchain-ai/langgraph官方 GitHub 倉庫 — https://github.com/langchain-ai/langgraph
0 條評論
還沒有評論,來搶沙發~