
本文根據 Claude 官方《Streaming messages》和《Claude API errors》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 Anthropic 官方網站。API 是按用量計費的獨立服務,與 Claude 訂閱分開計算,Key 的獲取見 /guides/claude-api-key-console。
適用於誰
- 想做聊天介面、讓回答逐字出現的開發者;
- 請求經常超時,聽說“要用流式”卻不知道怎麼改的人;
- 已跑通第一個請求(見 /guides/claude-api-python-quickstart),想往下走一步的人。
結論先說
- 最省事的寫法是 SDK 的
stream助手:Python 遍歷text_stream,TypeScript 註冊on("text", ...),不必自己解析事件。 - 底層是 SSE 事件流,順序固定:
message_start,若干個內容塊,若干個message_delta,最後message_stop。 - 工具調用的參數是一段一段的部分 JSON(
input_json_delta),要拼完再解析。 - 流可以在返回 200 之後才出錯,所以要處理
error事件,不能只看狀態碼。 max_tokens很大時必須流式;不想逐個處理事件,就用“流式收集、最後拿完整消息”的寫法。
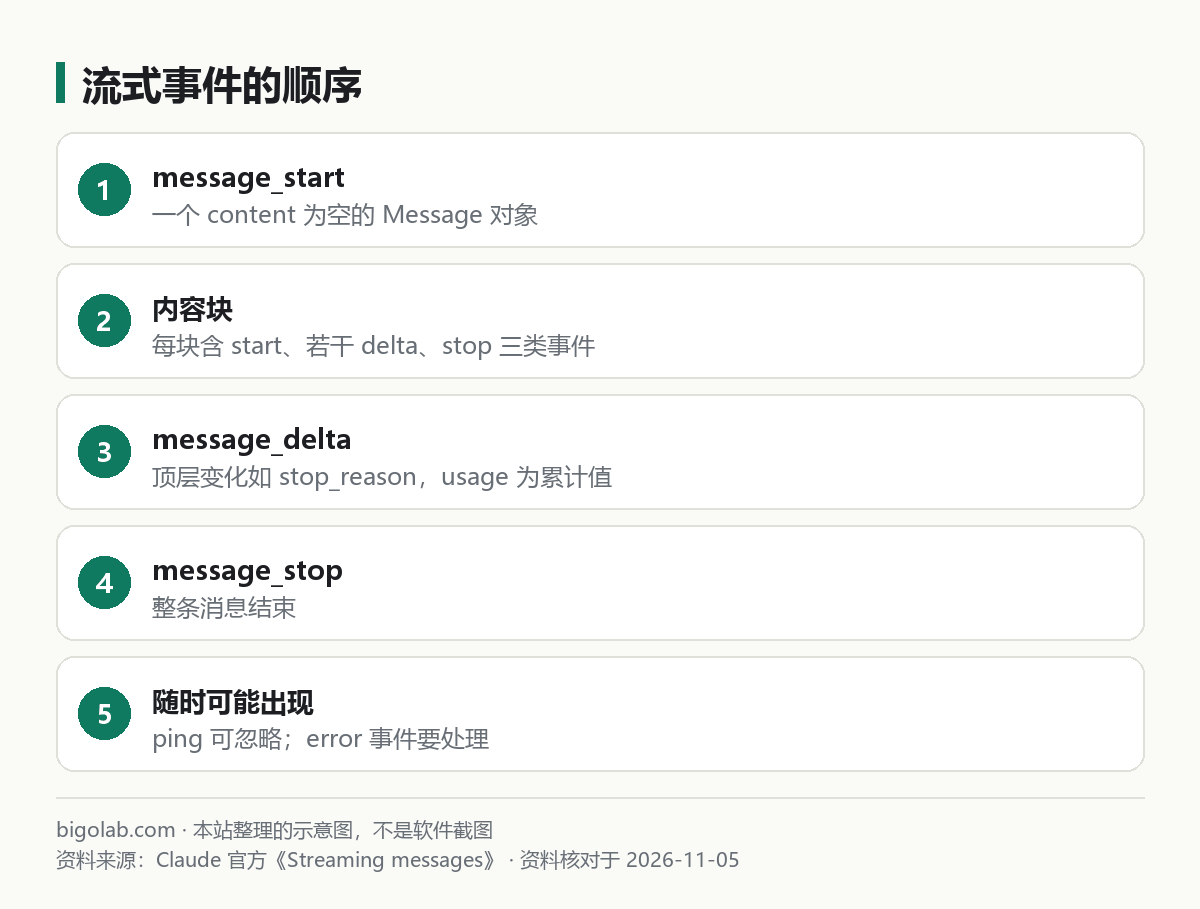
圖:本站根據 Claude 官方《Streaming messages》 整理的示意圖
一、最簡單的寫法:SDK 的 stream 助手
Python:
python
import anthropic

client = anthropic.Anthropic()

with client.messages.stream(
    max_tokens=1024,
    messages=[{"role": "user", "content": "用三句話介紹流式輸出"}],
    model="claude-opus-5-5",  # 以官方模型頁當天為準
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
TypeScript(先安裝 @anthropic-ai/sdk,基礎用法見 /guides/claude-api-typescript-quickstart):
typescript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

await client.messages
  .stream({
    model: "claude-opus-5-5",
    max_tokens: 1024,
    messages: [{ role: "user", content: "用三句話介紹流式輸出" }],
  })
  .on("text", (text) => {
    process.stdout.write(text);
  });
兩段代碼做的是同一件事:每來一小段文字就打印一小段。API 密鑰預設從環境變量 ANTHROPIC_API_KEY 讀取。
二、需要完整消息時:流式收集,最後一次取出
有些請求本身就需要很長的輸出,你並不想一段段顯示,只想要最後的完整結果。官方的做法是讓 SDK 在內部用流式,最後返回和普通調用一模一樣的 Message 對象:
python
with client.messages.stream(
    max_tokens=128000,
    messages=[{"role": "user", "content": "寫一份很長的分析……"}],
    model="claude-opus-5-5",
) as stream:
    message = stream.get_final_message()

for block in message.content:
    if block.type == "text":
        print(block.text)
TypeScript 對應的是 await stream.finalMessage()。官方在這裏反覆強調的原因是:把 max_tokens 設得很大又不用流式,網絡可能在中途掐斷空閒連接,請求會失敗或超時;SDK 還會在非流式請求預計超過約 10 分鐘時直接報錯。所以大輸出統一走流式,是官方的推薦。
三、事件的順序
直接發 stream: true 的原始請求,會收到 SSE 事件。每個事件有名字(例如 event: message_stop),數據裏的 type 與之對應。完整順序:
message_start:一個Message對象,content是空的;- 一個或多個內容塊,每個塊依次是
content_block_start、若干content_block_delta、content_block_stop;index對應最終content數組裏的位置; - 一個或多個
message_delta:對最終消息的頂層改動,比如stop_reason; message_stop。
中間可能夾着任意數量的 ping,忽略即可。官方特別提醒一點:message_delta 裏 usage 的 token 數是累計值,不要每次相加。
官方還明確說,將來可能新增事件類型,你的代碼要能容忍不認識的事件,而不是直接崩潰。
四、各種 delta 長什麼樣
content_block_delta 裏的 delta 有幾種:
text_delta:普通文字,text字段是新增的那一小段;input_json_delta:工具調用的參數,partial_json是部分 JSON 字符串。最終的tool_use.input是對象,所以要把各段字符串累加,等content_block_stop到了再解析。官方說 Python 和 TypeScript 的流式助手可以增量地給你解析後的input。注意官方的提示:當前模型一次只會發出input裏一個完整的鍵值對,所以用工具時事件之間可能有停頓;thinking_delta:開啟思考後,思考內容的增量,對應thinking塊的thinking字段;signature_delta:思考塊的簽名,在content_block_stop之前發送,用來校驗思考塊沒被改過。
思考相關的參數見 /guides/claude-api-extended-thinking。把思考的 display 設為 "omitted" 時,不會再流式發送思考文字,只會各有一個空的 thinking_delta 和一個 signature_delta,官方說這樣第一段正文出現得更早,但思考 token 仍會計費。工具調用的完整流程見 /guides/claude-tool-use-basics。
五、一個手寫的原始事件循環
只想看懂原理,或者不用 SDK 助手時,可以直接遍歷事件。下面是本站按官方事件名寫的示意,不是官方原文:
python
with client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "你好"}],
    stream=True,
) as events:
    for event in events:
        if event.type == "content_block_delta" and event.delta.type == "text_delta":
            print(event.delta.text, end="", flush=True)
TypeScript 的寫法是 for await (const event of stream),判斷條件相同。需要中途取消時,TypeScript 可以 break 退出循環,或調用 stream.controller.abort()。
六、流裏的錯誤怎麼處理
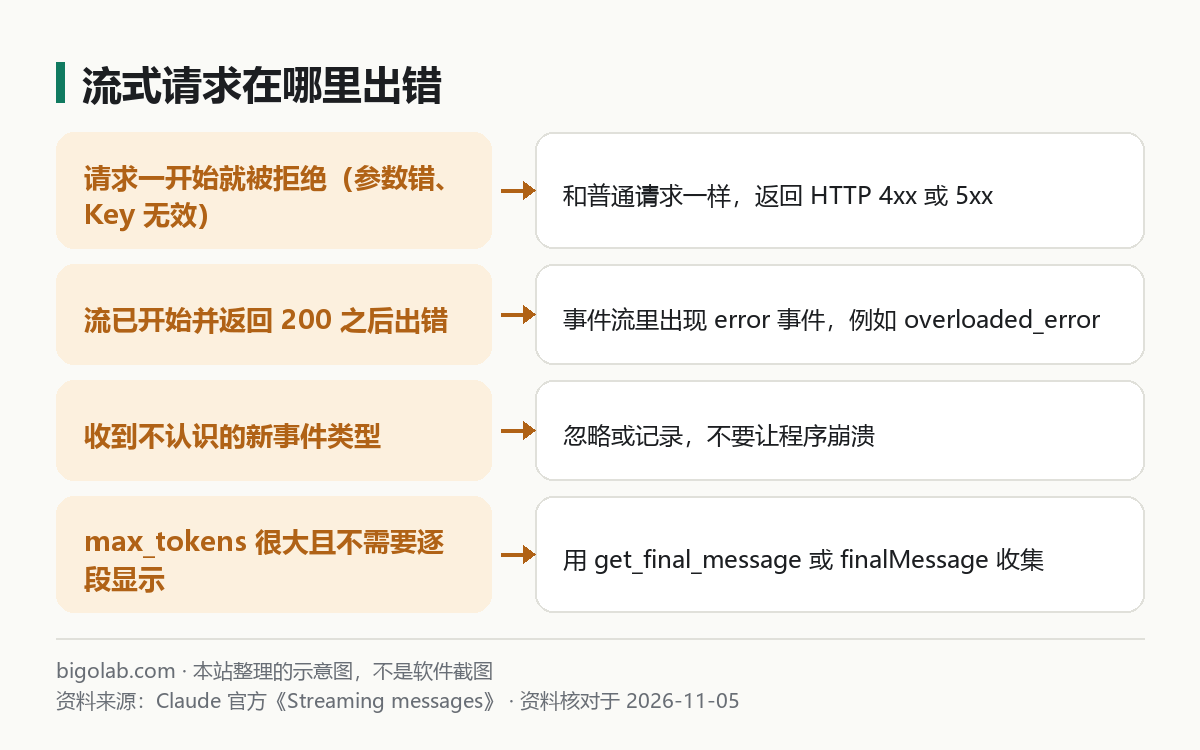
圖:本站根據 Claude 官方《Streaming messages》 整理的示意圖
普通請求出錯,你拿到的是 4xx 或 5xx 狀態碼。流式請求不一樣:
- 請求一開始就被拒絕(比如參數錯誤、Key 無效),仍是 HTTP 錯誤碼;
- 流已經開始、返回了 200 之後出錯,你會在事件流裏收到一個
error事件,例如高負載時的overloaded_error,它對應非流式場景的 HTTP 529。
所以循環裏要識別 error 事件,並決定是重試還是把已收到的內容先儲存下來。官方沒有在這一頁給出統一的斷點續傳辦法,具體策略要自己設計。排查 429 和 529 請看 /guides/claude-api-error-429-rate-limit 與 /guides/claude-api-error-529-overloaded。
常見問題
Q:流式會更便宜嗎?
不會。計費看 token,不看是否流式。流式改善的是首字出現的速度和長請求的穩定性。
Q:流式能和 Batch 一起用嗎?
不能。官方的批處理文檔列出 stream: true 是批請求不支持的參數,批量請求見 /guides/claude-api-message-batches。
Q:我只想要最終 JSON,怎麼辦?
用流式收集拿完整消息,或者看 /guides/claude-api-structured-outputs。
參考資料
- Claude 官方:Streaming messages — https://platform.claude.com/docs/en/build-with-claude/streaming
- Claude 官方:Claude API errors — https://platform.claude.com/docs/en/api/errors
0 條評論
還沒有評論,來搶沙發~