
本文根據 Claude 開發者平台官方文檔《Web search tool》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 已經跑通 Claude API 基礎調用,想讓回答帶上最新資訊的開發者;
- 做問答、調研類應用,需要限定來源網站、顯示引用的人。
這裏講的是 API 裏的工具,不是 claude.ai 網頁的聯網搜尋按鈕(後者見 /guides/claude-web-search)。基礎調用見 /guides/claude-api-python-quickstart,工具調用的通用機制見 /guides/claude-tool-use-basics。
結論先說
- 官方定義: 聯網搜尋工具讓 Claude 直接訪問實時網頁內容,回答裏帶有來自搜尋結果的引用。你在請求的
tools裏加一項,由 API 一側執行搜尋,不需要你自己寫搜尋代碼。 - 有三個版本:
web_search_20250305是基礎搜尋;web_search_20260209增加動態過濾;web_search_20260318再增加response_inclusion控制。 - 搜不搜由 Claude 判斷,官方說可以通過系統提示詞引導它更愛搜或更少搜;要硬性限制,用
max_uses。 - 域名過濾二選一:
allowed_domains和blocked_domains不能同時給,否則 API 返回 400。 - 計費: 搜尋用量在 token 費用之外另算,官方頁面寫的是每 1000 次搜尋 10 美元;出錯的搜尋不計費。具體以官方頁面當前顯示為準。
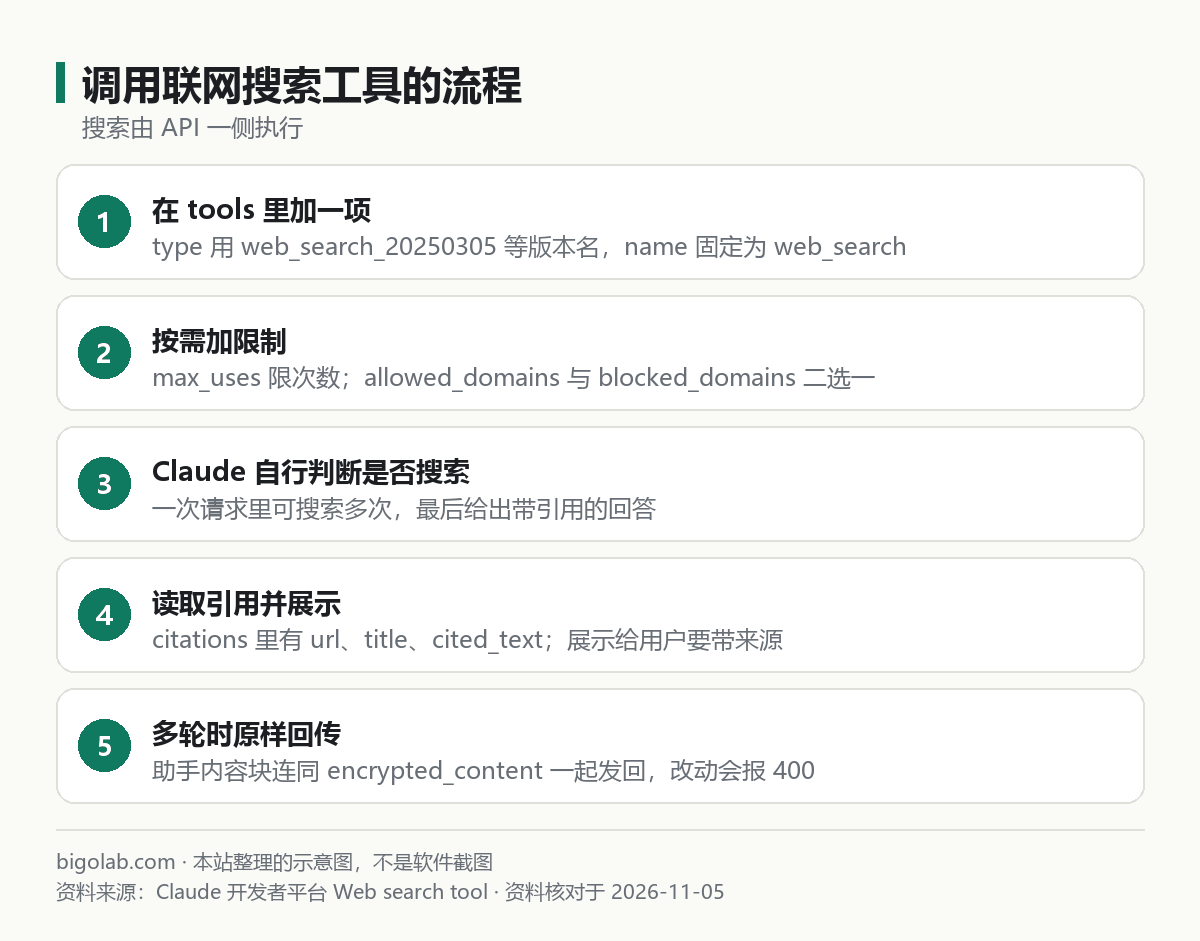
圖:本站根據 Claude 官方文檔:Web search tool 整理的示意圖
一、最小請求
官方 Python 示例的寫法(工具名固定為 web_search):
python
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "What's the weather in NYC?"}],
    tools=[{"type": "web_search_20250305", "name": "web_search", "max_uses": 5}],
)
print(response)
官方說明的運行過程:Claude 先根據提示詞決定是否搜尋;API 執行搜尋並把結果交給 Claude,這個過程在一次請求裏可以重複多次;最後 Claude 給出帶引用的回答。
官方列出會觸發搜尋的情形:近期事件和新聞、當前價格與比分、可能已變化的機構 / 人物 / 產品資訊,以及你明確要求搜尋。穩定的知識(數學、編程概念、創意寫作、已在對話裏的內容)會直接回答。
二、工具參數
官方的完整定義裏,除了 type 和 name,可選參數有:
json
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "allowed_domains": ["example.com", "trusteddomain.org"],
  "blocked_domains": ["untrustedsource.com"],
  "user_location": {
    "type": "approximate",
    "city": "San Francisco",
    "region": "California",
    "country": "US",
    "timezone": "America/Los_Angeles"
  }
}(allowed_domains 與 blocked_domains 同時出現會報錯,這裏只是把字段列全。)
max_uses: 限制每次請求的搜尋次數。超出時,對應的web_search_tool_result是一個帶max_uses_exceeded錯誤碼的錯誤。官方說簡單事實查詢通常用 1 到 3 次,比較類、多對象研究可能 10 次以上。- 域名過濾: 每項是不帶協議的裸域名,可以帶路徑,例如
example.com或example.com/blog。 user_location: 用於讓結果更貼近用戶所在地。type必須是approximate;city、region、country、timezone至少給一個;country是兩位 ISO 3166-1 國家代碼,不支持的代碼會被 API 拒絕(400);timezone是 IANA 時區名。allowed_callers: 控制 Claude 是直接調用搜索,還是通過代碼執行調用(動態過濾)。web_search_20260209及之後預設是["code_execution_20260120"],要直接調用就設成["direct"];官方說不支持程序化工具調用的模型必須這樣設,否則返回 400 並提示你設定。response_inclusion: 僅web_search_20260318及之後。設為"excluded"會把已被代碼執行消費完的搜尋結果塊從響應裏去掉,減少輸出 token;預設"full"。
動態過濾是什麼
官方的說法:基礎搜尋會把每條搜尋結果都放進上下文,其中很多可能不相關。用 web_search_20260209 或更新版本時,Claude 會先寫代碼過濾結果,只讓相關內容進入上下文,從而在搜尋密集的請求上少用 token。官方說這需要 Claude 4.6 及更新的模型;API 會自動提供所需的代碼執行,你不用另外加代碼執行工具,通過這種方式產生的代碼執行調用,除標準 token 費用外沒有額外收費。
三、返回裏有什麼
官方示例的響應是一串內容塊,按順序大致是:Claude 的說明文字、server_tool_use(搜尋詞)、web_search_tool_result(結果列表)、帶 citations 的文字回答。
搜尋結果每條包含 url、title、page_age 和 encrypted_content。
引用(web_search_result_location)包含 url、title、encrypted_index 和 cited_text(最多 150 個字符)。官方說明:聯網搜尋的引用總是開啟的;cited_text、title、url 三個字段不計入輸入或輸出 token。
多輪對話的關鍵: 想繼續帶搜尋結果的對話,必須把助手的內容塊原樣發回去,包括每條結果的 encrypted_content。缺少或被改動,請求會失敗並返回 400 校驗錯誤。
官方還提醒:把 API 輸出直接展示給終端用戶時,必須包含對原始來源的引用;如果你對輸出做了改寫或和自己的內容合併後再展示,應按需要展示引用,並向你們的法務諮詢。
四、錯誤和 pause_turn
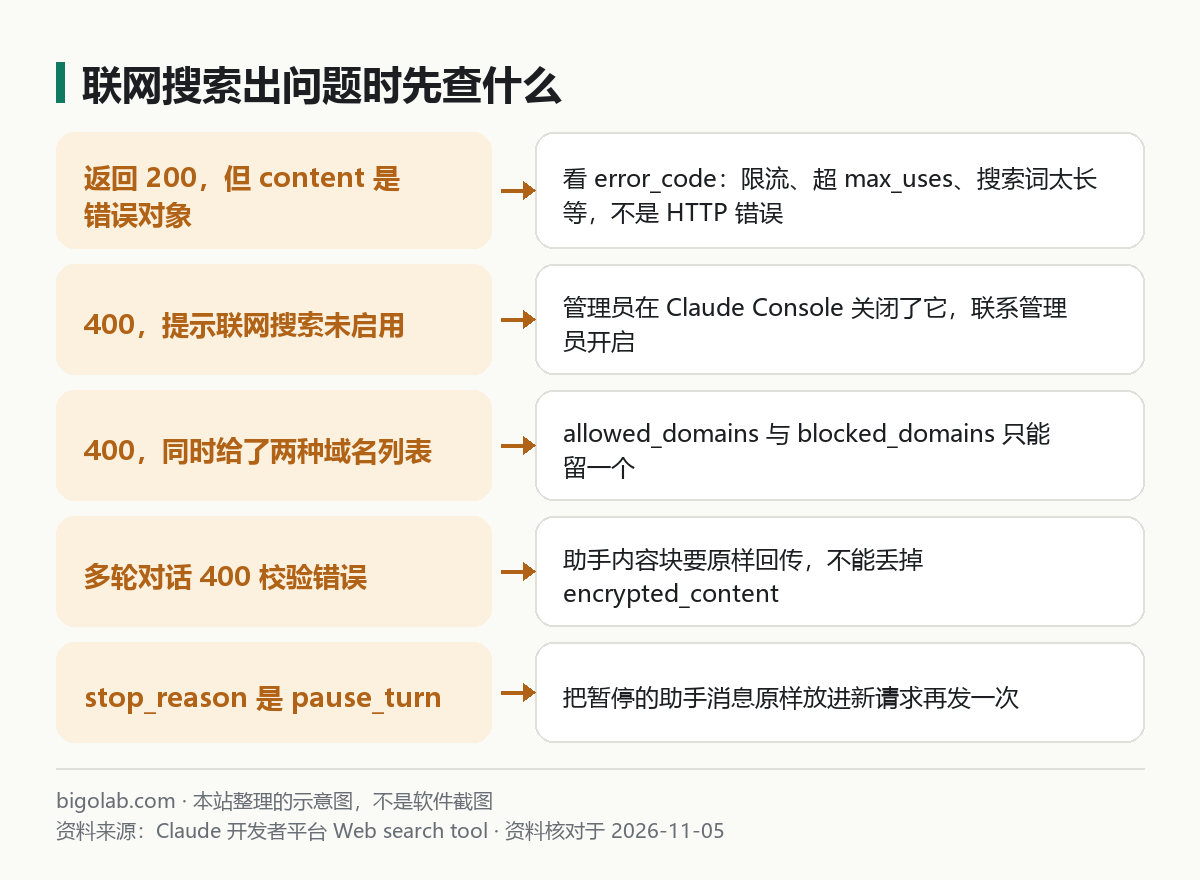
圖:本站根據官方文檔整理的示意圖
搜尋失敗不一定是 HTTP 錯誤。 官方說,搜尋工具遇到錯誤(比如觸發限流)時,Claude API 仍然返回 200,錯誤體現在響應體裏:content 是一個 web_search_tool_result_error 對象,而不是結果列表。如果搜尋成功但沒有匹配,是空的 content 列表,不算錯誤。錯誤碼包括:
too_many_requests:超出速率限制;invalid_tool_input:搜尋詞參數無效;max_uses_exceeded:超過搜尋次數上限;query_too_long:搜尋詞超長;request_too_large:請求太大,通常是域名過濾列表太長;unavailable:內部錯誤。
被禁用時: 官方說,聯網搜尋預設對你的組織開啟,除非管理員在 Claude Console 裏關閉了(管理員還可以在那裏限制可搜尋的域名)。關閉後,帶這個工具的請求會返回 400 invalid_request_error,提示聯網搜尋未啟用,而不是搜尋結果裏的錯誤碼。
pause_turn: API 可能暫停一個很長的搜尋回合,返回 stop_reason: "pause_turn"。繼續的辦法是把暫停的助手消息原樣放進新請求再發。如果 Claude 在同一組並行調用裏同時調用了聯網搜尋和你自己的客戶端工具,API 返回 stop_reason: "tool_use",且還沒有執行搜尋;你返回客戶端工具結果後,API 才在下一次請求裏執行搜尋。
429 本身的處理見 /guides/claude-api-error-429-rate-limit。
五、計費、緩存和批量
- 計費: 官方頁面寫:聯網搜尋在 Claude API 上是每 1000 次搜尋 10 美元,另加搜尋產生內容的標準 token 費用。一次搜尋算一次用量,不論返回多少條結果;出錯的搜尋不計費。整個對話中取回的搜尋結果會計為輸入 token。
- Prompt 緩存: 想在多輪之間緩存工具定義,見官方「Tool use with prompt caching」;站內的緩存基礎見 /guides/claude-prompt-caching。
- 批量: 聯網搜尋可以放進 Messages Batches API,價格與普通請求相同。官方提醒:為保護共享容量,批量接口會對每個組織的聯網搜尋限流,大批量帶很多搜尋的任務可能更慢。
- 流式: 開啟流式後會收到搜尋事件,搜尋進行時流會有停頓。
常見問題
Q:所有模型都能用嗎?
官方頁面的「Availability」寫的是聯網搜尋工具在每個模型上可用,並符合零數據保留和 HIPAA 就緒的條件;但動態過濾需要較新的模型。想在發請求前確認,官方建議讀 Models API 裏 capabilities.server_tools.web_search.supported 的值。
Q:Bedrock、Vertex 上能用嗎?
官方頁面列出了不同平台的可用性,並註明部分平台只支持基礎版(web_search_20250305,不帶動態過濾)。具體平台和版本請直接看官方「Availability」一節,本文不轉述。
Q:我只想讓它讀某個具體網址的內容?
官方「Next steps」裏列了另一個工具用於抓取指定網址的內容,本文沒有覆蓋,請看官方文檔。
相關教學
- /guides/claude-tool-use-basics:工具調用的基本機制
- /guides/claude-api-python-quickstart:Python 快速上手
- /guides/claude-api-key-console:API Key 與 Console
參考資料
- Claude 開發者平台文檔:Web search tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/web-search-tool
0 條評論
還沒有評論,來搶沙發~