
結論先說
- 新版官方首選方案是在節點函數內部調用
interrupt(待審數據),配合Command(resume=人工結果)恢復運行,比早期靜態寫死interrupt_before靈活得多。 - 暫停期間不佔後台算力:一旦撞上
interrupt(),進程直接儲存狀態並正常返回響應;哪怕主管三天後才在網頁點同意,只要帶上原thread_id就能原地喚醒。 - 少了這兩樣必定報錯:編譯圖時必須傳
checkpointer(儲存器),且每次調用必須傳config={"configurable": {"thread_id": "..."}}。 - 最重要的一條底層鐵律:恢復時被暫停的節點會從該函數的第一行重新執行(只是這次遇到
interrupt()不再停住,而是直接吐出人工傳入的resume值)——所以發請求、扣款等副作用代碼絕不能寫在同一個節點裏interrupt()的上方。
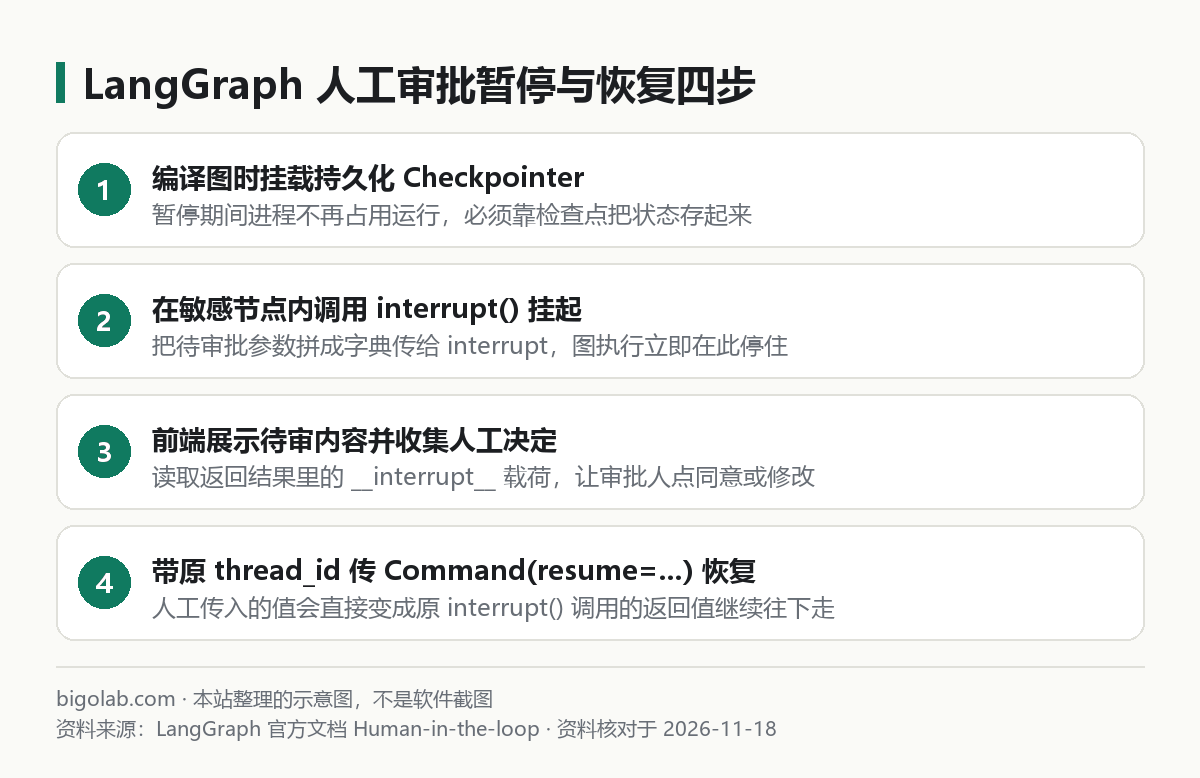
圖:本站根據 LangGraph 官方文檔 Human-in-the-loop 整理的示意圖
本文根據 LangChain / LangGraph 官方文檔《Human-in-the-loop》《Interrupts》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 LangChain 官方網站。
適用於誰
- 搜「langgraph human in the loop」「langgraph interrupt 用法」「langgraph 人工審批」的開發者;
- 智能體已經能調寫庫、發電郵或退款工具了,但上線前安全團隊要求「凡是寫操作必須先暫停給主管點確認按鈕,同意後才能真執行」的後端工程師;
- 照着文檔寫了
interrupt(),恢復時卻發現節點上半截的邏輯又重複跑了一遍、正在查原因的人。
如果你是第一次接觸狀態圖,建議先花五分鐘讀完 /guides/langgraph-quickstart-install-first-graph;為什麼這類跨天審批場景適合用圖編排,也可回顧 /guides/claude-agent-sdk-vs-langchain-how-to-choose。
一、完整可運行示例:高危操作執行前暫停等人工確認
下面的純 Python 腳本模擬了一個「執行工單補償發放」節點:當補償積分超過免審線時,調用 interrupt() 把待審詳情拋給外部調用方;等拿到人類返回的 "approve" 或修改後的數值後,再真正落庫完成。
python
from typing import TypedDict
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END
from langgraph.types import interrupt, Command

class TicketState(TypedDict):
    user_id: str
    points: int
    status: str

def issue_compensation_node(state: TicketState):
    pts = state["points"]
    # 超過 500 積分時觸發動態人工掛起,把待審摘要拋出去
    if pts > 500:
        decision = interrupt({
            "question": "積分補償超免審線,請確認是否批准或修改額度",
            "user_id": state["user_id"],
            "proposed_points": pts,
        })
        if not decision.get("approved"):
            return {"status": "人工已駁回該筆發放"}
        # 允許審批人順手改小發放數值後再放行
        pts = decision.get("final_points", pts)

    # 注意:真正落庫發積分的寫操作必須放在 interrupt 之後
    return {
        "points": pts,
        "status": f"已向用戶 {state['user_id']} 成功發放 {pts} 積分",
    }

builder = StateGraph(TicketState)
builder.add_node("issue_compensation", issue_compensation_node)
builder.add_edge(START, "issue_compensation")
builder.add_edge("issue_compensation", END)

# 必須掛載檢查點儲存器(生產環境換成 PostgresSaver)
graph = builder.compile(checkpointer=InMemorySaver())

if __name__ == "__main__":
    cfg = {"configurable": {"thread_id": "ticket-9001"}}

    # 第一次調用:跑到 interrupt 處自動停住並返回 __interrupt__ 提示
    first_out = graph.invoke(
        {"user_id": "U_88", "points": 1200, "status": "pending"},
        config=cfg,
    )
    print("首次返回(已掛起):", first_out["__interrupt__"])

    # 模擬後台主管審批同意並將額度調整為 800 後恢復同一個 thread_id
    final_out = graph.invoke(
        Command(resume={"approved": True, "final_points": 800}),
        config=cfg,
    )
    print("恢復後最終結果:", final_out["status"])
運行這段代碼,你會看到第一次 invoke 並沒有執行下方的發放邏輯,而是返回了一個包含 __interrupt__ 列表的字典——你的前端頁面只需讀取裏面的 question 和 proposed_points 渲染成審批彈窗;等主管點擊按鈕後,後端接口調用第二次 graph.invoke(Command(resume=...), config=cfg) 即可跑完剩餘流程。
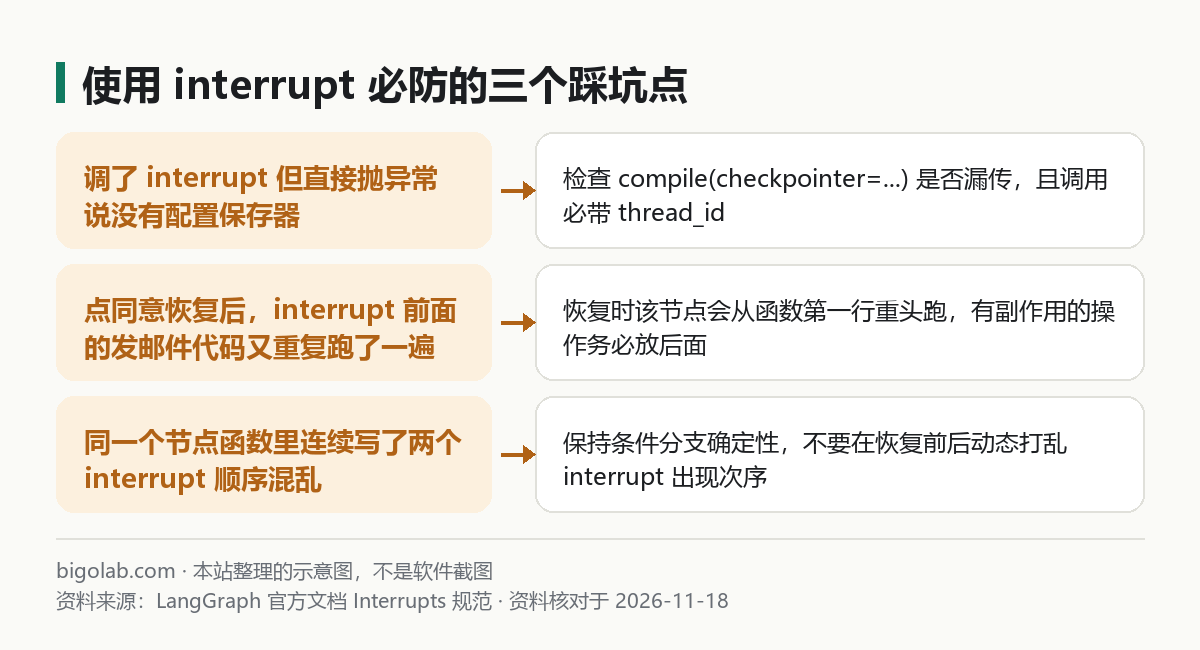
圖:本站根據 LangGraph 官方文檔 Interrupts 規範 整理的示意圖
二、生產環境寫 interrupt 必守的三條工程紀律
- 把耗時大模型調用拆到前一個獨立節點:因為恢復時當前節點會從頭重跑一遍,如果你把「調大模型想方案」和「
interrupt()等人工點同意」塞在同一個函數里,點同意恢復時那次大模型調用又會被白跑一次浪費額度。正確拆法是:節點 A 調大模型生成待審參數寫入State→ 節點 B 專職調interrupt()拿審批結果並執行工具; - 生產庫務必替換掉
InMemorySaver:人工審批往往間隔幾十分鐘甚至跨天,內存儲存器遇到服務發版重啟就會丟掉掛起線程,上線前請換成 PostgreSQL 等持久化儲存器; - 配合遠程 MCP 高危寫工具一起用:當你通過適配器掛載了外部業務系統的增刪改 MCP 工具(見 /guides/langgraph-mcp-integration-guide)時,不要把刪除或群發工具裸露在全自動
ToolNode裏,給高危工具外包一層帶interrupt()的人工確認殼最穩妥。開發期想直觀模擬斷點恢復,也可以直接在本地 Studio 畫布裏點按鈕測試(見 /guides/langgraph-debug-visualize-studio-guide)。
平時研發團隊藉助 Claude 或 ChatGPT 梳理複雜審批狀態轉移邊界與編寫異步回調接口時,個人官方訂閱說明也可參考 /chongzhi/claude-pro。
常見問題
Q:如果用戶掛起後一直不點審批,怎麼查詢這個 thread_id 當前是不是正卡在等待人工狀態?
隨時調用 state_snapshot = graph.get_state(cfg) 檢查返回的快照對象:如果裏面的 tasks 包含未處理的 interrupts(或 next 非空),就說明該會話當前正停在人工斷點處,前端刷新頁面時靠這個接口就能重新渲染出剛才的待辦卡片。
Q:舊項目裏用的 compile(interrupt_before=["tools"]) 還能繼續用嗎?
依然兼容保留。如果你的需求非常簡單——只要每次進工具節點前無腦一刀切停住,靜態 interrupt_before 寫起來很省事;但只要你需要「小額免審、大額才停」這類按業務字段動態判斷是否掛起的邏輯,函數內的 interrupt() 清晰得多。
相關教學
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安裝與第一個狀態圖
- /guides/langgraph-debug-visualize-studio-guide:在 LangGraph Studio 畫布裏可視化測試斷點
- /guides/langgraph-mcp-integration-guide:LangGraph 接入 MCP 工具與寫操作防護
- /guides/claude-agent-sdk-vs-langchain-how-to-choose:為什麼強審批工作流適合選 LangGraph
參考資料
- LangChain / LangGraph 官方文檔:Human-in-the-loop & Interrupts — https://docs.langchain.com/
langchain-ai/langgraph官方 GitHub 倉庫 — https://github.com/langchain-ai/langgraph
0 條評論
還沒有評論,來搶沙發~