
結論先說
- 先分清「記筆記(Memory)」和「連續聊天(Multi-turn Chat)」:
Crew(memory=True)解決的是讓團隊自動檢索過往片段與實體特徵;而像聊天機器人一樣一問一答維護歷史消息列表,靠的是 CrewAI Flows(狀態流)加@persist持久化。 - 一行
memory=True會同時激活三層存儲:基於本地向量庫(ChromaDB)的短期記憶與實體記憶,加上基於本地 SQLite 的跨次長期經驗記憶。 - 非 OpenAI 用戶必看避坑點:CrewAI 的向量記憶預設使用 OpenAI 的嵌入接口算向量;如果你主模型用的是 Anthropic 或本地 Ollama,必須顯式配置
embedder字段,否則一開記憶就會報缺密鑰。 - 單次任務中途只需人工拍板一句話時,不用搭多輪聊天架構,直接在對應
Task上設human_input=True即可暫停等你在終端補充意見。
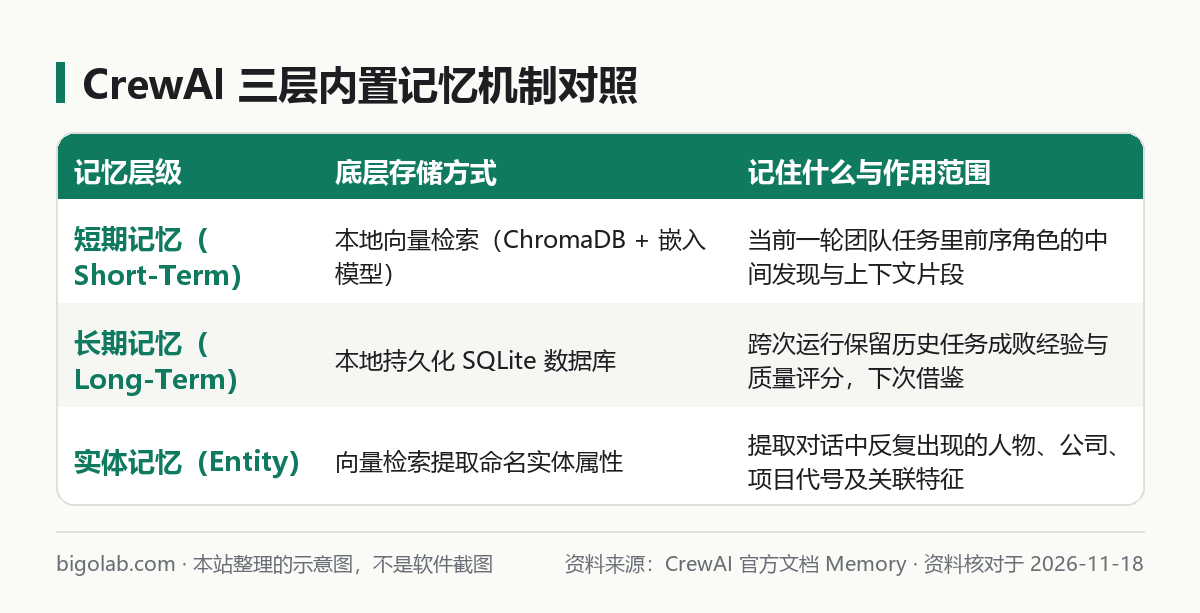
圖:本站根據 CrewAI 官方文檔 Memory 整理的示意圖
本文根據 CrewAI 官方文檔《Memory》《Flows》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 CrewAI 官方網站。
適用於誰
- 搜「crewai 多 輪 對話」「crewai memory 怎麼配置」的人;
- 已經跑通了單次
crew.kickoff()批處理任務(基礎寫法見 /guides/crewai-quickstart-roles-tasks-processes),想把它改造成能記住上一輪上下文、跟用戶反覆追問的對話式應用的開發者; - 加上
memory=True後突然報OPENAI_API_KEY缺失錯誤(明明主模型配的是 Claude 或本地 Ollama),正在查原因的人。
一、memory=True 背後自動開啟了哪三層記憶
在預設不傳參數的 Crew 裏,每次運行 kickoff() 都是從零開始。當你把開關打開後,框架會在本機自動建起三套互補的記憶庫:
- 短期記憶(Short-Term Memory):基於向量相似度檢索,讓排在後面的角色能按相關性召回當前這一輪協作中前序角色查到的關鍵上下文,而不必硬塞全部原始文本;
- 長期記憶(Long-Term Memory):存入本機 SQLite 數據庫,記錄每次任務跑完後的自我評估與經驗教訓。下次再跑同類任務時,角色會先參考上次哪裏做得好、哪裏踩了坑;
- 實體記憶(Entity Memory):專門提取並追蹤對話裏反覆出現的具體名詞(客戶名、產品代號、技術組件名)及其屬性關係。
自定義 embedder(不用 OpenAI 密鑰也能開記憶)
因為短期記憶和實體記憶底層要算文本向量,當你的主力模型是 Claude 或本機 Ollama 時,請在 Crew 裏一併指定 embedder,避免預設去找 OpenAI 接口報錯:
python
from crewai import Crew, Process

my_crew = Crew(
    agents=[analyst, writer],
    tasks=[research_task, write_task],
    process=Process.sequential,
    memory=True,
    embedder={
        "provider": "ollama",
        "config": {
            "model": "nomic-embed-text",
            "url": "http://127.0.0.1:11434/api/embeddings",
        },
    },
)
如果你想清空某次測試污染的舊記憶,可以直接在命令行運行 crewai reset-memories --all 按類型重置本地數據庫。
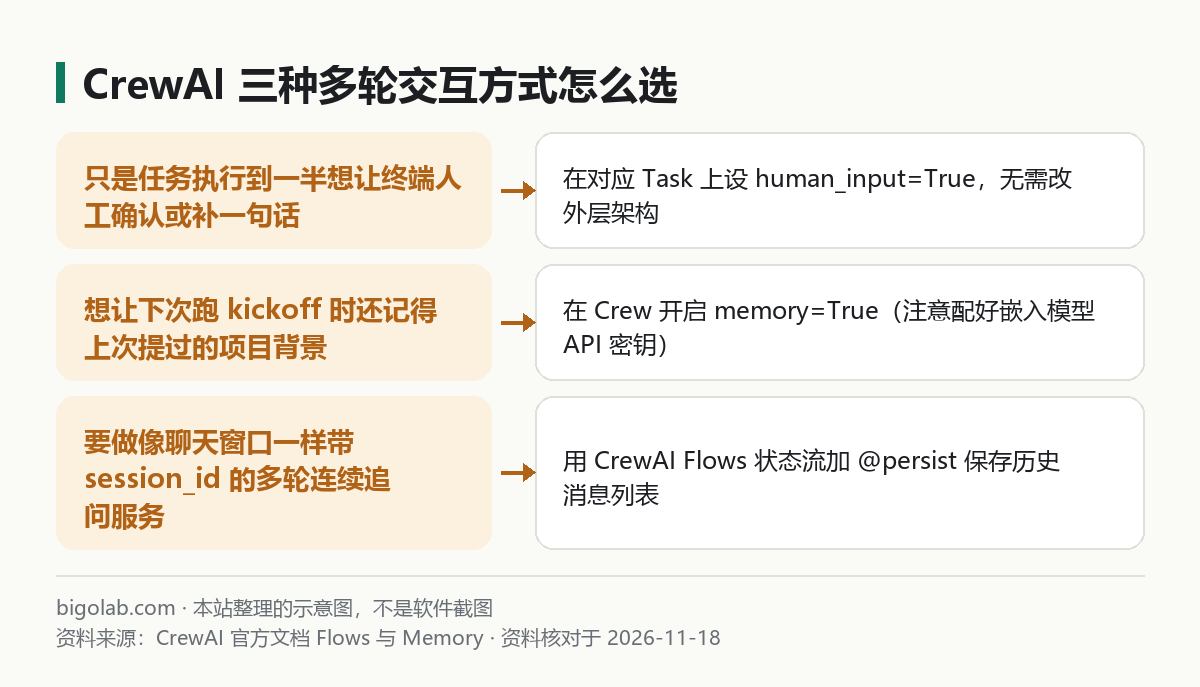
圖:本站根據 CrewAI 官方文檔 Flows 與 Memory 整理的示意圖
二、真正的多輪對話怎麼做:用 Flows 狀態流管歷史記錄
很多新手試圖在一個 while True: 循環裏死磕同一個批處理 Crew,每次只塞最新一句用戶輸入,結果發現團隊根本接不上話。原因很簡單:Crew 天生是為「給定目標 → 多角色協作交付一份產物」設計的批處理單元。
要做帶會話 ID 的多輪連續對話,官方推薦在 CrewAI Flows 裏維護結構化狀態(包含 history 消息列表),並在需要深度協作的回合按需調起底層的 Crew,或者配合 @persist() 裝飾器自動按狀態 ID 落盤恢復:
python
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class ChatState(BaseModel):
    history: list[dict] = []
    latest_user_msg: str = ""

@persist()  # 自動將每次執行後的 ChatState 持久化到預設 SQLite 存儲
class SupportChatFlow(Flow[ChatState]):

    @start()
    def handle_turn(self):
        # 1. 追加本輪用戶提問到持久化的對話歷史
        self.state.history.append({"role": "user", "content": self.state.latest_user_msg})

        # 2. 將最近幾輪精簡上下文格式化後傳入你的專職 Crew(避免無限堆疊)
        recent_context = "\n".join(
            f"{m['role']}: {m['content']}" for m in self.state.history[-6:]
        )
        crew_output = support_crew.kickoff(inputs={
            "chat_history": recent_context,
            "question": self.state.latest_user_msg,
        })

        reply = crew_output.raw
        self.state.history.append({"role": "assistant", "content": reply})
        return reply

# 同一個 id 跨多次請求自動恢復上一輪儲存的 history
flow = SupportChatFlow()
ans1 = flow.kickoff(inputs={"id": "session-1001", "latest_user_msg": "我們後端用的是 PostgreSQL 16"})
ans2 = flow.kickoff(inputs={"id": "session-1001", "latest_user_msg": "針對剛才說的數據庫版本,升級連接池要注意什麼?"})
注意代碼裏的一個小細節:我們只截取了 history[-6:] 餵給下一輪 kickoff,同時配合 memory=True 召回更早的關鍵實體——既實現了連貫追問,又防止幾十輪長聊把每個 Agent 的輸入 Token 翻倍撐爆(控費邏輯見 /guides/multi-agent-token-cost-why-high-how-to-control)。
三、和 LangGraph 的多輪記憶對比怎麼選
對比我們在 /guides/langgraph-quickstart-install-first-graph 裏寫過的 MessagesState + Checkpointer 可以看出:如果你的核心產品形態從第一天起就是一個高並發、隨時中途打斷轉向的多輪對話機器人(編排差異見 /guides/multi-agent-orchestration-patterns),LangGraph 原生以消息流為中心的檢查點機制更直接;而如果你的核心是「對話收集完需求後,觸發後台三四個專家角色合寫一份深度方案」,用 CrewAI 的 Flows + Crew 組合寫起來更省心。日常藉助網頁端 ChatGPT 或 Claude 調試複雜多輪提示詞模板時,個人官方訂閱渠道可參考 /chongzhi/chatgpt-plus。
常見問題
Q:本地存儲的記憶文件預設放在電腦什麼位置?部署多實例容器會丟嗎?
CrewAI 預設把 ChromaDB 與 SQLite 記憶文件存在操作系統的用戶應用數據目錄下(可通過設定環境變量 CREWAI_STORAGE_DIR 改到指定掛載卷)。容器化部署時務必把該目錄掛載到持久化存儲卷,或接入外部託管記憶後端,否則容器重建後長期記憶會清空。
Q:只想要角色在交付最終稿前問我一句「還需不需要補充」,怎麼開最簡單?
不用寫 Flow,直接在最後一個把關 Task 裏加上 human_input=True。任務跑完初稿後會在控制檯停住等待你的鍵盤輸入:你敲回車確認滿意即結束,如果輸入修改意見,當前 Agent 就會結合你的反饋重改一版再交付。
相關教學
- /guides/crewai-quickstart-roles-tasks-processes:CrewAI 角色、任務與順序/層級流程快速入門
- /guides/langgraph-quickstart-install-first-graph:LangGraph 狀態圖與
InMemorySaver多輪記憶對比 - /guides/multi-agent-orchestration-patterns:多 Agent 四大編排模式與交接邏輯
- /guides/multi-agent-token-cost-why-high-how-to-control:多輪多代理系統的上下文裁剪與控費
參考資料
- CrewAI 官方文檔:Memory 與 Flows — https://docs.crewai.com/
crewAIInc/crewAI官方開源倉庫 — https://github.com/crewAIInc/crewAI
0 條評論
還沒有評論,來搶沙發~