
結論先說
- 多智能體(Multi-Agent)的本質是「拆分上下文窗口與職責邊界」:不再讓同一個會話把所有搜尋、執行、核驗硬扛到底,而是讓多個擁有獨立系統提示詞、獨立工具集和獨立上下文窗口的智能體分工協作。
- 兩家官方給出的第一原則完全一致:先從最簡單的方案起步。 能用單次調用或固定代碼工作流(Workflow)解決的,不要上自主智能體;能用單智能體解決的,不要拆多智能體。
- 真正值得上多智能體的只有三類信號:廣度並行調研超出單窗口承載力、工具太多太雜導致單智能體頻繁選錯工具、複雜條件分支讓單份系統提示詞互相打架。
- 多智能體是用算力換上限,Token 消耗會大幅增加:Anthropic 工程團隊公開統計,單智能體消耗約為普通聊天的 4 倍,而多智能體系統可達到普通聊天的約 15 倍。
- 強耦合讀寫同一份狀態的任務不適合拆多智能體——比如多個人同時改同一個代碼文件,拆分後的協調衝突往往大於並行收益。
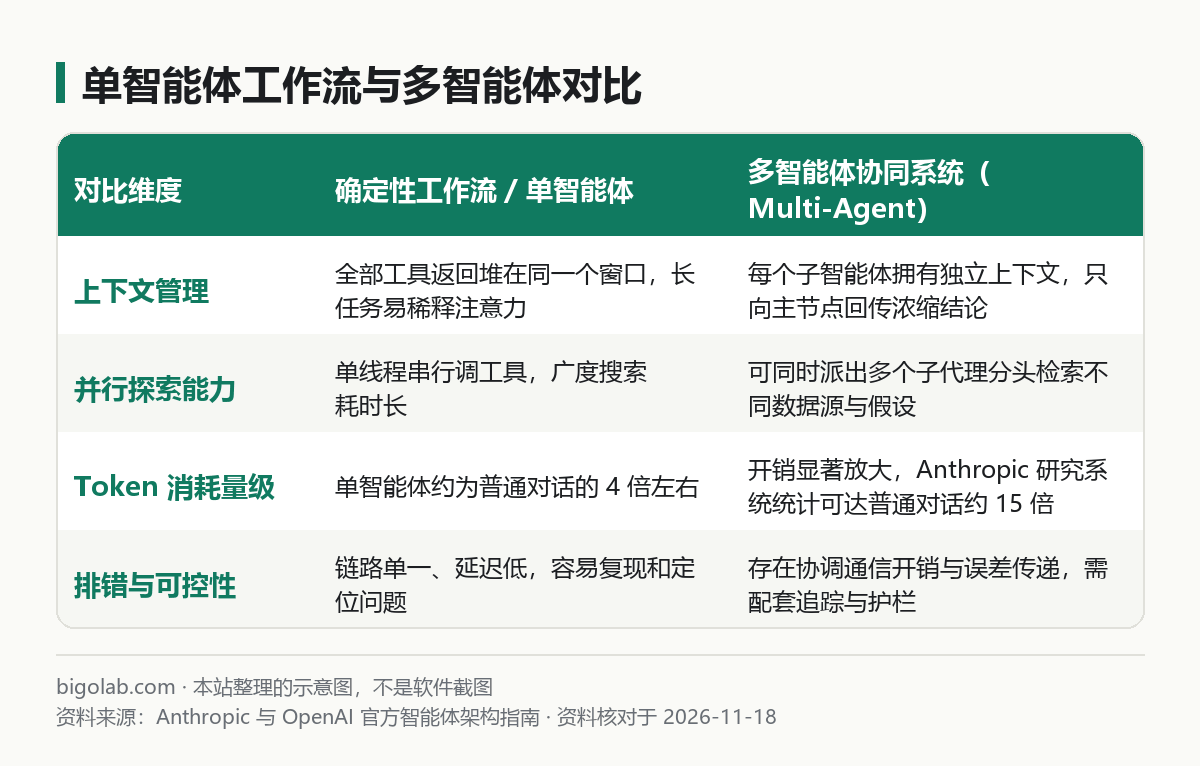
圖:本站根據 Anthropic 與 OpenAI 官方智能體架構指南 整理的示意圖
本文根據 Anthropic 官方工程文章《How we built our multi-agent research system》《Building effective agents》與 OpenAI 官方指南《A practical guide to building agents》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方網站。
適用於誰
- 搜「多智能體協同框架」「多智能體是什麼」「什麼時候需要 multi-agent」的人;
- 準備搭建 AI 應用或自動化工作流,糾結「一個大模型配十幾個工具」還是「拆成三四個專職 Agent 協作」的開發者與產品經理;
- 跟風搭了多代理流水線,結果發現響應慢、報錯難排查、Token 帳單翻了好幾倍的人。
一、先分清三個層次:工作流、單智能體、多智能體
很多團隊一上來就找「多智能體協同框架」,其實把三個不同複雜度的概念混在了一起。按 Anthropic 在《Building effective agents》裏的界定:
- 確定性工作流(Workflows):大模型和工具按開發者事先寫好的代碼路徑一步步走(例如先提綱、再分段生成、最後格式校驗)。鏈路固定、最穩、最省錢;
- 單智能體(Single Agent):一個模型在循環裏自己決定下一步調哪個工具、根據環境反饋自己修正,直到完成目標;
- 多智能體系統(Multi-Agent System):把工作拆給多個獨立運行的智能體實例,通過「中心主管調度」或「對等交接」配合完成單窗口裝不下的大任務。
OpenAI 在《A practical guide to building agents》裏同樣建議:絕大多數業務場景應該先把單個智能體跑通並壓榨到極限(通過加工具、優化指令),只有撞上明顯瓶頸時再拆分。
二、什麼時候才真正該用多智能體
綜合 Anthropic 和 OpenAI 兩份指南,出現下面三個具體痛點之一時,升級多智能體才有正向收益:
1. 需要廣度優先的並行探索與「上下文壓縮」
這是 Anthropic 構建 Claude Research 多智能體系統的核心原因。面對開放式深度調研,事先根本不知道答案藏在哪幾個方向;如果讓單個智能體串行搜幾十個網頁,前面塞進來的海量無關正文會迅速污染上下文,導致模型遺忘最初目標。
換成主從多智能體後,主節點(例如 Opus)負責拆解調查方向,同時派出多個子智能體(例如 Sonnet)在各自乾淨的上下文窗口裏翻資料,最後每個子智能體只把幾百字的提煉結論遞迴主節點。在這類重度並行壓縮資訊噪聲的場景下,Anthropic 內部評測顯示多智能體顯著優於單智能體。
2. 工具數量膨脹且參數相似,單智能體頻繁調錯
OpenAI 官方指南給出了一個非常實用的拆分閾值:當你往同一個智能體裏塞了十幾個甚至幾十個工具,尤其是存在多個名稱相近、參數重疊的工具(比如同時掛了五套不同業務線的查詢接口)時,單靠改寫提示詞已經很難阻止模型調錯。把工具按業務域拆給不同的專職智能體,每個智能體只看自己那三五個工具,準確率會穩得多。
3. 指令邏輯裏充滿複雜的 if-else 分支與角色切換
如果一份系統提示詞既要求模型「熱情引導售前諮詢」,又要求「嚴格核驗退費風控條款」,還要求「生成排查腳本」,篇幅超過上千字且語氣規則互相牽制,拆成獨立節點按階段交接會清晰很多。
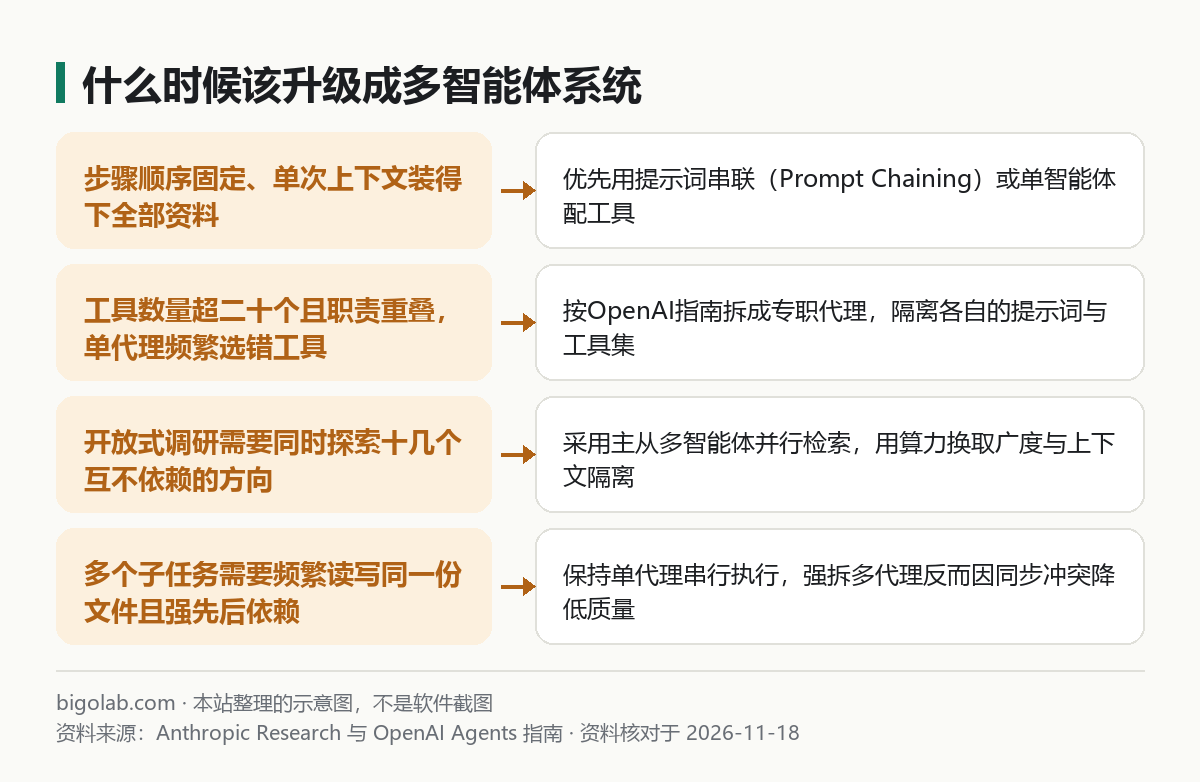
圖:本站根據 Anthropic Research 與 OpenAI Agents 指南 整理的示意圖
三、哪些場景千萬別硬拆多智能體
Anthropic 團隊在覆盤多智能體研發踩坑時專門指出了典型的反面場景:子任務之間存在緊密共享狀態和強先後依賴——最具代表性的就是常規寫代碼。
如果讓三個沒有共享實時上下文的子智能體分頭改同一個模組的不同部分,它們各自的假設很容易對不上,最後拼在一起到處是接口不匹配和合並衝突。因此在編碼工具裏(如 Claude Code 子代理或 Codex 子代理,見 /guides/claude-code-subagents 與 /guides/codex-multi-agent-subagents-guide),穩妥的拆法都是「並行只讀探索與獨立驗證、串行集中改寫」,而不是讓一群代理同時改同一份源碼。
四、動手搭建前的兩項基礎準備
確定業務真的需要多智能體後,落地前先定好兩件事:
- 選對官方 SDK 原語:偏代碼與終端工具鏈自主循環可看 /guides/claude-agent-sdk-quickstart;偏客服分流、主管調度與護欄追蹤可看 /guides/openai-agents-sdk-handoffs-vs-agents-as-tools;
- 先算清楚額度帳:多智能體每次並發都會成倍消耗配額。無論是在本地跑編碼多代理還是調試重度研究工作流,高頻使用者如果遇到基礎套餐限額瓶頸,可對照 /chongzhi/claude-max 或 /chongzhi/chatgpt-pro 提前了解高額度套餐與 API 計費的差異。
常見問題
Q:提示詞寫兩個角色「讓模型自己在一條回覆裏扮演甲和乙吵架」,算多智能體嗎?
不算。那只是單次上下文裏的角色扮演提示詞技巧,既沒有隔離上下文窗口,也沒有分拆工具集或實現真正並發,解決不了長上下文污染和工具過多的問題。
Q:多智能體一定每個節點都得用最強模型嗎?
不需要,官方推薦「主強從輕」:負責拆解全局方案與最終彙總的主節點用強推理模型,負責分頭檢索、提取字段的工作節點用高性價比主力或輕量模型。
Q:初學者應該直接學重型多智能體框架,還是先寫原生調用?
Anthropic 在指南里明確建議先直接調基礎接口或輕量 SDK 把最小閉環跑通,看清提示詞與工具交互的真實報文;等確認需要複雜持久化圖狀態或可視化編排時,再引入專門的編排框架,排錯成本最低。
相關教學
- /guides/claude-agent-sdk-quickstart:Claude Agent SDK 入門與第一個智能體
- /guides/openai-agents-sdk-handoffs-vs-agents-as-tools:OpenAI Agents SDK 多代理分工實戰
- /guides/claude-code-subagents:Claude Code 子代理創建與使用
- /guides/codex-multi-agent-subagents-guide:Codex 多 Agent 與子代理配置詳解
參考資料
- Anthropic Engineering:How we built our multi-agent research system — https://www.anthropic.com/engineering/multi-agent-research-system
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI:A practical guide to building agents — https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
0 條評論
還沒有評論,來搶沙發~