
結論先說
- 當前版本的 Codex 預設已開啟多代理(Subagents)功能(
agents.enabled預設為true),支持同時拉起多個專職子代理並行幹活,再由主線程彙總結果。 - 核心價值是防「上下文污染(Context pollution)」:把翻代碼、跑單測、讀長堆棧這類吵鬧的中間過程剝離到子線程,只把精煉結論傳回主對話。
- 內置三種角色:
explorer(偏只讀搜尋)、worker(偏動手實現與修復)、default(通用兜底);還可在~/.codex/agents/或項目.codex/agents/下寫獨立.toml文件定義專屬角色。 - 怎麼觸發與查看:在提示詞裏直接寫明並行拆分要求(或開啟 Ultra 推理檔讓系統主動委派);CLI 裏輸
/subagents隨時查看和切換活動線程。 - 沙箱與審批嚴格繼承父會話:自定義子代理可以單獨換模型或關掉 Shell 工具,但不能繞開父會話當前的沙箱和審批策略。
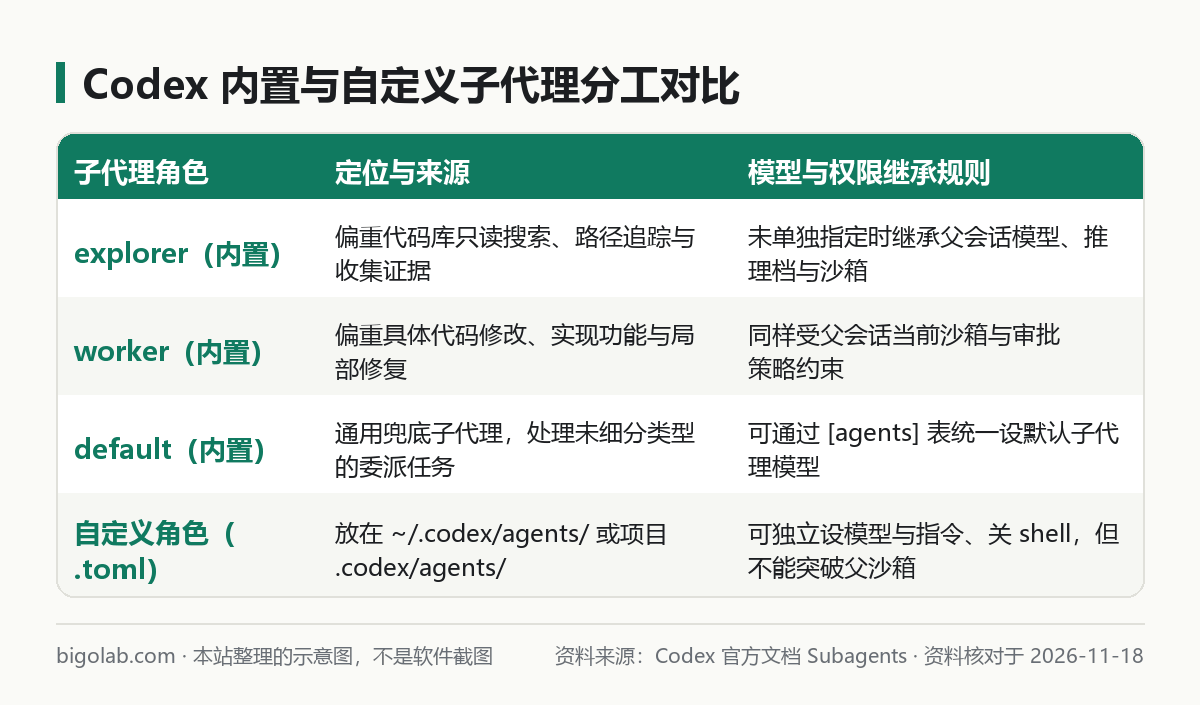
圖:本站根據 Codex 官方文檔:Subagents 整理的示意圖
本文根據 Codex 官方文檔《Subagents》《Sample Configuration》《Slash commands in Codex CLI》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。Claude Code 的同類機制可對比 Claude Code Subagents(子代理)怎麼用。
適用於誰
- 在大倉庫裏讓單個會話既搜代碼、又看幾千行測試日誌、又改邏輯,結果聊到後面主線上下文越來越糊塗的人;
- 想讓 Codex 同時派出三個子代理分別查安全漏洞、缺測分支和可維護性,最後彙總成一份報告的人;
- 想給掃描探索子代理單獨配便宜快速的
gpt-6-luna,而主代理保持強模型的開發者。
一、怎麼觸發子代理並行工作、在哪看進度
官方文檔建議:讀多寫少的任務(如代碼庫探索、PR 多維度審查、故障分流、長文檔分塊摘要)最適合上並行子代理;而多個代理同時改同一批文件的「寫密集」任務容易產生代碼衝突,要謹慎拆分。
觸發方式有兩種:
- 常規檔位顯式點名:直接在提示詞(或倉庫
AGENTS.md、技能文件)裏交代清楚「拆幾個子代理、各自查什麼、要不要等齊再彙總」。例如官方推薦的分支審查寫法:
text
請用並行子代理審查當前分支:派一個子代理查安全風險,一個查測試缺口,一個查代碼可維護性。等三個全部完成後,按類別彙總問題並附上文件路徑與行號。- Ultra 檔位主動委派:在支持 Ultra 檔位的帳號與模型上,無需每次手寫拆分指令,系統判斷並行能明顯提速或提質時會自動派發子代理。
運行過程中各端查看入口不同:
- 命令行 CLI:輸入
/subagents回車,即可在活動線程選擇器裏切換查看某個子代理正在幹什麼;如果某個後台子線程觸發了命令審批彈窗,遮罩層會標明來源線程名,按鍵盤o鍵就能先打開那個子線程看清上下文再決定放行或拒絕。 - 桌面端與 IDE 擴展:桌面端直接在主對話活動流裏點開對應子代理線程;IDE 擴展在輸入框上方展開後台代理面板查看狀態或停止子代理。
二、配置全局並發上限與自定義 .toml 角色
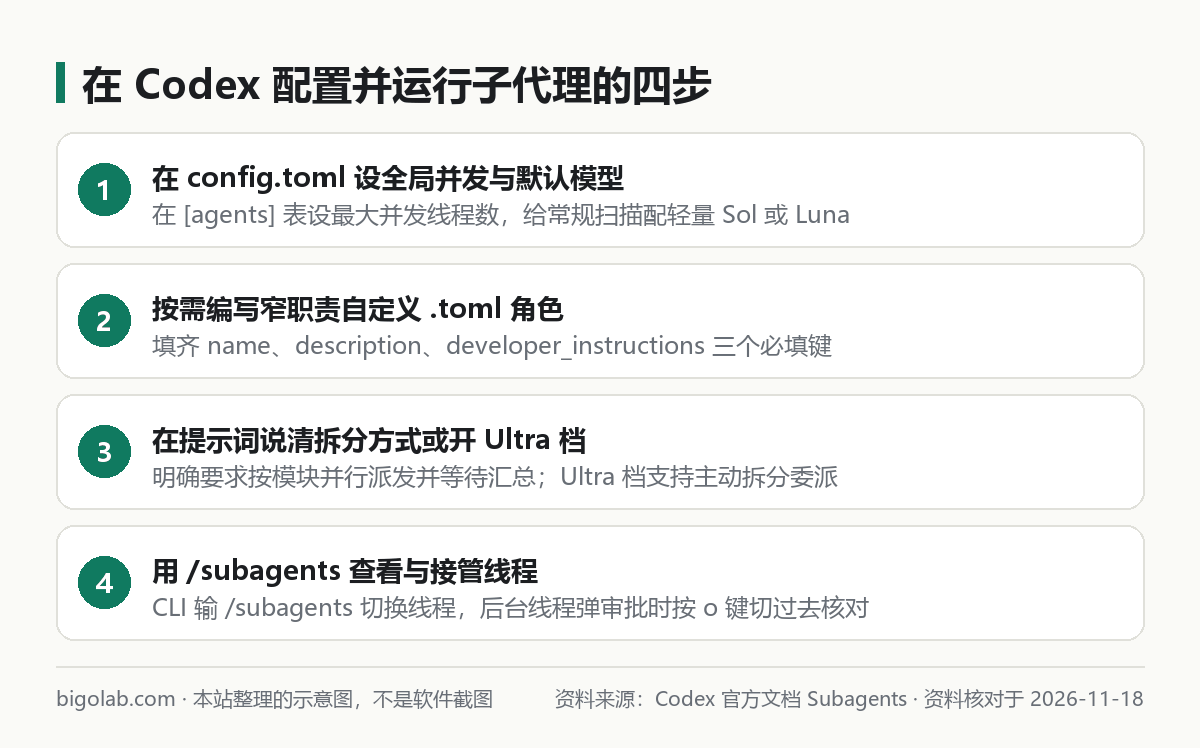
圖:本站根據 Codex 官方文檔:Subagents 整理的示意圖
1. 在 config.toml 的 [agents] 表設全局預設值
不想讓所有子代理都跟着父會話用最貴的模型,可以在 ~/.codex/config.toml 或受信任項目的 .codex/config.toml 裏配置 [agents] 表(配置優先級見 Codex config.toml 完整詳解,模型差異見 Codex 用哪個模型好):
toml
[agents]
enabled = true
max_concurrent_threads_per_session = 6        # 除主線程外的最大並發子線程數
default_subagent_model = "gpt-6.2-sol"        # 子代理預設模型
default_subagent_reasoning_effort = "medium"  # 子代理預設推理強度
2. 在 .codex/agents/ 新建專屬角色文件
個人通用角色放 ~/.codex/agents/,項目共享角色放倉庫 .codex/agents/。每個 .toml 文件定義一個角色,必填 name、description、developer_instructions 三個字段。例如按官方範例寫一個只讀搜尋員 .codex/agents/pr-explorer.toml:
toml
name = "pr_explorer"
description = "只讀代碼庫探索員,在提出修改方案前負責收集調用鏈與文件證據。"
model = "gpt-6-luna"
model_reasoning_effort = "high"
developer_instructions = """
保持只讀探索模式,不要修改任何文件。
追蹤真實執行路徑,準確引用文件路徑與函數符號;除非父代理明確要求,否則不要自行編寫修復代碼。
"""

[features]
shell_tool = false
上面這個例子用了兩個官方省錢又防亂改的技巧:把高頻翻文件的探索員指定為輕量快速的 gpt-6-luna(配 high 推理),同時用 features.shell_tool = false 關掉它的 Shell 執行能力,只讓它安心讀代碼。
三、權限邊界與套餐額度消耗說明
- 安全邊界不可越權:官方明確規定,寫在自定義代理
.toml裏的sandbox_mode、approval_policy、model_provider和mcp_servers不會生效,一律嚴格繼承父會話當前的設定(沙箱規則見 Codex 權限與沙箱設定)。想讓子代理用某個 MCP 工具,必須在父會話裏配好該 MCP 服務。 - 關注並行額度消耗:一次派 4 個子代理出去,就等於同時跑了 4 輪獨立的模型推理和工具讀取,消耗套餐限額的速度顯著高於單代理。如果團隊日常大量使用並行子代理或 Ultra 模式,個人升級可看本站 ChatGPT Plus 充值說明 或無 5 小時窗口限制的 ChatGPT Pro 充值說明。
常見問題
問:自定義角色取名叫 explorer,會和內置的 explorer 衝突報錯嗎?
答:不會報錯。官方文檔寫明,當你的自定義角色 name 與內置角色(如 explorer、worker)重名時,優先採用你定義的版本。
問:在 codex exec 非交互腳本里跑子代理,中途子代理請求人工審批會怎樣?
答:非交互環境無法彈出審批框。官方說明凡是需要新人工審批的動作都會直接失敗,並把錯誤返回給父工作流處理;因此在自動化裏請提前給父命令設好合適的 --sandbox。
問:歸檔主會話時,它派生出來的子代理會話記錄還在嗎?
答:運行 codex archive 或 /delete 處理父會話時,Codex 會一併歸檔或刪除它所派生的子代理會話及其後代記錄。
相關教學
參考資料
- Codex 官方文檔:Subagents — https://learn.chatgpt.com/docs/agent-configuration/subagents
- Codex 官方文檔:Sample Configuration — https://learn.chatgpt.com/docs/config-file/config-sample
- Codex 官方文檔:Slash commands in Codex CLI — https://learn.chatgpt.com/docs/reference/slash-commands
0 條評論
還沒有評論,來搶沙發~