
結論先說
- 用戶級配置在
~/.codex/config.toml(~/.codex就是CODEX_HOME,預設位置)。桌面 App、命令行和 IDE 擴展讀的是同一套配置層。 - 項目級配置放倉庫裏的
.codex/config.toml,但官方寫明:只有你信任該項目時才會加載。 - 優先級從高到低共七層:命令行參數與
--config→ 項目配置 → profile 文件 → 用戶配置 → 雲端託管配置 → 系統配置 → 內置預設值。 - profiles 是獨立文件:
~/.codex/名字.config.toml,用codex --profile 名字選擇。官方強調:文件裏直接寫頂層鍵,不要再套[profiles.名字]。 - TOML 規則:根級鍵必須寫在所有表(
[xxx])之前,否則會讀錯位置。
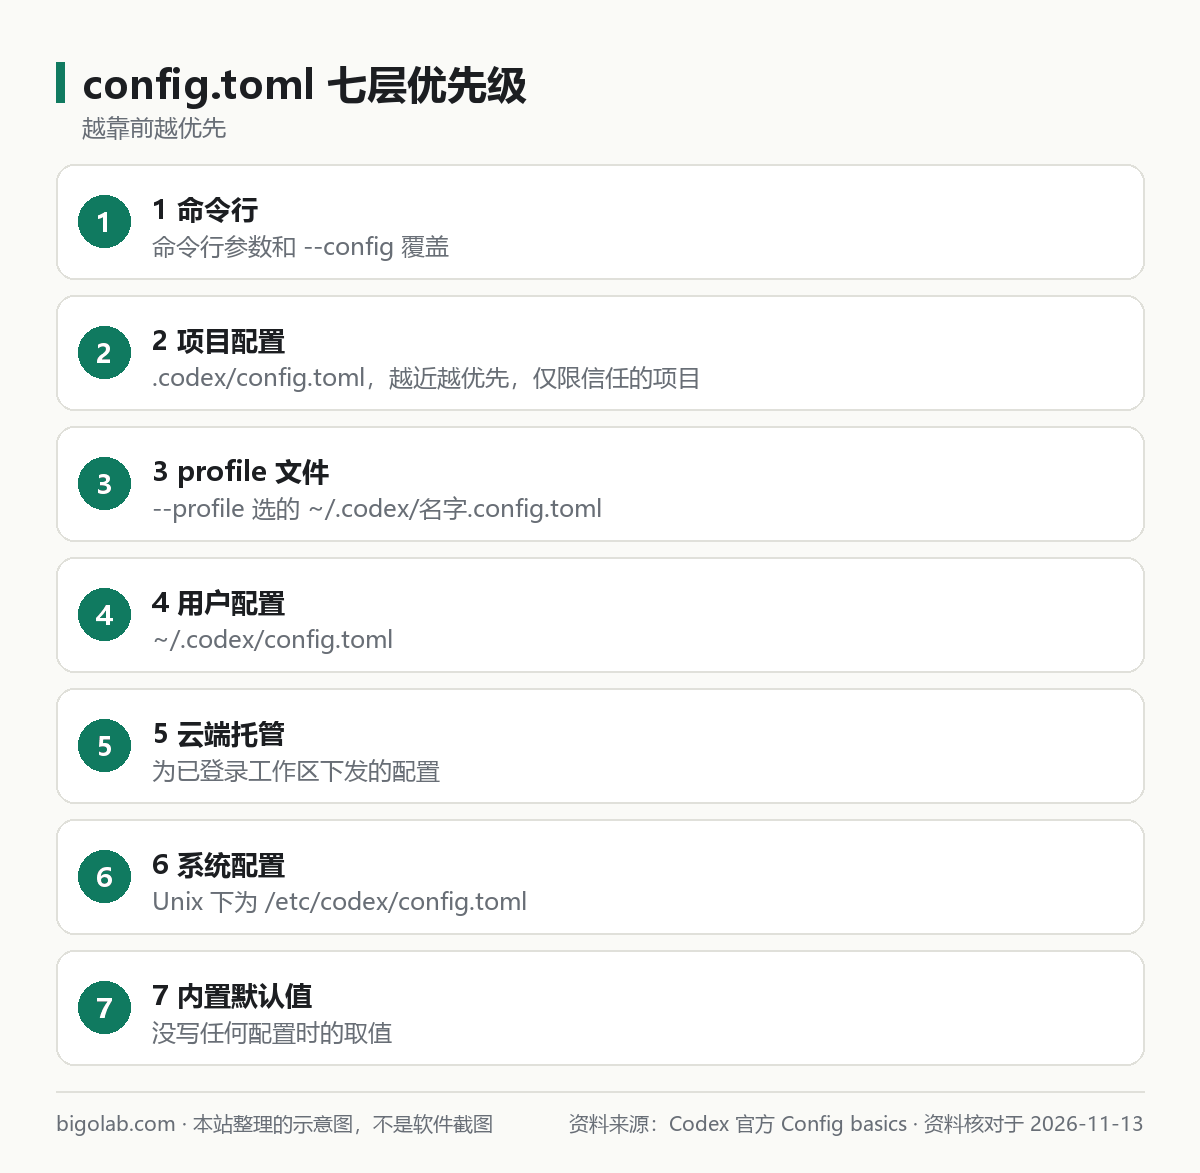
圖:本站根據 Codex 官方 Config basics 整理的示意圖
本文根據 Codex 官方文檔的 Config basics、Advanced Config、Sample Configuration 和 Configuration Reference 整理,資料核對於 2026-11-13。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。MCP 的配置寫法見 /guides/codex-mcp-config,權限與沙箱的取值見 /guides/codex-permissions-sandbox,本文不重複。
適用於誰
- 想知道 Codex 的配置文件在哪、能改什麼的人;
- 全局設定、項目設定、命令行參數衝突,不知道聽誰的人;
- 想給「日常」「代碼審查」「CI」準備不同配置一鍵切換的人。
一、文件在哪
- 用戶級:
~/.codex/config.toml。在 Windows 上對應用戶目錄下的.codex文件夾。如果在 WSL 裏跑命令行,它用的是 Linux 的家目錄,與 Windows 那份不共用,見 /guides/codex-app-vs-cli-which-better。 - 項目級: 倉庫裏的
.codex/config.toml。Codex 會從項目根目錄走到當前工作目錄,把沿途每一個.codex/config.toml都讀進來,同一個鍵以離你當前目錄最近的那份為準。項目裏相對路徑(比如model_instructions_file)按這個.codex文件夾計算。 - 系統級: Unix 下是
/etc/codex/config.toml,有才讀。 - IDE 擴展裏打開: 右上角齒輪 → Codex Settings > Open config.toml。
CODEX_HOME下還有auth.json(文件方式存憑據時)、history.jsonl(開啟歷史時)和日誌緩存等。
項目配置裏「被忽略」的鍵
出於安全,官方列出了項目裏的 .codex/config.toml 不能改的鍵,Codex 看到會忽略並在啟動時警告:openai_base_url、chatgpt_base_url、apps_mcp_product_sku、model_provider、model_providers、notify、profile、profiles、experimental_realtime_ws_base_url 和 otel。也就是說,換接口地址、換模型提供方、通知命令這類涉及憑據和外發的設定,只能寫在你自己的用戶級配置裏。
二、誰覆蓋誰:七層優先級
官方給的順序(越靠前越優先):
- 命令行參數和
--config覆蓋; - 項目配置文件(
.codex/config.toml,從項目根到當前目錄,越近越優先,僅限信任的項目); - 用
--profile選的 profile 文件; - 用戶配置
~/.codex/config.toml; - 為已登入工作區下發的雲端託管配置;
- 系統配置;
- 內置預設值。
實用做法是官方建議的:共用預設值寫進 config.toml,profile 文件只寫有差別的幾項。如果你的電腦由公司管理,管理員還可以用 requirements.toml 強制限制,比如禁止 approval_policy = "never" 或 sandbox_mode = "danger-full-access",這類限制不能被你的配置繞開。
項目被標為不信任時,Codex 跳過項目裏的 .codex/ 層,包括配置、鉤子和規則,用戶和系統層照常加載。
三、常用鍵怎麼寫
下面的鍵和寫法都來自官方 Config basics 或示例配置。
toml
model = "gpt-6.1-sol"               # 預設模型(需帳號可用)
model_reasoning_effort = "medium"   # 推理強度
approval_policy = "on-request"      # 何時請求審批,預設值
sandbox_mode = "read-only"          # 沙箱,示例配置裏的預設值
web_search = "cached"               # 聯網搜尋:cached(預設) | indexed | live | disabled
notify = ["python3", "/path/to/notify.py"]   # 回合結束時調用外部程序
幾處細節:
model_reasoning_effort官方寫的是「模型支持時才生效」,可選檔位隨模型而異,換法見 /guides/codex-switch-model-reasoning-effort。web_search預設"cached"。官方寫明使用完全訪問沙箱(如--yolo)時預設變成live。project_doc_max_bytes預設 32768,是讀取 AGENTS.md 並放進首輪指令的上限字節數;project_doc_fallback_filenames可以在沒有 AGENTS.md 時指定備用文件名,讀取規則見 /guides/codex-agents-md-how-it-reads。[history]表裏的persistence預設save-all,設成none就不再儲存本地會話記錄;max_bytes限制歷史文件大小,超出會刪最舊的。[features]表用來開關功能,寫法是功能名 = true;命令行臨時開啟用codex --enable 功能名。[tui]表控制終端介面,比如notifications、status_line、terminal_title。[projects."/絕對路徑"]下的trust_level取trusted或untrusted,決定上面說的項目層加不加載。[shell_environment_policy]控制轉發給子命令的環境變量。官方寫明ignore_default_excludes預設是 true,即不自動過濾名字含 KEY、SECRET、TOKEN 的變量;想要自動過濾要設成 false。
官方的示例配置文件按塊組織:核心模型、推理與詳略、指令覆蓋、通知、審批與沙箱、登入、項目文檔、歷史、介面、聯網搜尋、多 Agent 角色、技能、沙箱表、環境變量策略、功能開關、記憶、模型提供方、應用與連接器、profiles、項目信任、OpenTelemetry、Windows。你可以把它當字典,只複製要用的鍵,不用整份照搬。
四、profiles:一鍵切換整套設定
官方原話大意:用 --profile 名字 時,Codex 先讀 ~/.codex/config.toml,再疊上 ~/.codex/名字.config.toml。名字可以有字母、數字、連字符和下劃線。
例如新建 ~/.codex/deep-review.config.toml:
toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
approval_policy = "on-request"
使用:
bash
codex --profile deep-review
codex exec --profile deep-review "review this change"
因為 profile 層在項目和命令行之下、用戶配置之上,它只需要寫與基礎配置不同的部分。
舊寫法已失效。 官方寫明從 Codex 0.134.0 起,--profile 不再讀取 config.toml 裏的 [profiles.名字],頂層 profile = "名字" 選擇器也不再支持。如果你照着舊教學寫了這些,要把設定搬到 ~/.codex/名字.config.toml,再刪掉舊錶和舊選擇器。
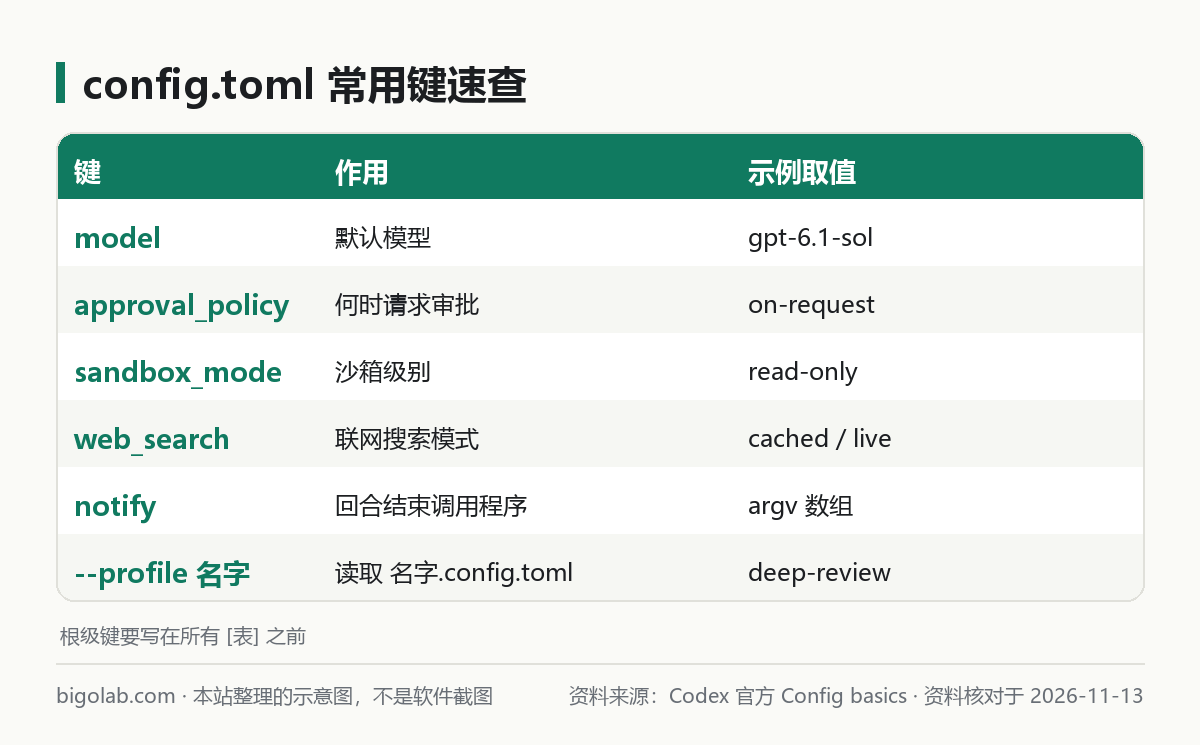
圖:本站根據 Codex 官方 Config basics 整理的示意圖
五、臨時改一次,不動文件
官方推薦:有專門參數就用專門參數(如 --model),否則用 -c / --config:
bash
codex --model gpt-6.1-sol
codex --config sandbox_workspace_write.network_access=true
codex -c log_dir=./.codex-log
要點:鍵可以用點號表示嵌套;值按 TOML 解析,所以字符串要帶引號(官方示例是 model='"gpt-6.1-sol"'),為了不被 shell 拆開最好整體加引號;解析不了時當字符串處理。
常見問題
Q:改了 config.toml 沒生效?
先看有沒有被更高層覆蓋:命令行參數、項目配置、profile 文件都比它優先;再確認這個鍵是不是被寫在了某個 [表] 的下面,根級鍵要寫在表之前。
Q:項目裏的配置為什麼沒讀?
多半是項目沒被信任,或寫的是上面那些被忽略的鍵。
Q:Codex 額度不夠用,是不是靠改配置能解決?
配置只能改模型和推理強度這類選擇,額度隨套餐,以官方頁面當前顯示為準。需要更高額度可看 ChatGPT Plus 充值說明。
相關教學
- /guides/codex-mcp-config:MCP 伺服器配置
- /guides/codex-permissions-sandbox:權限與沙箱
- /guides/codex-cli-commands-cheatsheet:命令速查
參考資料
- Codex 官方文檔:Config basics — https://learn.chatgpt.com/docs/config-file/config-basic
- Codex 官方文檔:Advanced Config — https://learn.chatgpt.com/docs/config-file/config-advanced
- Codex 官方文檔:Sample Configuration — https://learn.chatgpt.com/docs/config-file/config-sample
0 條評論
還沒有評論,來搶沙發~