
結論先說
- 多 Agent 協同寫代碼,最忌諱「多個代理同時改同一個文件」,最穩、最提質的則是「一個專職寫、一個獨立審」。
- 必須把「寫」和「審」放在兩個隔離的上下文窗口裏:同一個會話剛寫完代碼,上下文裏全是它為自己方案找的理由,順着原對話自審極易產生確認偏誤。
- 審查代理應當鎖死「只讀權限」:只給讀取源碼、搜引用和看
git diff的能力,禁止它直接動手改文件,強制輸出帶文件路徑、行號與觸發條件的缺陷清單。 - 先跑確定性工具(類型檢查、單測、Linter),再調審查代理:別浪費多代理額度去挑漏寫分號或編譯報錯這種編譯器一秒就能抓出來的問題。
- 跨模型交叉審查(比如 Claude 寫、Codex 審,或反過來)比同模型互審更能抓出思維盲區,且修改循環上限建議控制在 2 到 3 輪以內。
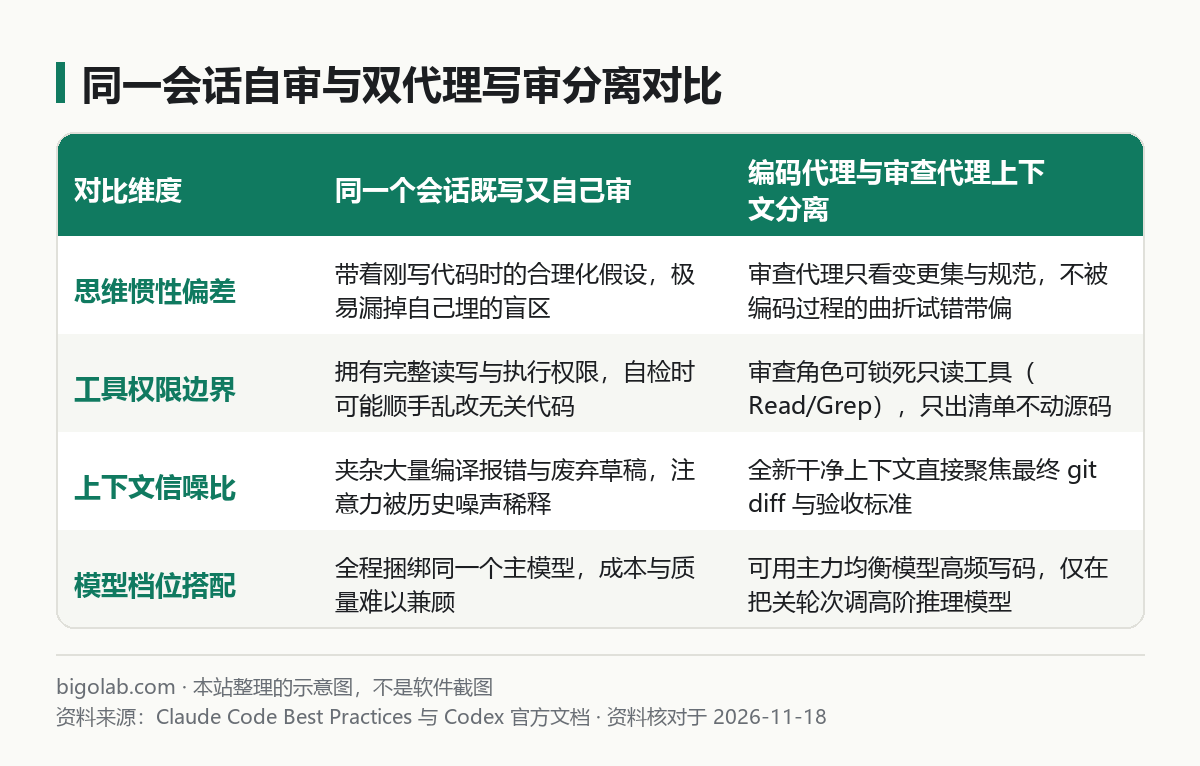
圖:本站根據 Claude Code Best Practices 與 Codex 官方文檔 整理的示意圖
本文根據 Anthropic 官方《Claude Code Best Practices》《Building effective agents》與 OpenAI Codex 官方文檔整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方網站。
適用於誰
- 搜「多agent協同開發」「ai 寫代碼 另一個 agent 審查」的人;
- 發現讓同一個對話「檢查一下你剛才寫的代碼有沒有 bug」基本查不出真問題的開發者;
- 想在不搭複雜平台的前提下,把 Claude Code、Codex 組合成「一寫一審」雙保險流水線的人。
如果你要配的是多人研發團隊在 GitHub PR 上的託管自動審查,見 /guides/claude-code-team-code-review-workflow;本文聚焦開發階段兩個智能體「一寫一審」協同編碼的落地模式。
一、為什麼「同一個會話自審」效果差
在 Anthropic 官方的《Claude Code Best Practices》裏,專門把「Writer / Reviewer(一寫一審雙會話或子代理)」列為核心工作流。背後的技術原因很直接:
- 歷史推理軌跡帶偏注意力:編碼代理在實現功能時,剛剛經歷了三四次編譯失敗、調整參數的過程,上下文窗口裏塞滿了中間草稿;你緊接着問它「有沒有漏掉邊界」,它大概率順着剛才通過測試的喜悅回答「邏輯已完整」;
- 角色指令互相稀釋:寫代碼的提示詞鼓勵模型大刀闊斧推進實現,而審代碼的提示詞要求模型抱持懷疑態度挑毛病,塞進同一個窗口會互相掣肘。
把未提交的 git diff 交給一個完全沒參與剛才編碼過程的新代理實例,它看到的只有客觀的代碼變更與項目規範,挑出空指針、鑑權遺漏和並發競態的概率會高出一截。這也是「生成-評估(Evaluator-Optimizer)」編排模式在軟件工程裏的標準應用(編排原理見 /guides/multi-agent-orchestration-patterns)。
二、三種從輕到重的「一寫一審」落地方式
方式一:單工具內「主會話寫 + 只讀子代理審」(最省事)
不需要開第二個軟件,直接在項目裏建一個沒有寫文件權限的審查子代理(更多子代理寫法見 /guides/claude-code-custom-subagent-test-runner-debugger-examples)。以 .claude/agents/code-critic.md 為例:
markdown
---
name: code-critic
description: 對當前未提交的 git diff 做獨立只讀審查,只找邏輯錯誤、安全隱患與漏測邊界
tools: Read, Grep, Glob, Bash
---

你是一名只讀審查員,嚴禁修改任何文件。
1. 運行 `git diff` 查看工作區變更,並用 Read 閱讀關聯上下文;
2. 忽略純主觀命名與排版偏好,只報告會導致線上故障、越權訪問、數據不一致或缺少測試覆蓋的問題;
3. 每條問題必須給出 `文件路徑:行號`、復現條件與修復方向;若無實質缺陷直接輸出「未發現阻斷性問題」。
開發時,先讓主會話寫完代碼並跑通單元測試,然後輸入一句「調用 code-critic 子代理審查當前改動」,主會話拿到缺陷列表後再逐條核對修補。如果你用的是 Codex,它內置的 /review 命令與多代理機制(見 /guides/codex-multi-agent-subagents-guide)同樣會在獨立只讀上下文裏審查工作區改動。
方式二:Claude Code + Codex 跨模型交叉互審(抓盲區最強)
同一家族的大模型往往有相似的編碼習慣與知識盲區。很多資深開發者在本機同一個倉庫裏同時裝好 Claude Code 和 Codex CLI,按「異構雙代理」配合:
- 在終端左半屏用 Claude Code 完成複雜多文件重構並跑通本地測試;
- 在終端右半屏用 Codex 對當前未提交改動執行本地只讀審查(或反過來由 Codex 寫、Claude Code 新開乾淨會話審);
- 你作為仲裁者掃一眼右半屏給出的 2 到 3 條高優風險,把確認成立的條目貼回左半屏一次性改完。
平時雙持兩套官方工具鏈交替開發時,如需核對各自官方訂閱方案(如 Claude Pro / Max 或 ChatGPT Plus),可分別參考 /chongzhi/claude-code 與 /chongzhi/chatgpt-plus 的整理說明。
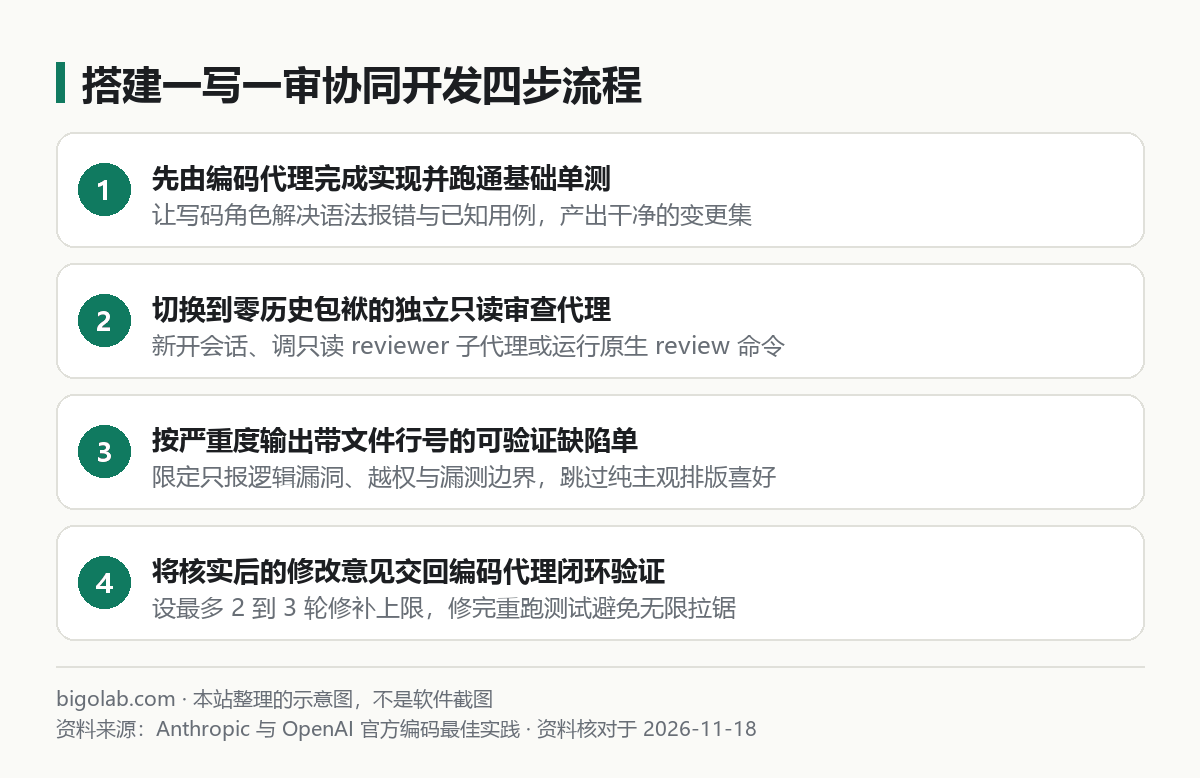
圖:本站根據 Anthropic 與 OpenAI 官方編碼最佳實踐 整理的示意圖
方式三:自動化腳本里的「寫-測-審」閉環
如果你用 Agent SDK 或非交互命令行把「寫代碼 → 審查」串成無人值守腳本,務必遵守三條防失控鐵律:
- 硬門禁卡在前面:先用普通腳本跑
tsc、lint和單元測試,測試沒綠直接把報錯塞回編碼代理重修,根本不要喚醒審查代理燒額度; - 結構化判定出口:要求審查代理輸出固定字段(例如
approved: true/false加blocking_issues數組),只有存在阻斷級缺陷才打回重改; - 封死最大輪數(
max_rounds = 2或3):一旦兩輪還沒達成一致,立刻停機把雙方的分歧點拋給人類開發者拍板,防止兩個代理在邊緣寫法上來回改十遍。
常見問題
Q:能不能再加第三個「架構師代理」、第四個「產品經理代理」組成五人流水線?
個人或小團隊日常寫業務代碼,超過兩到三個角色後,代理之間傳遞需求損耗和等待時間會急劇增加,「需求文檔寫清楚(人)→ 編碼代理實現 + 單測 → 獨立只讀代理審查」這三步閉環的性價比遠高於花哨的五角色傳話遊戲。
Q:審查代理總是挑一堆無關痛癢的註釋和變量名毛病怎麼辦?
在審查代理的系統提示詞裏加一條硬性負向約束:「如果改動邏輯正確且無安全漏洞,允許返回 0 條意見;嚴禁為了湊數提出純代碼風格、添加註釋或防禦性冗餘判空建議。」
Q:寫代碼的模型和審代碼的模型怎麼配檔位最划算?
如果兩邊用同系模型,可以讓主力高性價比模型(如 Sonnet)負責高頻寫代碼和修單測,只在最後定稿審查那一輪調用高推理檔位的旗艦模型(如 Opus)做一次深度把關。
相關教學
- /guides/multi-agent-orchestration-patterns:多 Agent 四大編排模式與生成-評估循環詳解
- /guides/claude-code-team-code-review-workflow:團隊級 Claude Code 本地與 PR 自動審查流程
- /guides/claude-code-custom-subagent-test-runner-debugger-examples:Claude Code 只讀審查與測試子代理配置實例
- /guides/codex-multi-agent-subagents-guide:Codex 多 Agent 與子代理分工指南
參考資料
- Claude Code 官方文檔:Best practices for Claude Code — https://code.claude.com/docs/en/best-practices
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI Codex 官方文檔 — https://developers.openai.com/codex
0 條評論
還沒有評論,來搶沙發~