
結論先說
- 官方能力排序從強到輕依次是:GPT-6.2 Astra、GPT-6.2 Sol、GPT-6.1 Terra、GPT-6 Luna。 在軟件工程、數據分析、三維與設計、研究決策等六個官方維度上,排序完全一致。
- 日常寫代碼優先選
GPT-6.2 Sol(或帳號內可用的GPT-6.1 Sol)。 官方將它定位於日常編碼、審閱改動與整合多份資料,同等付費套餐下比 Astra 能跑完更多任務。 - 跨服務疑難排錯和開放式方案權衡選
GPT-6.2 Astra。 它的推理最深,但單次消耗額度和等待時間也最高。 - 看截圖查介面、桌面操作選
GPT-6.1 Terra;提取字段、格式轉換等重複小活選GPT-6 Luna。 - 模型要和推理強度配着用。 官方建議拿一個熟悉的代表性任務對比,保留「能達到質素要求的最低檔設定」。具體切換步驟見 Codex 怎麼切換模型和思考強度。
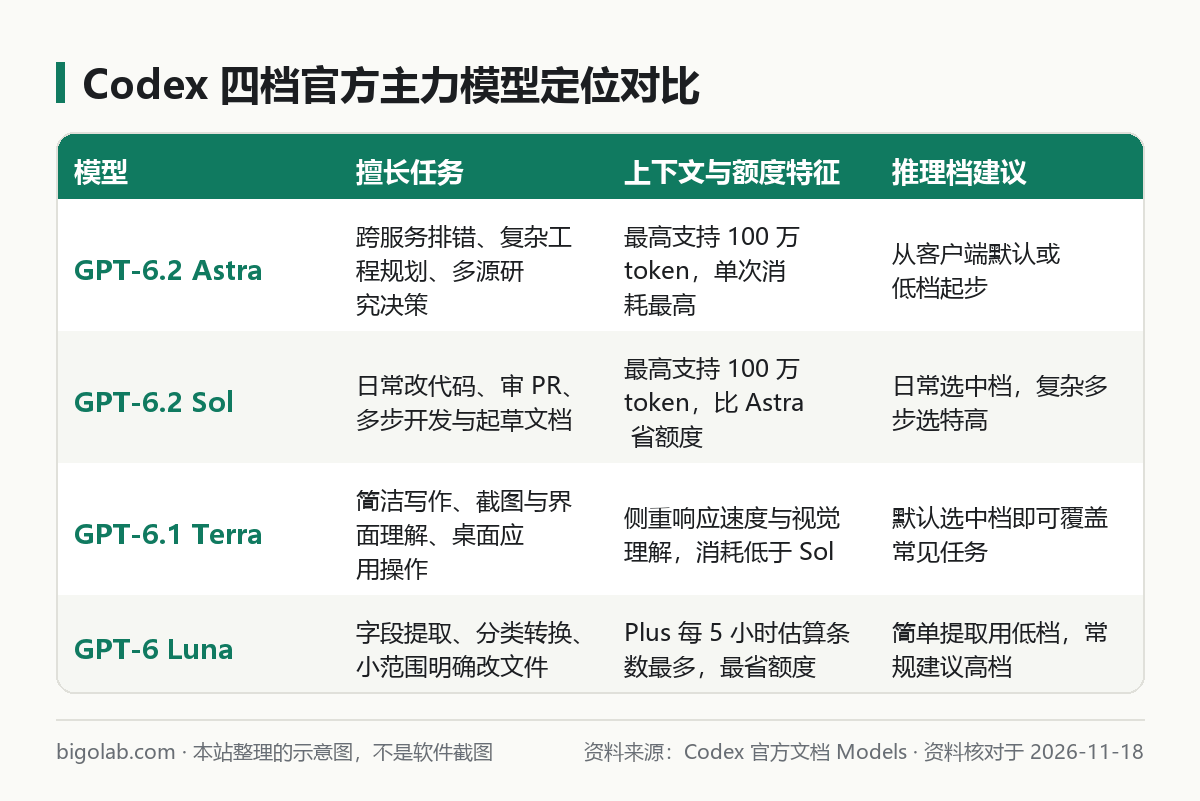
圖:本站根據 Codex 官方文檔:Models 整理的示意圖
本文根據 Codex 官方文檔《Models》《GPT-6.2》《Pricing》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 搜「codex模型推薦」「codex模型排行」,面對模型列表不知道日常寫代碼該選哪一個的人;
- 想在推理深度、等待時間和套餐額度消耗之間找到平衡的人;
- 舊腳本或配置裏還寫着已退役模型名,需要換到當前在用模型的人。
一、四個主力模型各自擅長什麼
按官方文檔對當前主力模型的劃分,不要只看誰最強,而是看任務需不需要持續的多步推理:
- GPT-6.2 Astra(及 GPT-6 Astra):面向最難的端到端工作。適合跨多個服務追蹤故障根因、修復並跑通關聯測試,或在多份衝突方案之間權衡利弊。它與 GPT-6.2 Sol 一樣支持最高 100 萬 token 的上下文窗口(詳見 Codex App 怎麼設定 1M 上下文)。
- GPT-6.2 Sol(及 GPT-6.1 Sol):面向日常主力開發。適合在現有代碼庫裏修 Bug、加功能、審閱合併請求(PR)、按評審意見改代碼,以及把會議紀要整理成實施計劃。標準速度下,它的每百萬 token 點數消耗只有 GPT-6.2 Astra 的四分之一。
- GPT-6.1 Terra:面向日常寫作、視覺理解與電腦操作。適合看儀表盤或網頁截圖總結變化、核對介面元素、按源文檔填表,以及範圍明確的小修小補。命令行使用需 Codex CLI 0.159.0 及以上版本。
- GPT-6 Luna:面向清晰、可重複的高頻任務。適合提取字段、做分類、轉成固定表格,或做預期結果一目了然的文件小改動。
二、官方給出的「模型 + 推理強度」八組搭配
官方文檔將常見工作對應到了八組起始檔位,拿不準時可照着起步:
| 組合 | 官方推薦的典型場景 |
|---|---|
| GPT-6 Luna · Low | 預期結果明確的小文件修改、字段提取 |
| GPT-6 Luna · Extra high | 跨應用查找更新、排定跟進優先級、解決邊界清晰的規則問題 |
| GPT-6.1 Terra · Medium | 操作桌面應用、更新記錄、做容易驗證的局部修復 |
| GPT-6.2 Sol · Medium | 在現有代碼庫修 Bug、加功能,或起草待審閱文檔 |
| GPT-6.2 Sol · Extra high | 需要邊寫邊跑測試、反覆修正的多步開發任務 |
| GPT-6.2 Astra · Low | 把一份寫得很清楚的需求簡報直接變成可交付成品 |
| GPT-6.2 Astra · Medium | 規劃並推進複雜工程,在執行中根據新資訊調整方案 |
| GPT-6.2 Astra · Extra high | 處理開放式難題,需要權衡取捨並逐一驗證假設 |
關於更高檔位,官方單獨區分了 Max(拉長單線推理時間,Luna 最高支持到 Max)和 Ultra(自動拆分子代理並行處理複雜任務的不同部分)。桌面端滑塊沒看到 Ultra 時,去 設定(Settings)> 配置(Configuration) 打開 Ultra in model picker slider;CLI 裏輸入 /model 選好模型後再選 More reasoning…。
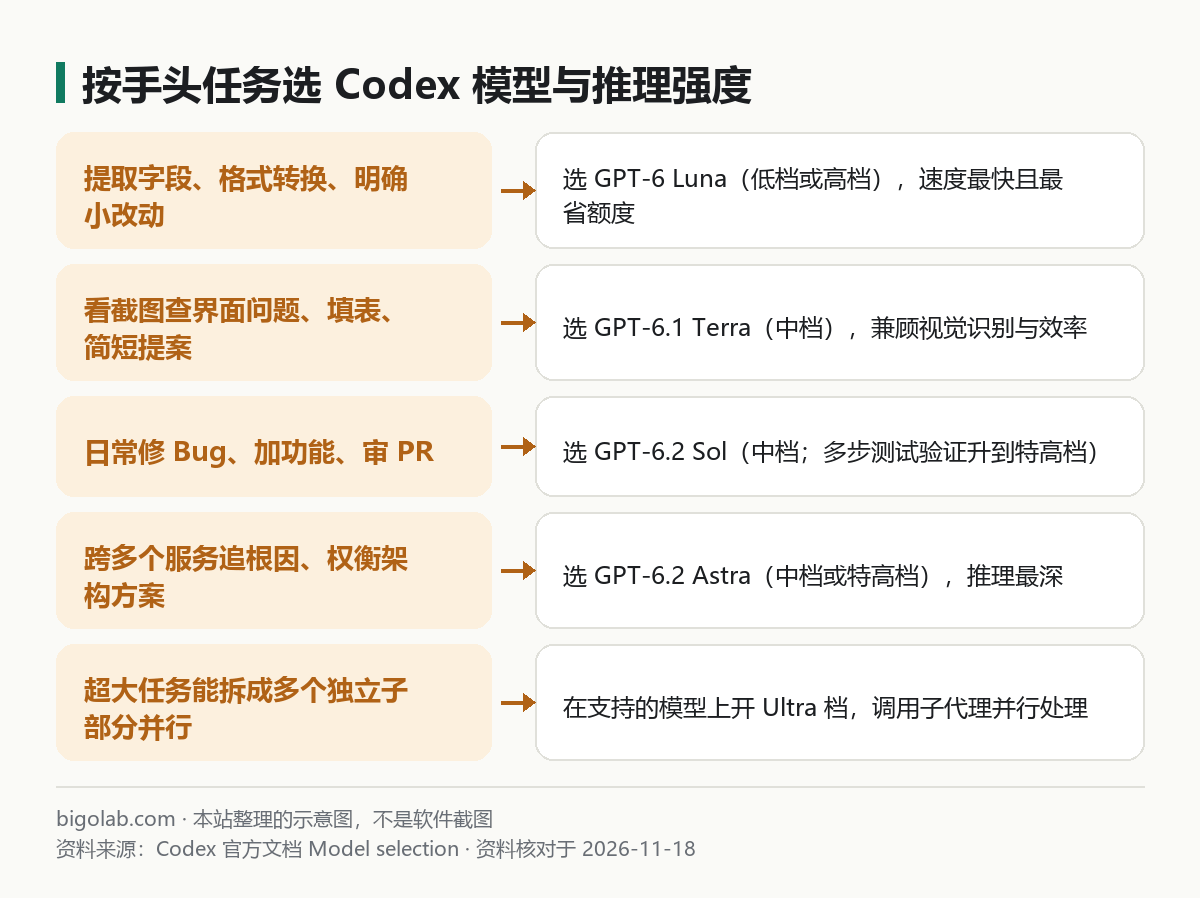
圖:本站根據 Codex 官方文檔:Models 整理的示意圖
三、結合套餐額度看性價比與退役模型替換
按官方定價頁對 Plus 和 Business 標準席位的每 5 小時本地消息估算區間:
- GPT-6.2 Astra:約 6–50 條;
- GPT-6.2 Sol:約 17–180 條;
- GPT-6.1 Terra:約 35–285 條;
- GPT-6 Luna:約 350–3,000 條。
日常用 Sol 中檔、瑣碎整理用 Luna、遇到卡殼難題再切 Astra,同一份套餐能撐起多得多的工作量。免費版與 Go 目前僅在桌面端逐步開放 GPT-6 Luna 且不含雲端任務。想用上 Sol 與 Astra 跑完整開發,可看本站 ChatGPT Plus 充值說明 或無 5 小時限制的 ChatGPT Pro 充值說明,窗口細則見 Codex 額度與使用限制。
同時請檢查 ~/.codex/config.toml(見 Codex config.toml 完整詳解)和自動化腳本,把已從 ChatGPT 登入方式退役的舊模型名換掉:gpt-5.3-codex-spark(2026-09-14 退役,見 GPT-5.3 Codex Spark 退役說明)、gpt-5.5(2026-10-14 退役)、gpt-5.4 與 gpt-5.4-mini(2026-08-31 退役)以及已棄用的 gpt-5.2、gpt-5.3-codex。
常見問題
問:為什麼我在桌面端或 CLI 的 /model 裏看不到 GPT-6.2 Astra 或 Sol?
答:先更新客戶端到最新版;若在 Enterprise 或 Edu 工作區,這兩個模型預設關閉,需管理員在工作區模型設定裏開啟。
問:普通 ChatGPT 網頁聊天裏能選 GPT-6.2 Sol 嗎?
答:官方說明 GPT-6.2 Astra、GPT-6.2 Sol、GPT-6.1 Sol 和 GPT-6.1 Terra 在 ChatGPT Work 與 Codex 中提供,普通 Chat 列表與它們獨立。
問:多端共用 config.toml 時,model 預設值寫哪個最穩?
答:官方建議填寫你所有常用客戶端(桌面端、CLI、IDE 擴展)都已開放的模型名,如 gpt-6.2-sol 或 gpt-6.1-sol。
相關教學
- Codex 怎麼切換模型和思考強度
- Codex 額度與使用限制
- Codex App 怎麼設定 1M 上下文
- GPT-5.3 Codex Spark 退役與替換說明
- Codex config.toml 完整詳解
參考資料
- Codex 官方文檔:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文檔:GPT-6.2 — https://learn.chatgpt.com/docs/whats-new/gpt-62-astra-sol
- Codex 官方文檔:Pricing — https://learn.chatgpt.com/docs/pricing
0 條評論
還沒有評論,來搶沙發~