
本文根据 OpenAI 官方《Counting tokens》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 想在发请求之前知道提示词会占多少 token 的开发者;
- 做预算、想估算一次调用大概多少钱的人;
- 发现
output_tokens比屏幕上看到的文字多,想弄明白为什么的人。
结论先说
- token 是模型处理文本的计量单位,计费和上下文限制都按它算。
- 官方提供了专门的计数接口:
POST /v1/responses/input_tokens,参数和responses.create一样,返回这个请求会用多少输入 token。 - 本地分词器只适合纯文本。 官方说图片和文件它不支持,“字符数除以 4”这类估算不准,工具定义和 schema 的额外 token 也很难本地数清。
- 计数包含格式化 token,比如消息的角色和边界,所以会比你只对正文分词的结果多。
- 输出 token 可能比你看到的多:官方说计入的是模型生成的全部 token,包括不可见的。
- 费用 = 用量 × 单价,单价以官方价格页当天为准,见 /guides/openai-api-price-official-table。
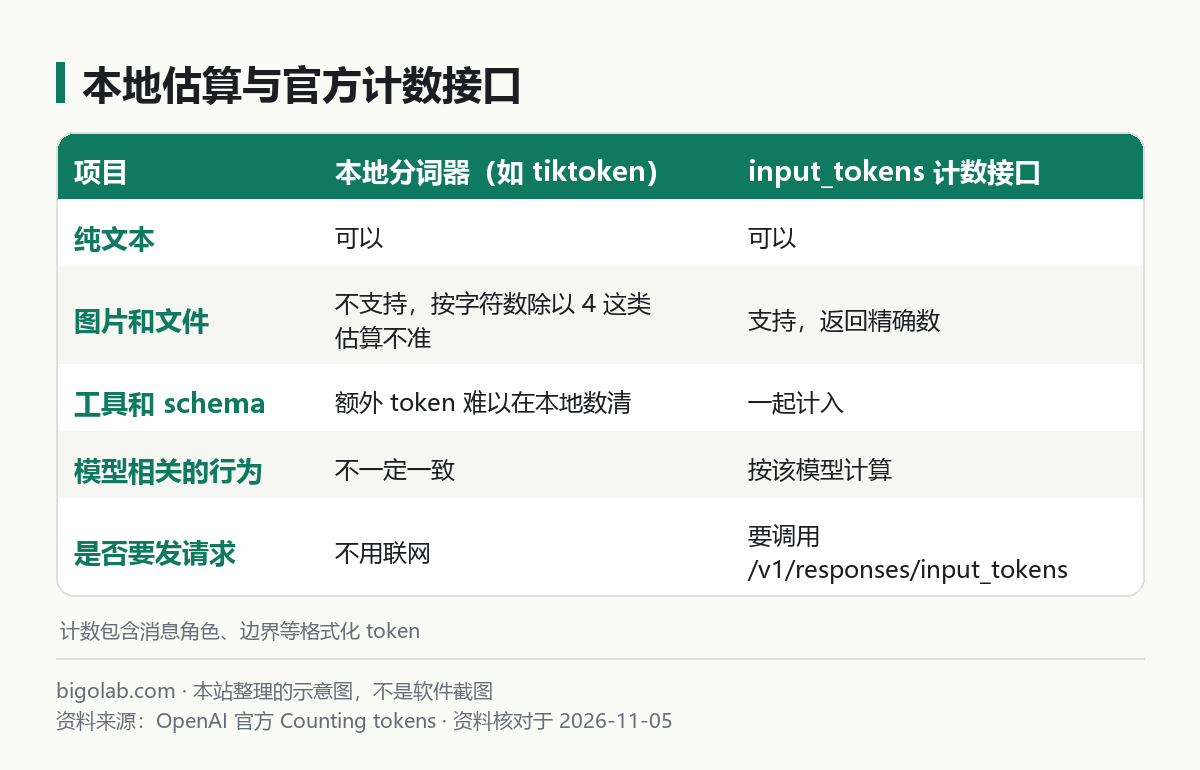
图:本站根据 OpenAI 官方《Counting tokens》 整理的示意图
一、用计数接口数输入 token
Python(先 pip install openai,密钥设置见 /guides/openai-api-python-quickstart):
python
from openai import OpenAI

client = OpenAI()

response = client.responses.input_tokens.count(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input="Tell me a joke.",
)
print(response.input_tokens)
Node.js(保存为 .mjs):
javascript
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.inputTokens.count({
  model: "gpt-6-astra", // 以官方模型页当天为准
  input: "Tell me a joke.",
});

console.log(response.input_tokens);
官方说,这个接口接受和 Responses API 相同的输入格式:文字、消息、图片、文件、工具、对话都可以传,返回的是模型实际会收到的精确数量。所以最稳妥的用法是:把你准备发给 responses.create 的那份参数原样拿来调用 count。
带系统指令和多轮对话
指令用 instructions,多轮对话用消息数组,都和正式请求一样:
python
response = client.responses.input_tokens.count(
    model="gpt-6-astra",
    instructions="You are a helpful assistant that explains concepts simply.",
    input=[
        {"role": "user", "content": "What is 2 + 2?"},
        {"role": "assistant", "content": "2 + 2 equals 4."},
        {"role": "user", "content": "What about 3 + 3?"},
    ],
)
print(response.input_tokens)
带图片
图片按尺寸和 detail 档位折算 token。官方说计数接口返回精确数,不需要猜;图片可以用 file_id,也可以用 image_url(网址或 Base64 数据 URL)。传图方式见 /guides/openai-api-image-input。
javascript
const response = await client.responses.inputTokens.count({
  model: "gpt-6-astra",
  input: [
    {
      role: "user",
      content: [
        { type: "input_image", image_url: "https://example.com/chart.png", detail: "auto" },
        { type: "input_text", text: "Summarize this chart." },
      ],
    },
  ],
});
带工具
函数 schema、MCP 服务器这类工具定义也会占上下文,官方建议把它们和输入一起数。函数定义怎么写见 /guides/openai-api-function-calling:
python
response = client.responses.input_tokens.count(
    model="gpt-6-astra",
    tools=[
        {
            "type": "function",
            "name": "get_weather",
            "description": "Get the current weather in a location",
            "parameters": {
                "type": "object",
                "properties": {"location": {"type": "string"}},
                "required": ["location"],
            },
        }
    ],
    input="What is the weather in San Francisco?",
)
print(response.input_tokens)
带文件
官方说文件输入目前支持 PDF,可传 file_id、file_url 或 file_data,和 responses.create 一样;计数反映模型完整处理后的输入。
二、为什么不能只用 tiktoken
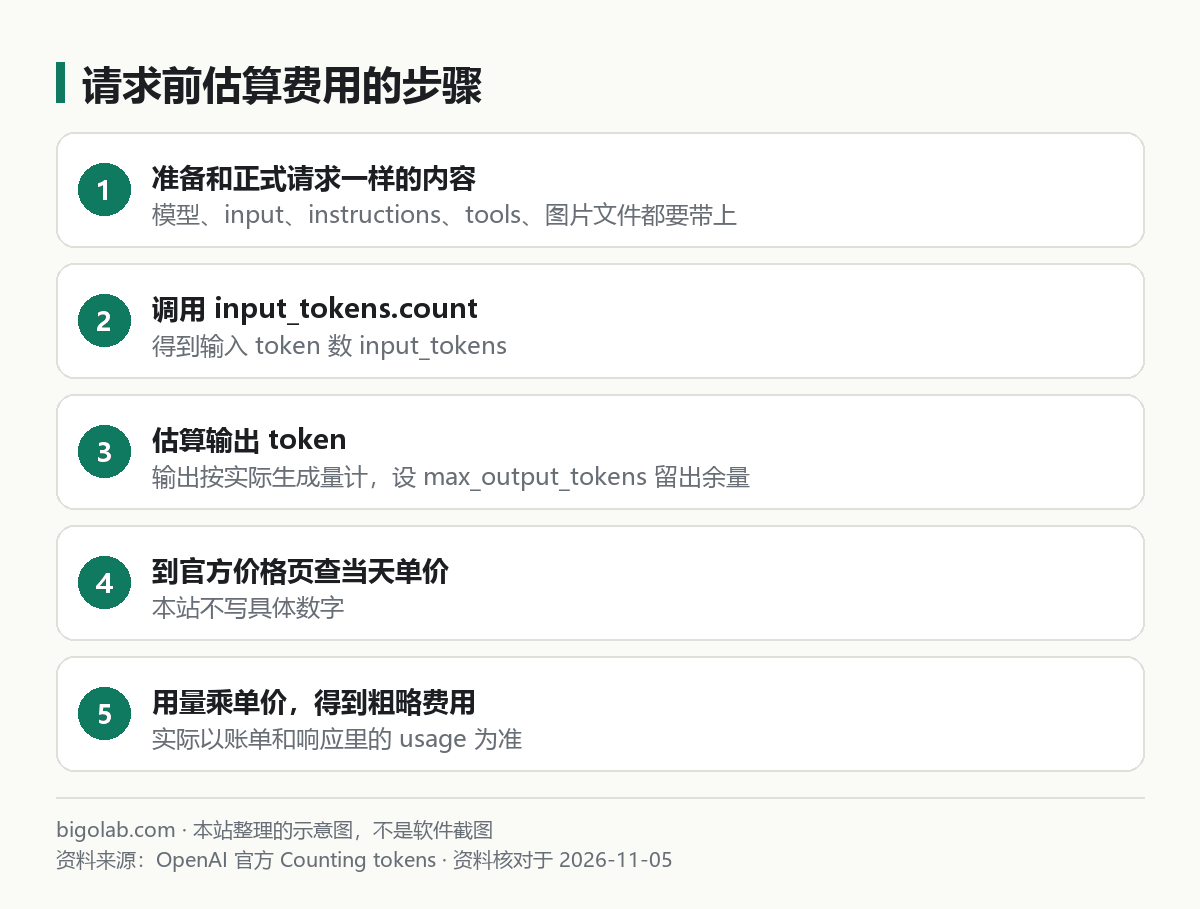
图:本站根据 OpenAI 官方《Counting tokens》 整理的示意图,步骤顺序为本站归纳
tiktoken 是 OpenAI 的分词库,适合在本地快速数纯文本。官方的向量嵌入文档给了示例:
python
import tiktoken

def num_tokens_from_string(string: str, encoding_name: str) -> int:
    encoding = tiktoken.get_encoding(encoding_name)
    return len(encoding.encode(string))

print(num_tokens_from_string("tiktoken is great!", "cl100k_base"))
官方在向量模型那一页说,第三代向量模型(如 text-embedding-3-small)用 cl100k_base 编码,向量的用法见 /guides/openai-api-embeddings。至于聊天模型该用哪种编码,官方这几页没有写,本文不下结论。
计数接口那页列出了本地分词的三个局限:
- 图片和文件不被支持,用“字符数除以 4”估算是不准的;
- 工具和 schema 会增加难以在本地数清的 token;
- 模型相关的行为(官方举例:推理、缓存)可能改变分词。
所以有图片、文件、工具时,用计数接口;只是纯文本、要离线粗算,才用 tiktoken。
三、输出 token:比你看到的多
官方在「Understand output token counts」里说明:
- 报告的输出 token 用量包括模型生成的所有 token,不只是响应里看得见的文字;
- Responses API 里这个总数叫
output_tokens,Chat Completions 里叫completion_tokens; - 一些模型(官方点名包括 GPT-5 系列)会生成用于格式化或分隔响应通道、工具调用等结构的 token,这些 token 不出现在消息内容或
logprobs里,也不一定单独列出。因此报告的输出 token 可能高于可见 token,即使reasoning_tokens是 0; max_output_tokens和max_completion_tokens限制的是模型生成的所有 token,包括不可见的。不可见 token 的数量随模型和响应形态而变,不要假设固定差值;需要特定长度的可见输出时,给限制留出余量。
这就解释了一种常见的困惑:“我只让它回一句话,为什么 output_tokens 比字数多?”以及“max_output_tokens 设得刚好够,输出却被截断”。后一种情况的处理,参见 /guides/openai-api-structured-outputs 里 incomplete 状态的判断。
四、怎么估算一次调用的费用
本站归纳的流程(价格数字请自行到官方页面取,本文不写):
- 用计数接口,传和正式请求完全相同的内容,得到
input_tokens; - 估算输出:输出按实际生成的量计,估一个上限并用
max_output_tokens限制,同时留出余量; - 到官方价格页查当天的输入、输出单价,见 /guides/openai-api-price-official-table;
- 费用大致 = 输入 token × 输入单价 + 输出 token × 输出单价;
- 缓存、批处理等折扣会让实际费用不同,最终以响应里的
usage和账单为准,账单入口见 /guides/openai-api-pricing-billing。
批量任务想省钱,可以看 /guides/openai-api-batch 里官方写明的折扣规则。
常见问题
Q:计数接口本身收费吗?
官方这一页没有写它的计费情况,本文不下结论,请以官方价格页和 API 参考为准。
Q:计数接口返回的和账单一致吗?
官方说返回的是“模型会收到的精确数量”,指的是输入。实际账单还包括输出 token,以及缓存等因素,以账单为准。
Q:图片到底算多少 token?
官方图片页说明了不同模型的计算规则,并提供了 Image input cost calculator,详见 /guides/openai-api-image-input。
参考资料
- OpenAI 官方:Counting tokens — https://developers.openai.com/api/docs/guides/token-counting
- OpenAI 官方:Vector embeddings — https://developers.openai.com/api/docs/guides/embeddings
0 条评论
还没有评论,来抢沙发~