
本文根据 OpenAI 官方《Image generation》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 想在自己的程序里“用文字生成图片”或“改一张图”的开发者;
- 在 Image API 和 Responses 的
image_generation工具之间拿不定主意的人; - 听说 GPT Image 要组织验证、不知道是不是影响自己的人。
结论先说
- 官方现在用两个模型做图像生成和编辑:
gpt-image-2.5-sunburst适合编辑精度最重要的流程,gpt-image-2.5-flare适合快速、高质量的日常生成。官方页面还提到 GPT Image 2.6,但现有示例用的是 2.5,以官方模型页为准。 - 有两条路:Image API(
images.generate和images.edit),或者 Responses API 里的内置image_generation工具。 - 选择原则:只要从一个提示词生成或编辑一张图,用 Image API;要做对话式、可以反复修改的图片体验,用 Responses API。
- 返回的是 Base64,需要自己解码保存成文件。
- 可能需要组织验证:官方提示,使用 GPT Image 模型前,你可能需要在开发者控制台完成 API Organization Verification,具体步骤看官方帮助文章。
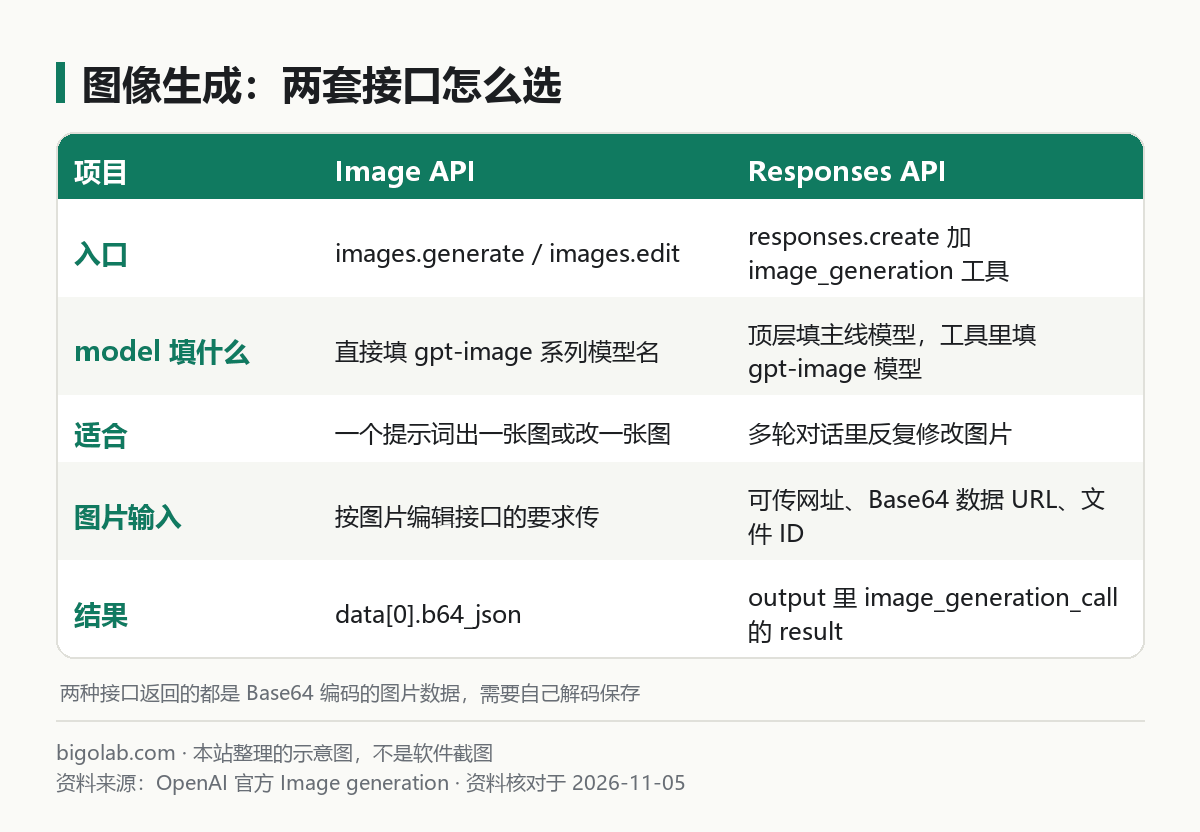
图:本站根据 OpenAI 官方《Image generation》 整理的示意图
一、用 Image API 生成一张图
Python(先 pip install openai):
python
from openai import OpenAI
import base64

client = OpenAI()

prompt = "一幅儿童绘本风格的插画:兽医用听诊器给一只小水獭听心跳。"

result = client.images.generate(
    model="gpt-image-2.5-sunburst",  # 以官方模型页当天为准
    prompt=prompt,
)

image_bytes = base64.b64decode(result.data[0].b64_json)
with open("otter.png", "wb") as f:
    f.write(image_bytes)
Node.js(保存为 .mjs):
javascript
import OpenAI from "openai";
import fs from "fs";

const openai = new OpenAI();

const result = await openai.images.generate({
  model: "gpt-image-2.5-sunburst", // 以官方模型页当天为准
  prompt: "一幅儿童绘本风格的插画:兽医用听诊器给一只小水獭听心跳。",
});

const imageBytes = Buffer.from(result.data[0].b64_json, "base64");
fs.writeFileSync("otter.png", imageBytes);
要一次出多张图,用 n 参数;不写默认返回一张。
二、用 Responses 的 image_generation 工具
在 Responses 里,顶层 model 填一个支持该工具的主线模型,图像模型写在工具里:
python
response = client.responses.create(
    model="gpt-6-astra",  # 主线模型,以官方模型页当天为准
    input="生成一张图:一只灰色虎斑猫抱着一只围着橙色围巾的水獭",
    tools=[{"type": "image_generation", "model": "gpt-image-2.5-sunburst"}],
)

image_data = [
    o.result for o in response.output if o.type == "image_generation_call"
]

if image_data:
    with open("cat_and_otter.png", "wb") as f:
f.write(base64.b64decode(image_data[0]))官方说,用这条路可以多轮编辑:把上一轮的 previous_response_id 带上,再说“现在让它更写实一些”,就能在上一张的基础上继续改。工具里有个可选参数 action:auto(让模型自己决定是新生成还是编辑)、generate(总是新生成)、edit(强制编辑)。如果强制 edit 而上下文里没有图片,会返回错误,所以一般保持 auto。
官方还说 Responses 请求的计费除了图像生成,还包含主线模型本身的 token 用量。支持该工具的主线模型是 gpt-5 及更新的模型,具体到某个模型要看它的详情页。
三、尺寸、质量和格式
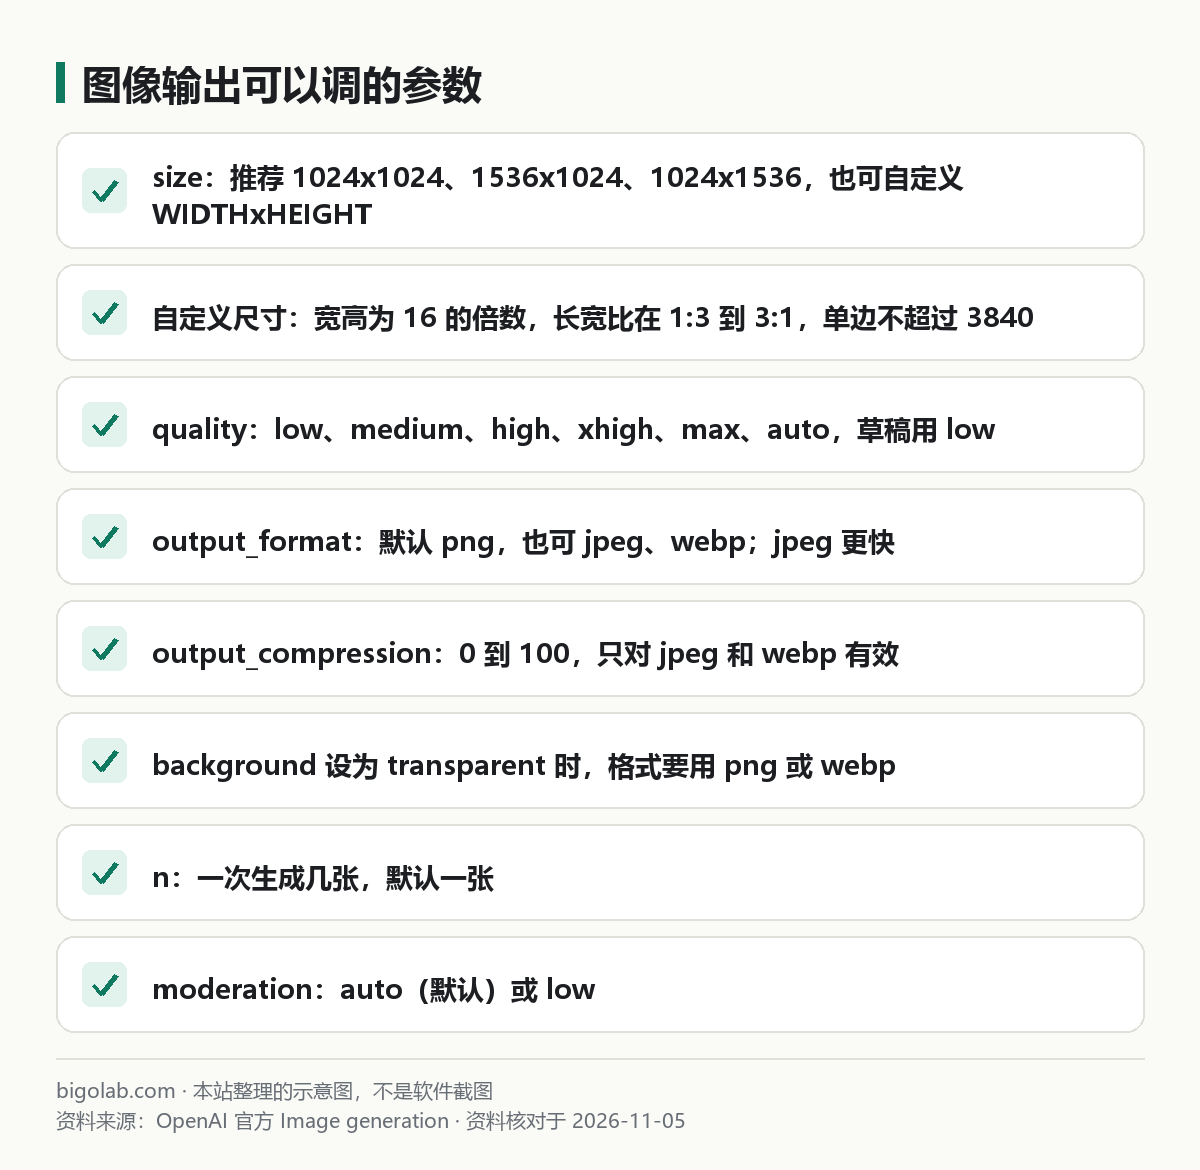
图:本站根据 OpenAI 官方《Image generation》 整理的示意图
官方列出的可配置项:
- size:推荐
1024x1024(方形)、1536x1024(横)、1024x1536(竖)。两个 2.5 模型也支持自定义WIDTHxHEIGHT,如1536x864,要求宽高是 16 的倍数、长宽比在 1:3 到 3:1 之间、单边不超过 3840 像素,总像素在 655,360 到 8,294,400(4K)之间,超过2560x1440的分辨率官方标为实验性; - quality:
low、medium、high、xhigh、max、auto,默认auto。官方建议快速草稿用low,最终成品对比更高档位,在细节、延迟和成本之间取平衡; - 格式:默认
png,也可以jpeg、webp。jpeg和webp可以用output_compression设 0 到 100 的压缩率;官方说jpeg比png快,在意延迟时优先考虑; - 背景:要透明背景,设
background: "transparent",并用png或webp格式。
四、改图与遮罩
Image API 的 images.edit 可以:编辑已有图片;用其他图片作参考生成新图;上传图片加遮罩,只替换遮罩标出的部分。官方遮罩示例(Python):
python
result = client.images.edit(
    model="gpt-image-2.5-sunburst",
    image=open("sunlit_lounge.png", "rb"),
    mask=open("mask.png", "rb"),
    prompt="阳光充足的室内休息区,泳池里有一只火烈鸟",
)

with open("composition.png", "wb") as f:
    f.write(base64.b64decode(result.data[0].b64_json))
遮罩的几条规则:
- 原图和遮罩格式、尺寸必须一致,且大小小于 50MB;
- 遮罩必须带 alpha 通道,用图片编辑工具做遮罩时要保存 alpha 通道;官方还给了用 Pillow 给黑白遮罩补 alpha 通道的示例;
- 官方特别说明:GPT Image 的遮罩完全基于提示词,模型把遮罩当作引导,不一定精确按遮罩的形状来;
- 传多张输入图时,遮罩作用在第一张上。
在 Responses 里传输入图,有三种方式:完整网址、Base64 数据 URL、文件 ID,写法和视觉输入一致,见 /guides/openai-api-image-input。
五、限制和被拦截时怎么办
官方列出的局限:复杂提示词可能要处理多达 2 分钟;文字渲染虽然大幅改善,但仍可能在精确摆放和清晰度上出错;同一角色或品牌元素在多次生成间可能不一致;对结构化、版面敏感的构图控制有时不精确。
所有提示词和生成的图片都按官方内容政策过滤。moderation 参数可选 auto(默认,标准过滤)或 low(限制较少)。
出错时的处理:
- 像对待其他 API 错误一样,看 HTTP 状态码或 SDK 异常类型,记录请求 ID;认证、配额、限速、服务器错误见官方错误码页面,也可看 /guides/openai-api-error-codes;
- 有些失败是用户可以修正的,
error.type可能是image_generation_user_error,程序判断请用error.code,例如moderation_blocked; - 不改提示词或输入图,不要自动重试这类错误;配额错误同样不要自动重试;临时的限速和服务器错误可以带退避重试,限速的处理见 /guides/openai-api-429-error;
- 给最终用户看的提示保持笼统,
moderation_details里的阶段(input、output、unknown)和粗粒度类别留给开发者日志。
如果你的应用面向个人用户,官方建议每个请求带上一个稳定、保护隐私的 safety_identifier(对用户名或邮箱做哈希,不超过 128 个字符),推荐但非必需;旧的 user 参数已弃用。
六、费用
官方页面写有每百万 token 的价格,并强调同样的 token 价格不等于每张图同价:不同模型和质量设置消耗的 token 不同,要看响应里的 usage 来衡量。流式输出局部图(partial_images)每张局部图额外增加 100 个图像输出 token。本文不抄价格,以官方价格页当天为准,见 /guides/openai-api-price-official-table。
常见问题
Q:返回的怎么没有图片链接?
GPT Image 返回的是 Base64 数据(b64_json),需要自己解码保存。
Q:提示 organization 需要验证?
官方说使用 GPT Image 模型前可能需要完成 API Organization Verification,在开发者控制台的组织设置里办理,具体看官方帮助文章,本站不代办。
Q:想要矢量图或动图?
官方页面提到 GPT Image 2.6 的 Image API 支持 SVG 和 GIF 输出,对应 output_format 为 svg 或 gif。这些功能较新,本文没有展开,写法以官方当天页面为准。
参考资料
- OpenAI 官方:Image generation — https://developers.openai.com/api/docs/guides/image-generation
0 条评论
还没有评论,来抢沙发~