
本文根据 OpenAI 官方《Rate limits》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 刚开始用 OpenAI API,想知道“为什么我的请求限额这么低”的人;
- 已经遇到 429,想搞清楚限额是怎么定的、能不能提高的人;
- 要上线一个有一定用户量的应用,想提前规划限额的人。
遇到 429 报错时的具体排查,先看 /guides/openai-api-429-error。本文侧重“层级”和“限额从哪里看、怎么变大”。
结论先说
- 限速是为了防滥用、保证公平访问和管理基础设施负载,这是官方给出的三个原因,所有人都有。
- 限速按多种指标同时算,哪个先到哪个触发:请求数每分钟(RPM)、每天(RPD)、token 数每分钟(TPM)、每天(TPD)、图片数每分钟(IPM)等。
- 限额按组织和项目算,不是按个人,并且随模型而不同。
- 官方的层级有四档:Free、Build、Launch、Grow,随你累计购买额度自动升级。
- 自己的具体数字要去后台看:Settings > Organization > Limits 里的 Rate limits。
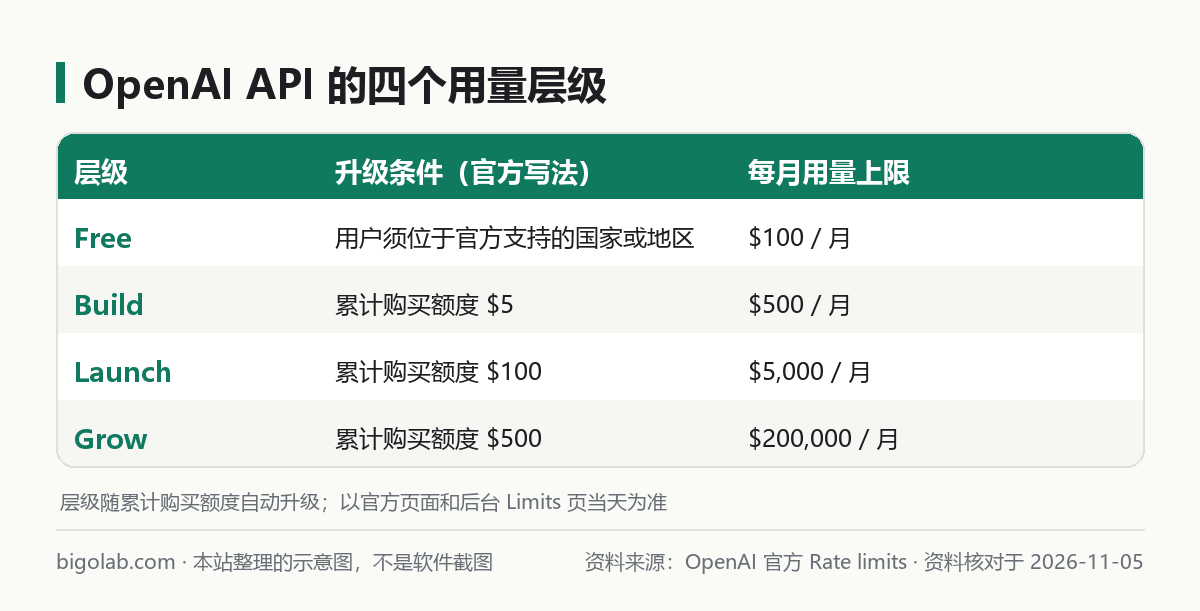
图:本站根据 OpenAI 官方《Rate limits》 整理的示意图
一、几个指标怎么理解
官方举了个例子:你的 RPM 是 20,TPM 是 15 万。你发了 20 个只有 100 token 的请求,虽然没用满 15 万 token,但 RPM 已经满了,照样会被限速。所以不是只看一项。
另外几点官方特别提到:
- 一些长上下文模型有单独的长上下文限额,同样在后台的限额页可以看到;
- 有些模型族共享限额:后台限额页里列在同一个“shared limit”下的模型,调用量一起算;
- Batch API 的排队限额按排队中的输入 token 总数算,批次完成后就不再占用,Batch 写法见 /guides/openai-api-batch。
二、四个用量层级
官方页面 2026-11-05 的层级表:
| 层级 | 官方写的条件 | 每月用量上限 |
|---|---|---|
| Free | 用户必须位于官方允许的地区 | 100 美元 |
| Build | 累计购买额度 5 美元 | 500 美元 |
| Launch | 累计购买额度 100 美元 | 5,000 美元 |
| Grow | 累计购买额度 500 美元 | 200,000 美元 |
官方说:组织的层级会随累计购买额度达到各档门槛而自动升级,层级越高,各模型的限额一般越高。 这里的“累计购买额度”指的是你给 API 账户买过的额度总和,不是你已经花掉的。
地区限制只看官方的支持国家和地区名单,本站不提供任何绕过办法,名单见官方 Supported countries 页面。
三、去哪里看自己的限额
官方指引:进入 Settings > Organization > Limits,在 Rate limits 里可以看到你当前层级下每个模型的限额;要升级层级,在 Usage Tiers 区域点 Upgrade tier。菜单名以英文界面为准。
官方页面还给了一张按层级和模型系列列出 RPM 与 TPM 的表。这些数字和模型系列会随官方更新,本文不照抄,以后台页面和官方当天文档为准。
四、从响应头读到剩余额度
除了后台,每个响应的 HTTP 头里也能读到限额信息:
| 字段 | 含义 |
|---|---|
x-ratelimit-limit-requests | 请求数上限 |
x-ratelimit-remaining-requests | 剩余请求数 |
x-ratelimit-reset-requests | 请求限额重置还要多久 |
x-ratelimit-limit-tokens | token 数上限 |
x-ratelimit-remaining-tokens | 剩余 token 数 |
x-ratelimit-reset-tokens | token 限额重置还要多久 |
Retry-After | 遇到临时限速时,最少要等多少秒再试(出现时) |
官方还有项目级的 token 响应头,在项目有 token 限额时才会出现。Retry-After 可能出现在 429(临时限速)和 503(临时模型过载)的响应上,它不代表额度或账单类错误靠重试能解决。
五、限速和花费上限不是一回事
官方把两个概念分开:
- 限额(rate limit):每分钟请求或 token 数的速度限制;
- 花费控制(spend limits):你可以给组织或项目设月度花费。官方列了两种:Spend alert 只发通知,API 流量继续;Hard spend limit 达到设定金额后,受影响的请求会返回
429。
所以看到 429 不一定是限速,也可能是你自己设的硬性花费上限到了,先到后台确认。账单怎么看见 /guides/openai-api-pricing-billing,价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。
另外,官方还说 OpenAI 会为每个组织设一个批准的月度用量上限,这和你自己设的花费上限是分开的。
六、两种新的限速错误
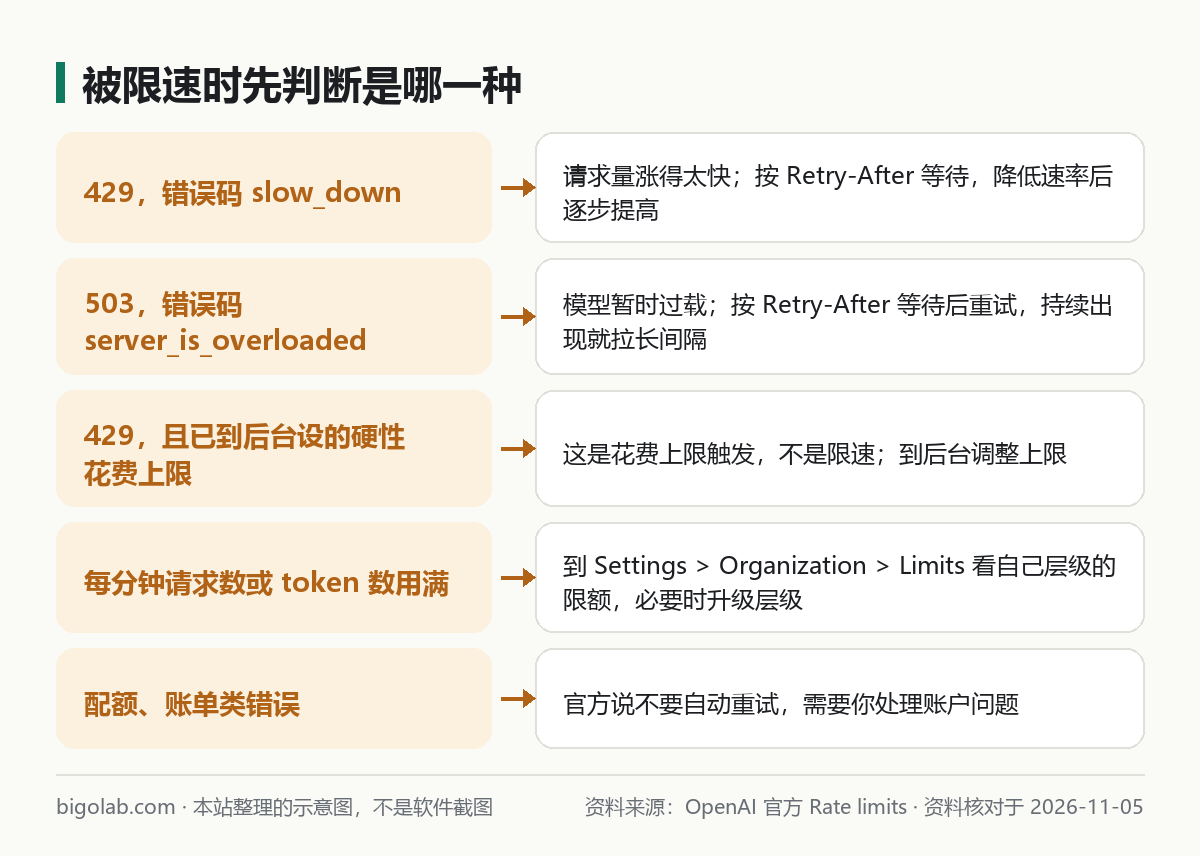
图:本站根据 OpenAI 官方《Rate limits》 整理的示意图,判断表为本站归纳
官方页面说明:
- 429 +
slow_down(错误类型rate_limit_error):你的请求速度涨得太快。即使每分钟请求数和 token 数都没超,也可能触发,因为它衡量的是增长速度。官方的经验法则:流量到每分钟 100 万输入 token 之后,每 15 分钟的增幅不要超过 50%,具体拐点因模型和流量而异; - 503 +
server_is_overloaded(错误类型service_unavailable_error):请求的模型暂时过载。有Retry-After就照做,持续出现就拉长重试间隔。
官方建议错误处理要同时看 HTTP 状态码和 error.code,两个都要处理。
七、让限额“够用”的做法
以下做法来自官方同一页:
- 指数退避加随机抖动:遇到 429 等一小会再试,每次失败后等待时间加长,并加一点随机延迟,避免大家同时重试。官方说官方 SDK 会自动重试可重试的 429 和 503,但对
Retry-After的处理随 SDK 版本不同,不要想当然;应用里自己做重试时,要关掉 SDK 的重试或把它计入上限,免得重试叠加; - 别疯狂重发:失败的请求同样会计入每分钟限额;
- 把
max_output_tokens设成接近实际需要的值:官方说你的限额占用按“max_tokens 与按请求字符数估算的 token 数两者中较大的那个”计算,所以设得越接近实际回答长度越好; - 用 Batch API 处理不急的任务:Batch 有独立的限额池,不占用常规的按模型限额;
- 别向不可信的用户开放程序化访问或批量功能:官方建议给单个用户设置时间段内的使用上限,超限的用户做硬性截止或人工审核。
想提高层级,唯一官方写明的路径就是累计购买额度达到门槛;除此之外官方这一页没有提供申请提额的入口,需要更高限额的企业用户官方提到可以了解 Scale Tier 或 Reserved Tier,具体以官方页面为准。
常见问题
Q:我刚充了一点钱,为什么限额没变?
层级是按累计购买额度自动升级的,如果刚好没到门槛,就不会升。先到 Limits 页看当前层级和限额。
Q:限额是按 API Key 算的吗?
不是。官方说限额在组织和项目层面定义,不是用户层面。
Q:我一直是 429,也没设花费上限?
看响应里的 error.code 和响应头,区分 slow_down、限额用满、配额或账单问题;配额和账单类错误官方说不要自动重试。
参考资料
- OpenAI 官方:Rate limits — https://developers.openai.com/api/docs/guides/rate-limits
0 条评论
还没有评论,来抢沙发~