
本文根据 OpenAI 官方《Getting started with the Realtime API》和《Realtime conversations》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 听说过 Realtime API,但搞不清它和普通的 Responses 请求、语音转写有什么区别的人;
- 想做语音助手、电话机器人、可以随时打断的对话界面的开发者;
- 读到官方说文字转语音接口要弃用、想知道“官方推荐的方向”长什么样的人。
结论先说
- Realtime API 是做“语音到语音”对话的接口:官方说,模型直接处理音频,保持对话状态,还能调用工具。
- 适合“像聊天一样即时”的交互:官方点名的特性是可以打断(barge-in)、首个音频延迟低、自然轮流发言、实时工具调用。
- 它是有状态的会话(session),通过事件通信,不是“一次请求一次响应”的写法。
- 浏览器里用 WebRTC,服务器里用 WebSocket,浏览器不能拿长期密钥,要由你的服务器签发临时密钥。
- 一次会话最长 60 分钟。
- 不需要对话、只想把声音变成文字,用转写模式或文件转写,不用这套。
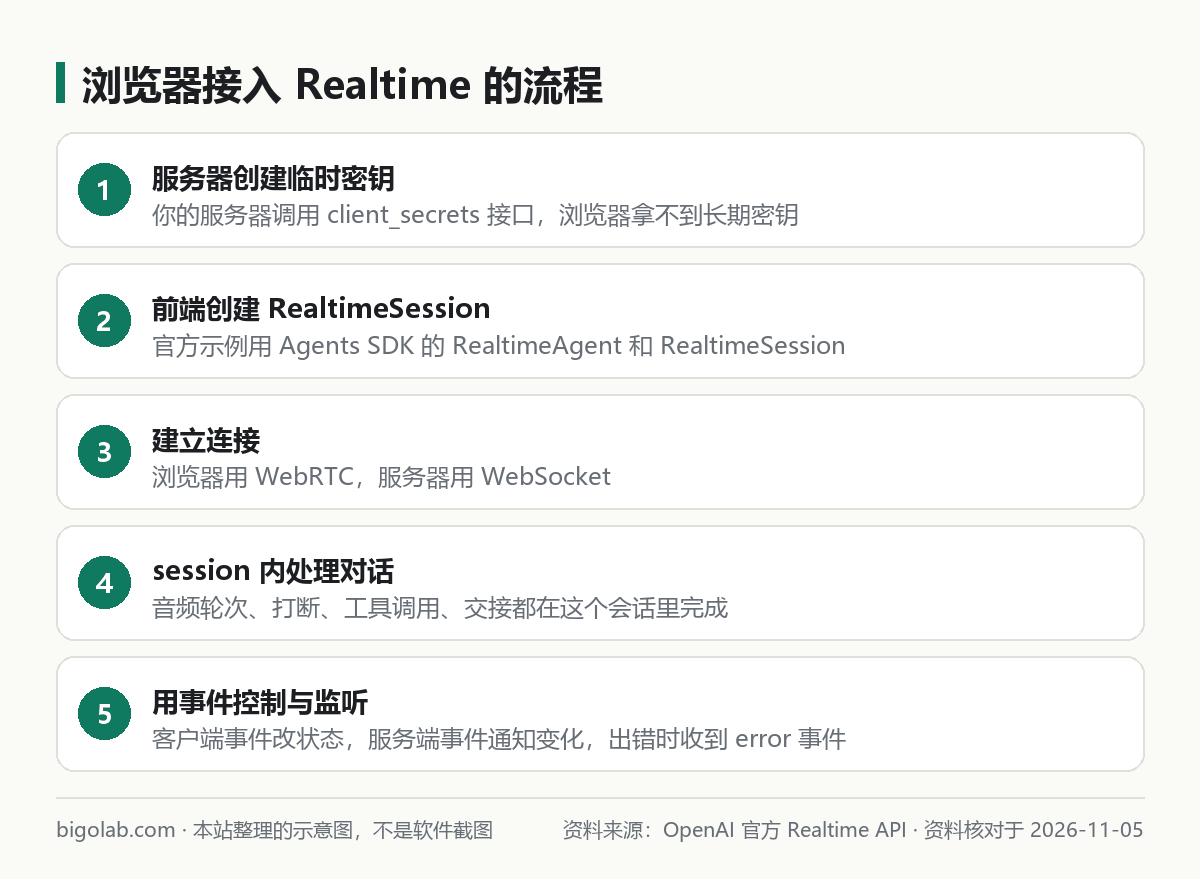
图:本站根据 OpenAI 官方《Getting started with the Realtime API》 整理的示意图
一、和普通请求有什么不同
之前的文章里,无论是 /guides/openai-responses-api 还是流式输出,都是“你发一个请求,模型回一个响应”。Realtime 不一样,官方把它描述成一个有状态的会话,有三个组成部分:
- Session(会话对象):控制交互的参数,比如用哪个模型、哪种声音、其他配置;
- Conversation(对话):当前会话里的用户输入项和模型输出项;
- Response(响应):模型生成的音频或文字项,加入对话。
你用客户端事件去改变会话状态,用服务端事件去响应状态的变化。如果用 WebRTC,大部分音频采集和播放可以由浏览器的 WebRTC 接口代劳;如果用 WebSocket 传音频,你需要手动处理输入音频缓冲区,把 Base64 编码的音频放进 JSON 事件里发给服务器。
二、官方的浏览器接入流程
官方入门页用 Agents SDK 的 JavaScript 版演示。四步:
- 你的应用服务器为这次 Realtime 会话创建一个临时客户端密钥(ephemeral client secret);
- 前端创建
RealtimeSession; - 会话在浏览器里通过 WebRTC 连接,在服务器上通过 WebSocket 连接;
- 代理在这个会话内处理音频轮次、工具、打断和交接。
官方示例:
javascript
import { RealtimeAgent, RealtimeSession } from "@openai/agents/realtime";

const agent = new RealtimeAgent({
  name: "Assistant",
  instructions: "You are a helpful voice assistant.",
});

const session = new RealtimeSession(agent, {
  model: "gpt-realtime-2.1", // 以官方模型页当天为准
});

await session.connect({
  apiKey: "ek_...(来自你服务器的临时密钥)",
});要点:apiKey 填的是你服务器签发的临时密钥,不是你的 OpenAI 长期 Key。 长期 Key 的保管见 /guides/openai-api-key,绝不能写进网页。官方建议把传输细节放在 session 层,把业务逻辑放在代理定义里,工具、交接和护栏的加法和文本代理一样。如果需要更底层的控制,官方有 WebRTC 和 WebSocket 的专门连接指南,本文不展开。
三、事件和 session.update
会话建立后,服务器会先发一个 session.created 事件,说明会话准备好了。之后你可以用 session.update 事件修改配置,服务器回 session.updated,里面是新的状态。官方说明:
- 大多数属性可以随时更新,唯一的例外是
voice:模型在会话里输出过一次音频之后,就不能再改声音了; - 在
session.update里,官方示例设置了output_modalities(["audio"]或["text"],Python 示例注释里写明二选一、不要组合)、输入输出音频格式、turn_detection(如semantic_vad)、instructions等; - 出现错误时,服务器会发
error事件。和 HTTP 不同,这里没有天然的一问一答,所以客户端事件要带上event_id,出错时服务器返回的错误里会带回同一个event_id,你才知道是哪个事件出了问题。
官方当前可用的声音:alloy、ash、ballad、coral、echo、sage、shimmer、verse、marin、cedar,推荐 marin 或 cedar。
四、它和别的音频接口怎么分工
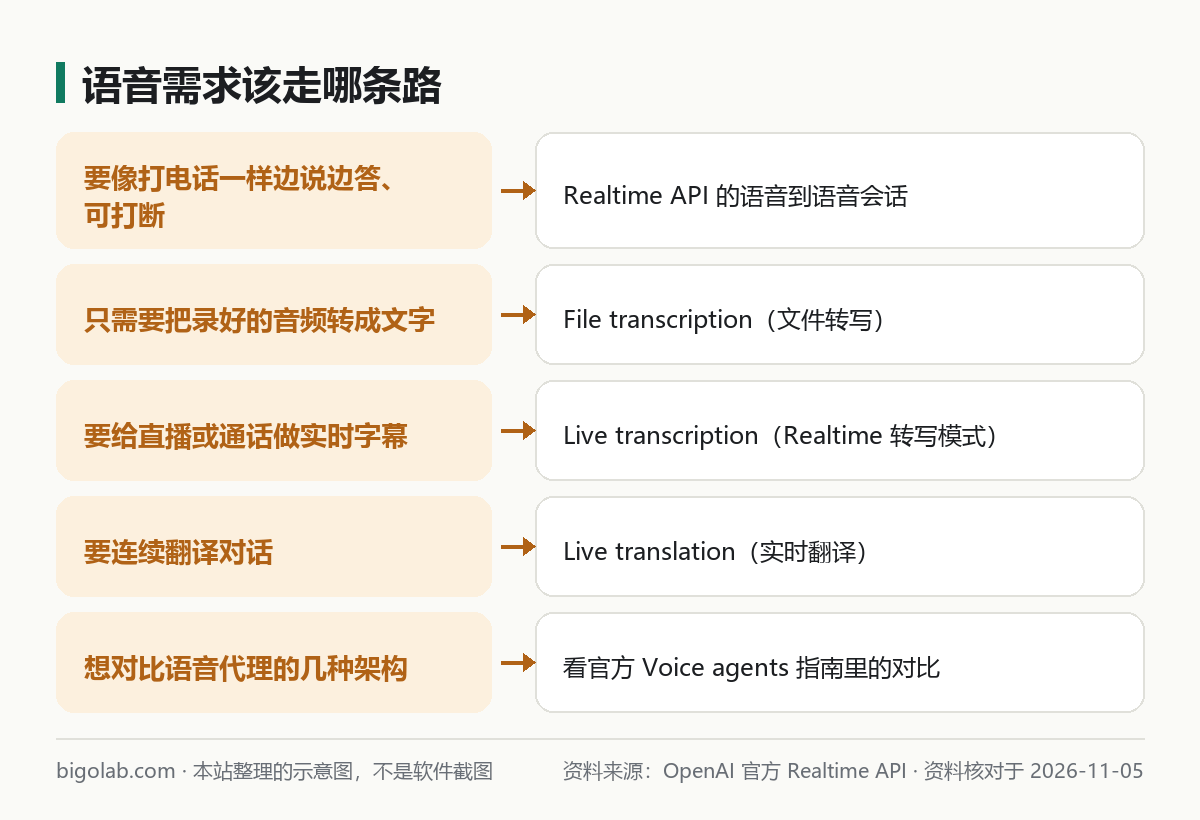
图:本站根据 OpenAI 官方《Getting started with the Realtime API》 整理的示意图
官方入门页末尾给出了其他音频工作流的去向:
- 连续翻译:用 Live translation;
- 实时字幕:用 Live transcription,也就是 Realtime 的转写模式;
- 录好的音频转写:用 File transcription,写法见 /guides/openai-api-speech-to-text-text-to-speech。
官方在《Realtime conversations》里也说:如果你不需要和模型对话,也就是不指望得到回应,可以用转写模式。
和文字转语音的关系:官方 Text to speech 页说,tts-1、tts-1-hd、gpt-4o-mini-tts 已弃用,将在 2027 年 1 月 6 日停止服务,迁移方向是 Realtime API 里的 gpt-realtime-2.1-mini,并强调这是工作流的变化,不是改个模型名。也就是说,要做语音输出的新项目,需要把思路换成 Realtime 会话。
五、官方的几个提醒
安全标识。 应用如果能识别个人用户,官方推荐(不强制)在 Realtime 请求里带 OpenAI-Safety-Identifier 请求头,用稳定、保护隐私的值,例如内部用户 ID 的哈希。使用临时令牌时,要在你服务器上创建客户端密钥的那个请求里设置这个头。官方强调这个标识不会从 Responses 请求沿用,每次创建或连接 Realtime 会话都要传。
从 Beta 迁移到 GA。 如果你手上还有 Beta 版 Realtime 集成,官方要求先迁移到 GA 再做新工作。主要变化:去掉 OpenAI-Beta: realtime=v1 请求头;用 POST /v1/realtime/client_secrets 为浏览器或手机客户端创建临时凭据;WebRTC 用 /v1/realtime/calls;会话和事件的结构也有调整,比如要设置 session.type、输出音频配置放到 session.audio.output 下、使用 response.output_text.delta、response.output_audio.delta 之类的新事件名。
成本。 Realtime 的计费方式(包括缓存)官方有专门的 Cost optimization 页面,价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。
常见问题
Q:Realtime 只能做语音吗?
不是。官方《Realtime conversations》讲了文字输入输出、图片输入和函数调用,会话里可以只要文字输出,也可以只要音频输出。
Q:我的服务器上能直接连吗?
可以,官方说服务器用 WebSocket;浏览器用 WebRTC。两种方式在官方都有专门指南。
Q:连接被限流或报错?
通用的限速处理见 /guides/openai-api-429-error,限额与层级见 /guides/openai-api-usage-tiers-rate-limits。
参考资料
- OpenAI 官方:Getting started with the Realtime API — https://developers.openai.com/api/docs/guides/realtime
- OpenAI 官方:Realtime conversations — https://developers.openai.com/api/docs/guides/realtime-conversations
0 条评论
还没有评论,来抢沙发~