
本文根据 OpenAI 官方《File transcription》和《Text to speech》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天页面,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 想把会议录音、访谈、课程音频转成文字的开发者;
- 想给自己的应用加朗读功能,又看到网上教程里的
tts-1、whisper-1不知道还能不能用的人; - 已经能发出第一个请求(见 /guides/openai-api-python-quickstart)的人。
结论先说
- 语音转文字:官方现在推荐用
gpt-transcribe转写已经录好的语音,端点是/v1/audio/transcriptions。 - 旧模型在走向停服:
whisper-1、gpt-4o-transcribe、gpt-4o-mini-transcribe、gpt-4o-transcribe-diarize和/v1/audio/translations官方标为弃用,将在 2027 年 2 月 26 日停止服务。 - 文字转语音:
tts-1、tts-1-hd、gpt-4o-mini-tts同样已弃用,将在 2027 年 1 月 6 日停止服务,官方指向 Realtime API。 - 文件上限 25 MB,支持 mp3、mp4、mpeg、mpga、m4a、wav、webm。
- 以上日期和推荐都以官方当天页面为准,这类接口变化比较快,写代码前先看一眼官方弃用公告。
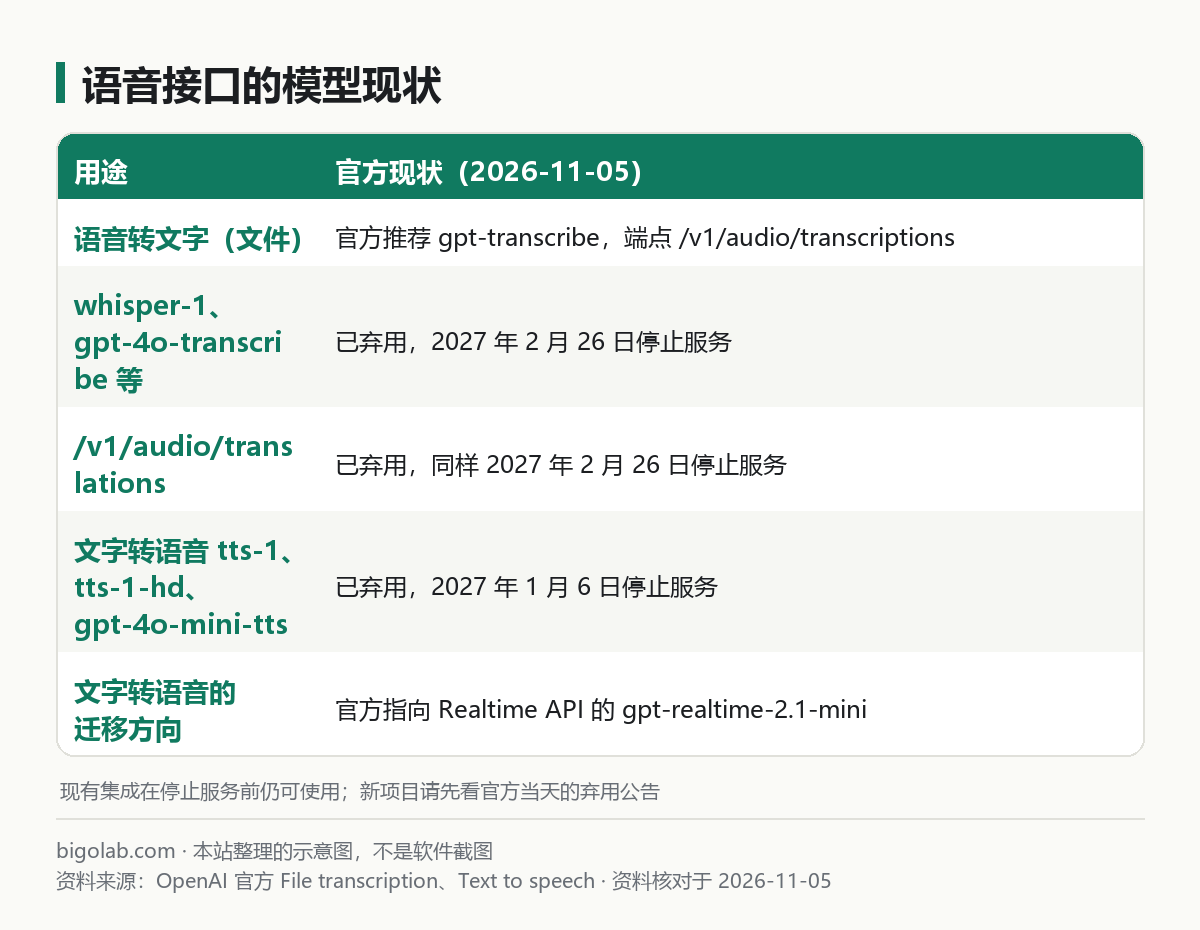
图:本站根据 OpenAI 官方《File transcription》 和 《Text to speech》 整理的示意图
一、语音转文字:最短的例子
Python:
python
from openai import OpenAI

client = OpenAI()

with open("audio.wav", "rb") as audio_file:
    transcription = client.audio.transcriptions.create(
        model="gpt-transcribe",  # 以官方模型页当天为准
        file=audio_file,
    )

print(transcription.text)
Node.js(保存为 .mjs):
javascript
import fs from "fs";
import OpenAI from "openai";

const openai = new OpenAI();

const transcription = await openai.audio.transcriptions.create({
  file: fs.createReadStream("audio.wav"),
  model: "gpt-transcribe", // 以官方模型页当天为准
});

console.log(transcription.text);
官方说,返回的 JSON 里有转写文本,也有检测到的语言,比如:
json
{
  "text": "Bonjour, pouvez-vous m'entendre ?",
  "languages": [{ "code": "fr" }]
}
当模型无法可靠判断语言时,会返回 "languages": []。
二、让专有名词更准:prompt、keywords、languages
官方给 gpt-transcribe 提供了三个辅助信息:
prompt:关于这段录音的非结构化背景,比如“一通关于高级套餐和账号 AC-42 的客服电话”;keywords:你预期会听到的字面词;languages:预期的输入语言。
Python 示例(官方写法,keywords 和 languages 通过 extra_body 传):
python
with open("meeting.wav", "rb") as audio_file:
    transcription = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=audio_file,
        prompt="一通关于高级套餐和账号 AC-42 的客服电话。",
        extra_body={
            "keywords": ["高级套餐", "AC-42", "账单"],
            "languages": ["zh-cn", "en"],
        },
    )
print(transcription.text)
注意几条官方规则:
- 关键词只是提示,不是必须出现的输出。只放相关的词,并自己评估它们有没有让准确度变好,同时没有让没说过的词冒出来;
- 对
gpt-transcribe,languages(复数)取代旧的language,两个不要同时发; - 每个关键词必须单独一行,不能含
<、>、回车或换行; - 只要触犯上面的字符规则,或者
prompt超过模型的长度限制,整个请求会被拒绝; languages的格式:ISO 639-1 代码(如en、es、fr)、部分 ISO 639-3 代码(如yue、cmn),以及地区性的中文代码(如zh-cn、zh-tw、zh-hk);不支持或格式错的代码会被拒绝。示例里的zh-cn取自官方列出的格式,具体哪些代码可用以官方当天文档为准。
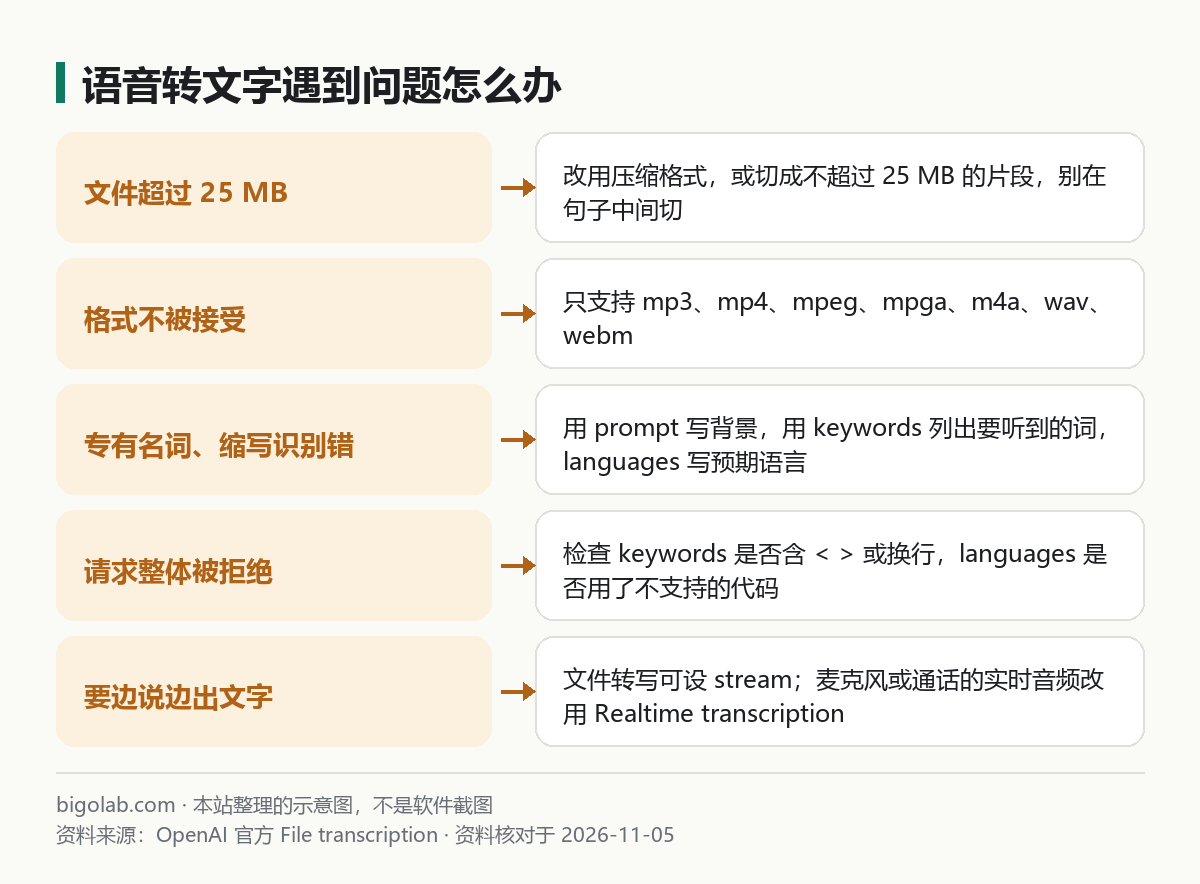
图:本站根据 OpenAI 官方《File transcription》 整理的示意图,处理办法为本站补充
三、文件超过 25 MB 怎么办
官方说:转写接口接受最大 25 MB 的文件。更大的录音,用压缩格式,或者切成每块不超过 25 MB 的片段。不要在一句话中间切开,那样会丢失上下文、降低准确度。官方示例用的是开源 Python 包 PyDub 来切分(官方注明不对第三方软件的可用性和安全性做保证):
python
from pydub import AudioSegment

song = AudioSegment.from_wav("good_morning.wav")
ten_minutes = 10 * 60 * 1000          # PyDub 以毫秒计时
first_10_minutes = song[:ten_minutes]
first_10_minutes.export("good_morning_10.wav", format="wav")
分段转写后,如果想让后一段延续前一段的上下文,官方在提示词一节说过可以把上一段的内容作为背景使用,具体做法以官方当天文档为准。
四、边转写边出文字
官方说,对已经录好的文件也可以流式返回:设 stream=True,会先收到一串 transcript.text.delta 事件,最后收到包含完整文本的 transcript.text.done 事件,对 gpt-transcribe,最终事件里还会带检测到的语言。事件循环的写法和文字流式一样,见 /guides/openai-api-streaming。
麦克风、通话这种还在持续到来的音频,官方明确说要用 Realtime transcription,而不是上面的文件流式。Realtime 的概念见 /guides/openai-api-realtime。
五、文字转语音:官方已标为弃用
官方 Text to speech 页顶部的提示:tts-1、tts-1-hd、gpt-4o-mini-tts 已弃用,2027 年 1 月 6 日停止服务;请迁移到 Realtime API 里的 gpt-realtime-2.1-mini。官方强调,这是 API 工作流的变化,gpt-realtime-2.1-mini 不是 /v1/audio/speech 支持的模型,不能只改个模型名。现有集成在停服前仍可使用下面的 speech 接口。
官方页上仍保留的现有写法(Python):
python
from pathlib import Path
from openai import OpenAI

client = OpenAI()
speech_file_path = Path("speech.mp3")

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",   # 已弃用,仅供现有集成参考
    voice="coral",
    input="今天是做点大家喜欢的东西的好日子。",
    instructions="用愉快积极的语气说。",
) as response:
    response.stream_to_file(speech_file_path)
官方对这个接口的说明:默认输出 MP3,也支持 opus、aac、flac、wav、pcm;声音(voice)有 13 种,官方说目前针对英语优化,也能生成其他语言;追求最快响应推荐 wav 或 pcm 格式。
还有一条使用政策:官方使用政策要求你向终端用户明确披露,他们听到的 TTS 声音是 AI 生成的,而不是真人。
新项目如果需要语音输出,本文不给出自写的替代方案,因为官方的替代方向走 Realtime,工作流不同,请直接看官方 Realtime 指南。
六、翻译接口
/v1/audio/translations(把录音翻译成英文)已弃用,到 2027 年 2 月 26 日停止服务。官方说迁移目标是 Realtime translation,而且它需要翻译会话、流式音频输入和翻译事件,只改模型名并不等于迁移完成。
常见问题
Q:我看到的教程里用 whisper-1,还能用吗?
官方写的是弃用、将在 2027 年 2 月 26 日停止服务,停服前现有集成仍可使用。新项目建议从 gpt-transcribe 开始。
Q:需要说话人区分、逐词时间戳、字幕格式怎么办?
官方说这些专门示例目前用的是弃用模型,仅为现有集成保留到停服。需要时按官方当天的转写工作流页面选择当前方案。
Q:转写要花多少钱?
价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。
参考资料
- OpenAI 官方:File transcription — https://developers.openai.com/api/docs/guides/speech-to-text
- OpenAI 官方:Text to speech — https://developers.openai.com/api/docs/guides/text-to-speech
0 条评论
还没有评论,来抢沙发~