
本文根据 OpenAI 官方《Batch API》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 有一大批不需要马上出结果的任务:给几千条评论分类、跑一遍评测、给内容库批量做向量;
- 同步请求被限速卡住(见 /guides/openai-api-429-error),想换一条独立限额的通道的人;
- 想在不改提示词的前提下降低成本的人。
结论先说
- Batch API 是异步的:你把一批请求写进一个
.jsonl文件,上传后创建批处理,过一阵再取结果。 - 官方在页面上写明三个好处:费用比同步接口低 50%;有独立的、高得多的限速池;每个批次 24 小时内完成,往往更快。这是官方 2026-11-05 的写法,价格以官方页面当天为准,见 /guides/openai-api-price-official-table。
- 不适合要立刻看到结果的场景,比如聊天。
- 结果顺序可能和输入不同,必须用每个请求里的
custom_id来对应。 - 同一个输入文件只能用一个模型。
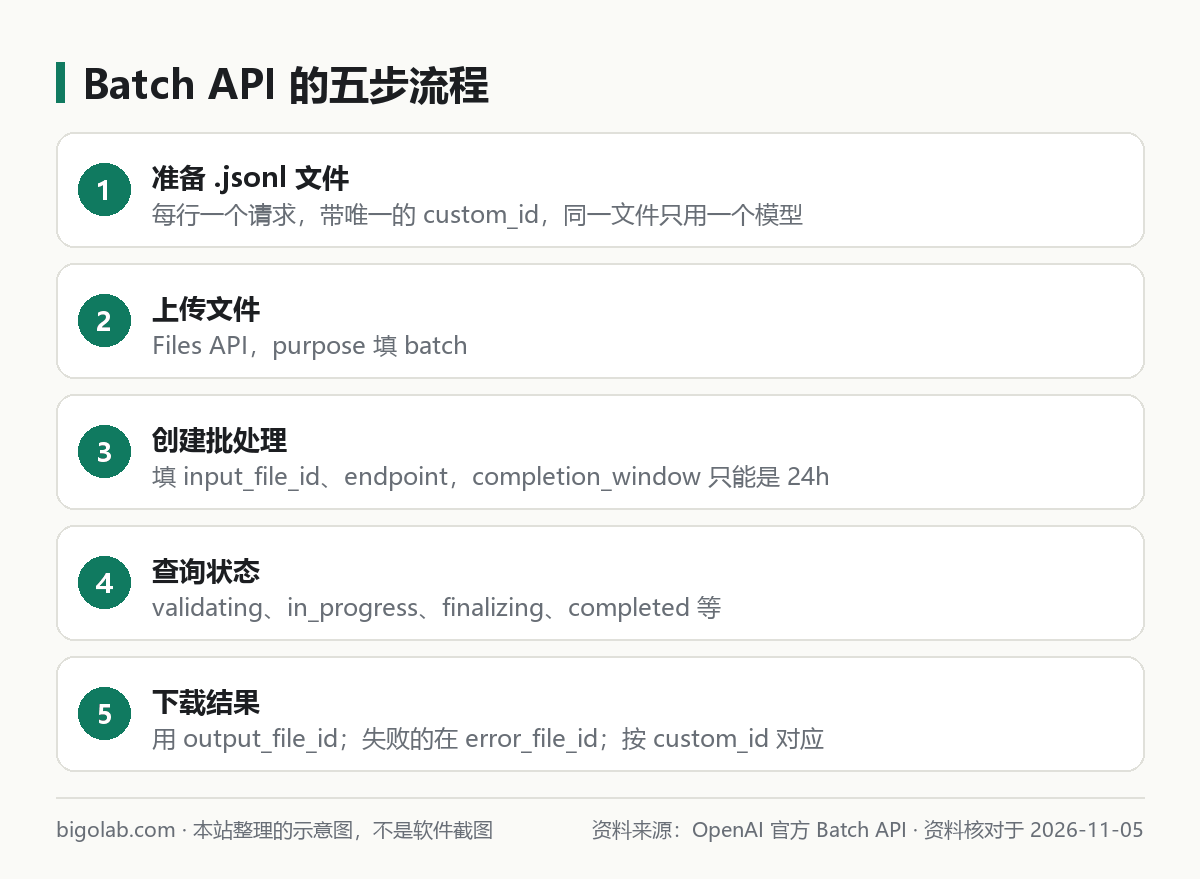
图:本站根据 OpenAI 官方《Batch API》 整理的示意图
一、准备 jsonl 文件
jsonl 是“每行一个 JSON”。每行是一个完整请求,含 custom_id(你自己起的唯一编号)、method、url 和 body。body 里的参数就和直接调用那个端点时一样。官方的两行示例:
{"custom_id": "request-1", "method": "POST", "url": "/v1/responses", "body": {"model": "gpt-6-luna", "input": "Reply with the word blue.", "reasoning": {"effort": "none"}, "max_output_tokens": 64}}
{"custom_id": "request-2", "method": "POST", "url": "/v1/responses", "body": {"model": "gpt-6-luna", "input": "Reply with the word green.", "reasoning": {"effort": "none"}, "max_output_tokens": 64}}官方列出的可用端点有:/v1/responses、/v1/chat/completions、/v1/embeddings、/v1/completions、/v1/moderations、/v1/images/generations、/v1/images/edits。
几条规矩:
- 每个
custom_id必须唯一; - 一个文件只能含一个模型的请求,要用两个模型就拆成两个批次;
- 做 embeddings 时,一个批次的嵌入输入总数同样最多 50,000;
- 带图片时,官方建议尽量用
image_url引用远程图,而不是把 Base64 内容塞进文件,免得文件超过 200 MB 的上传上限。
二、一份完整的 Python 脚本
下面把官方的几个步骤按顺序串起来。轮询等待和解析结果的部分是本站补充:
python
import json
import time
from openai import OpenAI

client = OpenAI()

# 1. 上传输入文件,purpose 要填 batch
batch_input_file = client.files.create(
    file=open("batchinput.jsonl", "rb"),
    purpose="batch",
)

# 2. 创建批处理,completion_window 目前只能是 24h
batch = client.batches.create(
    input_file_id=batch_input_file.id,
    endpoint="/v1/responses",
    completion_window="24h",
    metadata={"description": "nightly eval job"},
)
print("批次编号:", batch.id, "状态:", batch.status)

# 3. 定时查询状态(也可以过几小时再手动查)
while batch.status in ("validating", "in_progress", "finalizing"):
    time.sleep(60)
    batch = client.batches.retrieve(batch.id)
    print("状态:", batch.status)

# 4. 读取结果;输出顺序可能和输入不同,用 custom_id 对应
if batch.output_file_id:
    text = client.files.content(batch.output_file_id).text
    for line in text.splitlines():
        row = json.loads(line)
        body = row["response"]["body"]
        for item in body["output"]:
            if item["type"] == "message":
                print(row["custom_id"], item["content"][0]["text"])

# 5. 失败的请求在 error_file_id 里
if batch.error_file_id:
    print(client.files.content(batch.error_file_id).text)
Node.js 的调用方法名对应是 openai.files.create、openai.batches.create、openai.batches.retrieve、openai.files.content,参数名与上面一致,官方页面有各步骤的 Node 示例。
三、状态有哪些
官方列出的状态:
validating:正在校验输入文件;failed:输入文件没有通过校验;in_progress:校验通过,正在运行;finalizing:已跑完,正在准备结果;completed:完成,结果可取;expired:24 小时窗口内没跑完;cancelling:正在取消,最长可能要 10 分钟;cancelled:已取消。
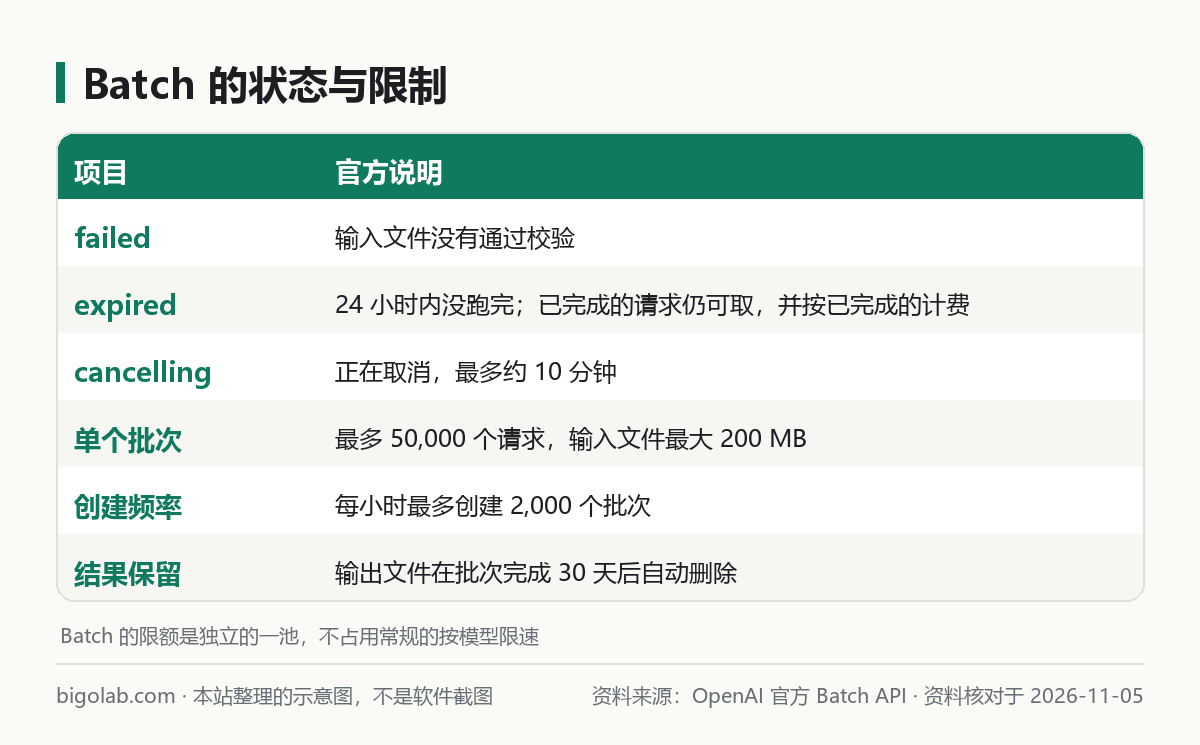
图:本站根据 OpenAI 官方《Batch API》 整理的示意图
四、结果和失败的请求
输出文件里,成功的请求每个对应一行,里面有 custom_id 和 response。失败的请求信息写在错误文件里,通过批次对象的 error_file_id 取。官方还说:输出文件会在批次完成 30 天后自动删除,需要的话要及时下载保存。
结果里的文字要从 response.body.output 里读 output_text 内容,这对应上面脚本里的解析部分。
五、过期与取消
- 取消:调用取消后状态先变成
cancelling,等执行中的请求结束(最长约 10 分钟)后变成cancelled; - 过期:没在 24 小时内完成的批次进入
expired,未完成的请求被取消;已经完成的请求结果仍在输出文件里,这部分消耗的 token 会计费。过期的请求会写进错误文件,错误码是batch_expired,可以用custom_id找回它们的原始请求,再重新提交。
六、限额
官方说 Batch 有独立的限速池,有三类限制:
- 单个批次:最多 50,000 个请求,输入文件最大 200 MB;
- 每个模型的排队 prompt token 数:具体数字在平台设置里的限额页面查看;
- 创建频率:每小时最多创建 2,000 个批次。请求更多时,应该增加每个批次里的请求数,而不是多建批次。
官方还说目前没有输出 token 的上限,并且用 Batch 不会消耗你常规的按模型限速额度,所以它也是提高处理量的一个办法。想知道自己账号的层级和提额条件,见 /guides/openai-api-usage-tiers-rate-limits。
常见问题
Q:所有模型都支持 Batch 吗?
官方说大多数模型支持,具体看模型参考页。图像生成方面,官方页面列出了 GPT Image 系列的部分模型支持批量生成和编辑,名称以官方当天页面为准。
Q:批次一直是 validating 或最后 failed?
failed 表示输入文件没通过校验。先检查 jsonl 是不是每行一个完整 JSON、custom_id 是否重复、整个文件是否只有一个模型、url 是否和创建批处理时的 endpoint 一致。这几条里前三条来自官方规则,最后一条是本站的合理推断,官方没有逐条列出校验项。
Q:能随时看到进度吗?
批次对象里有 request_counts,包含总数、已完成数、失败数,查询状态时可以一并看到。
Q:怎么用 Batch 做向量化?
端点选 /v1/embeddings,向量的用法见 /guides/openai-api-embeddings。
参考资料
- OpenAI 官方:Batch API — https://developers.openai.com/api/docs/guides/batch
0 条评论
还没有评论,来抢沙发~