
本文根据 OpenAI 官方《Vector embeddings》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 想给自己的文档、客服问答、笔记做“按意思搜索”的开发者;
- 听说过 RAG、向量数据库,但不知道第一步“生成向量”到底怎么调的人;
- 想知道向量模型选哪个、向量太长怎么缩短的人。
结论先说
- embedding 就是一串浮点数。 官方说,两个向量的距离衡量两段文字的相关度:距离小表示相关度高,距离大表示相关度低。
- 调用很简单:
embeddings.create,给模型名和文本,拿回向量。 - 官方的两个第三代模型是
text-embedding-3-small和text-embedding-3-large,默认向量长度分别是 1536 和 3072。 - 可以用
dimensions参数缩短向量,省存储和计算。 - 距离函数官方推荐余弦相似度;OpenAI 的向量已经归一化到长度 1,所以用点积算余弦更快,排序结果也和欧氏距离一致。
- 按输入的 token 数计费。 价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。
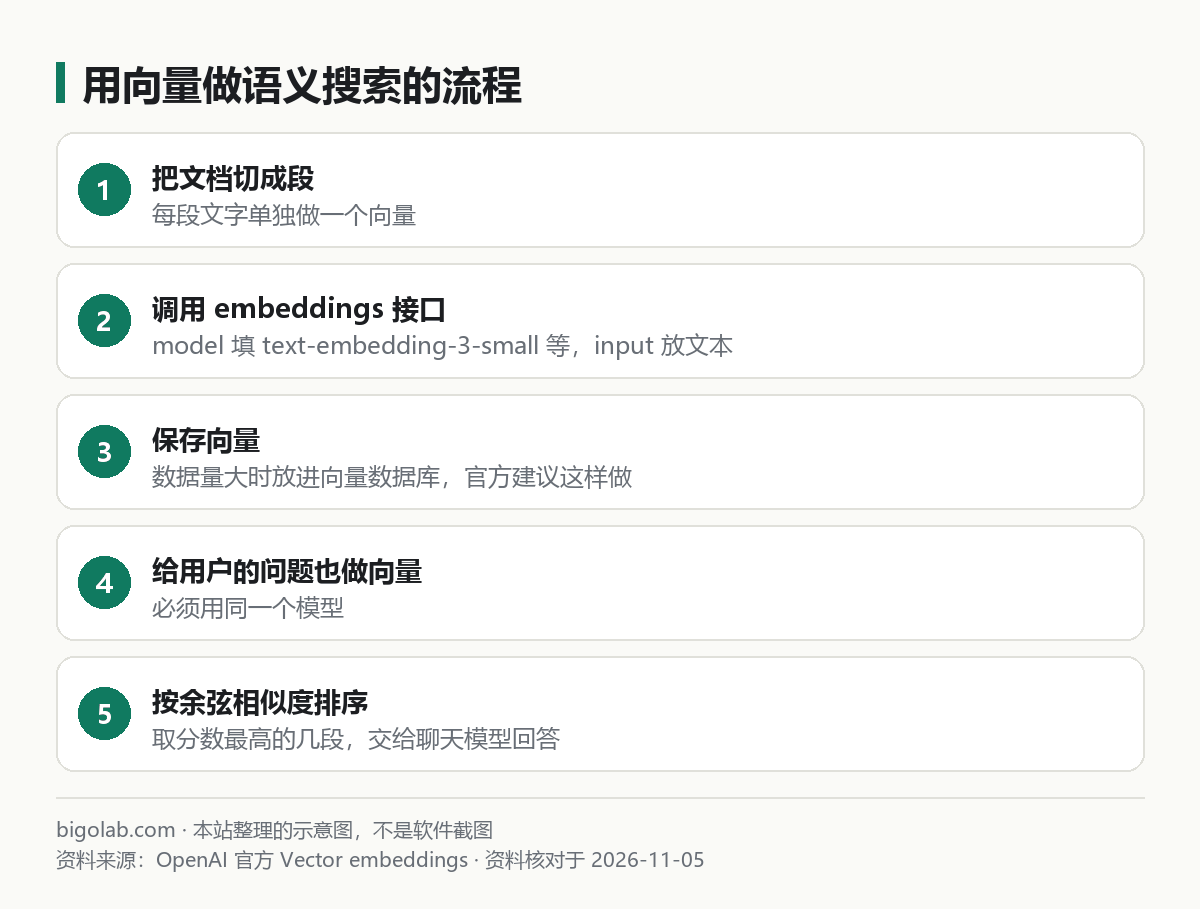
图:本站根据 OpenAI 官方《Vector embeddings》 整理的示意图,流程顺序为本站归纳
一、第一次调用
Python(需 pip install openai,密钥设置见 /guides/openai-api-python-quickstart):
python
from openai import OpenAI

client = OpenAI()

response = client.embeddings.create(
    input="你好,这里是要变成向量的文字",
    model="text-embedding-3-small",
)

vector = response.data[0].embedding
print(len(vector))   # 默认 1536
print(vector[:5])
Node.js(保存为 .mjs):
javascript
import OpenAI from "openai";

const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "你好,这里是要变成向量的文字",
  encoding_format: "float",
});

console.log(embedding.data[0].embedding.length);
响应里的 data[0].embedding 就是向量,usage 里有这次消耗的 token 数。你可以把向量存进向量数据库,之后用于各种用途。input 也可以一次传一个字符串列表,官方的数据集示例就是这样一次嵌入多条文字(示例里先把换行符换成空格再嵌入)。
二、选哪个模型
官方页面的对照:
| 模型 | 官方表中的 MTEB 成绩 | 最大输入 |
|---|---|---|
| text-embedding-3-small | 62.3% | 8192 |
| text-embedding-3-large | 64.6% | 8192 |
| text-embedding-ada-002 | 61.0% | 8192 |
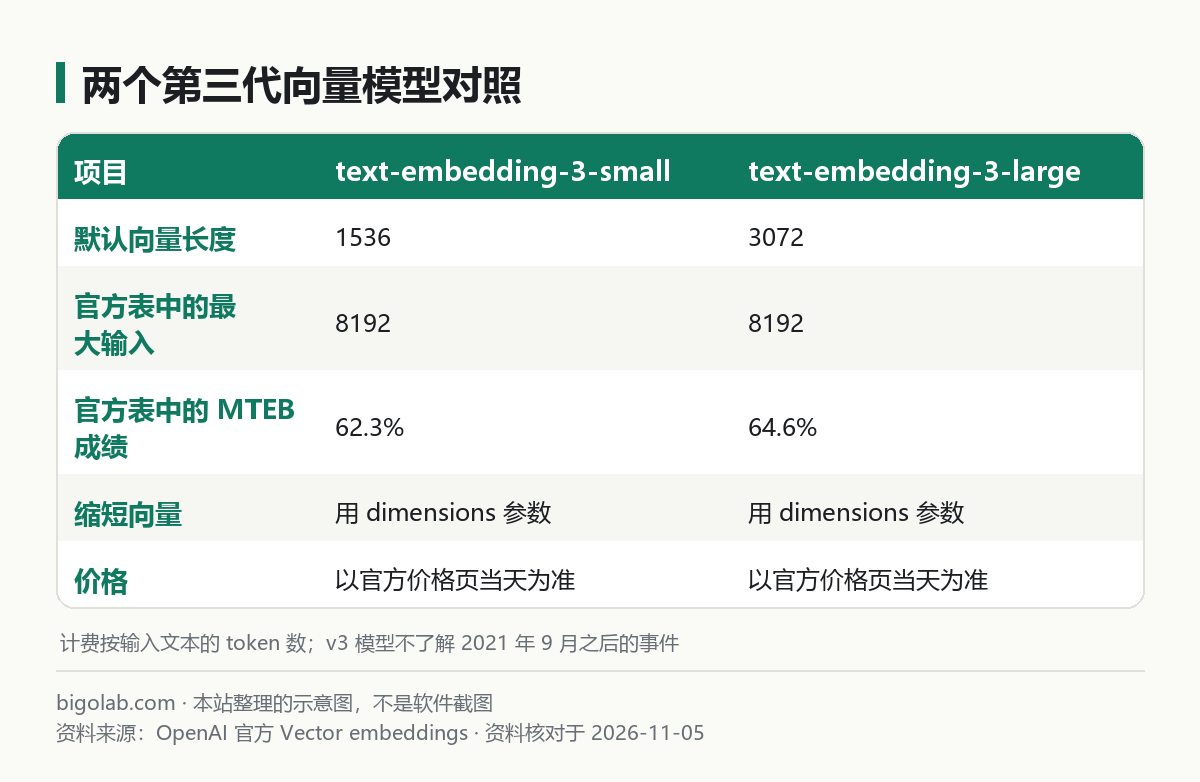
图:本站根据 OpenAI 官方《Vector embeddings》 整理的示意图
官方说它提供两个第三代向量模型(模型名里带 -3)。更大的模型成绩更高但更贵,具体费用以官方价格页当天为准。同一个知识库里,文档和问题必须用同一个模型生成向量,不同模型的向量不能互相比较,这一条是向量搜索的基本要求,官方示例也都是同模型比较。
三、dimensions:缩短向量
向量越长,存储、内存和计算越贵。官方说两个新模型的训练方式允许你去掉向量末尾的一部分数字,而不丢失它表示概念的能力,做法是在请求里加 dimensions 参数:
python
response = client.embeddings.create(
    model="text-embedding-3-large",
    input="需要更短的向量",
    dimensions=1024,
)
print(len(response.data[0].embedding))  # 1024
官方给的例子:向量数据库只支持最多 1024 维时,仍然可以用 text-embedding-3-large,把 dimensions 设为 1024,用一点准确度换更小的向量。官方还说,在 MTEB 评测上,text-embedding-3-large 缩短到 256 维,成绩仍高于未缩短的 text-embedding-ada-002(1536 维)。
如果你是生成之后手动截断,必须再做一次归一化(L2),官方的示例就是先取前 256 个数,再除以向量长度。能在请求时用 dimensions 就用它,官方说这是推荐做法。
四、一个最小的语义搜索
下面是本站写的最小版本,思路对应官方「用 embeddings 做文本搜索」:先给所有文档生成向量,再给问题生成向量,按余弦相似度排序。因为 OpenAI 向量长度已是 1,直接用点积即可:
python
import numpy as np
from openai import OpenAI

client = OpenAI()
MODEL = "text-embedding-3-small"

docs = [
    "怎么申请 API Key",
    "账单页面在哪里查看用量",
    "请求太频繁会返回 429 错误",
]

def embed(texts):
    res = client.embeddings.create(model=MODEL, input=texts)
    return np.array([d.embedding for d in res.data])

doc_vecs = embed(docs)                  # 形状:(3, 1536)
query_vec = embed(["为什么提示请求太多"])[0]

scores = doc_vecs @ query_vec           # 点积 = 余弦相似度
best = int(np.argmax(scores))
print(docs[best], float(scores[best]))
文档很多时,别每次都全部重新算。官方 FAQ 的建议是:要快速找最近的 K 个向量,用向量数据库。官方的 Cookbook 里有与各种向量数据库配合的例子。向量搜索只是帮你找出相关的文字,最后的回答通常还要交给聊天模型,写法见 /guides/openai-responses-api。
五、数 token 和费用
官方 FAQ 提供了用 tiktoken 数 token 的方法,三代向量模型用 cl100k_base 编码:
python
import tiktoken

def num_tokens(text, encoding_name="cl100k_base"):
    return len(tiktoken.get_encoding(encoding_name).encode(text))

print(num_tokens("tiktoken is great!"))
这样能在发请求前估算输入多长、大约花多少,也能避免超过模型的最大输入。数量巨大的文档集,可以考虑用 Batch API 做,写法见 /guides/openai-api-batch,该文件的端点要填 /v1/embeddings。
常见问题
Q:向量模型知道最近的事吗?
官方说,text-embedding-3-large 和 text-embedding-3-small 不了解 2021 年 9 月之后发生的事件。对大多数搜索场景影响不大,个别情况下会降低效果。
Q:我能把向量公开分享吗?
官方 FAQ 的回答是可以:客户拥有自己输入和模型输出的内容,包括向量。但你要自己保证输入的内容不违反适用法律和使用条款。
Q:用余弦相似度还是欧氏距离?
官方推荐余弦相似度,并说距离函数的选择通常影响不大。因为向量已归一化,两者排序结果相同。
Q:请求报 429?
见 /guides/openai-api-429-error。
参考资料
- OpenAI 官方:Vector embeddings — https://developers.openai.com/api/docs/guides/embeddings
0 条评论
还没有评论,来抢沙发~