
本文根据 OpenAI 官方《Images and vision》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 已经能用 Python 或 Node 发出第一个请求,想让模型“看图说话”、读图中文字的开发者;
- 做发票识别、截图问答、商品图描述等小工具的人;
- 想弄清楚“图片到底怎么塞进请求里、会不会很贵”的人。
第一次调用的写法见 /guides/openai-api-python-quickstart,本文默认你已经有可用的 Key 并能跑通文字请求。
结论先说
- 图片放进
input里某条用户消息的content数组,一项文字(input_text)加一项或多项图片(input_image)。 - 官方给了三种传图方式:完整网址、Base64 编码的数据 URL、先用 Files API 上传再引用文件 ID。
detail控制图片预处理,取值low、high、original、auto,不写默认auto;具体哪个模型支持哪几档,要看官方当天的表。- 有硬限制:支持 PNG、JPEG、WEBP、非动画 GIF;一次请求最多 1,500 张图、负载总量最多 512 MB。
- 图片按 token 计费,也占速率限制里的每分钟 token 数。价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。
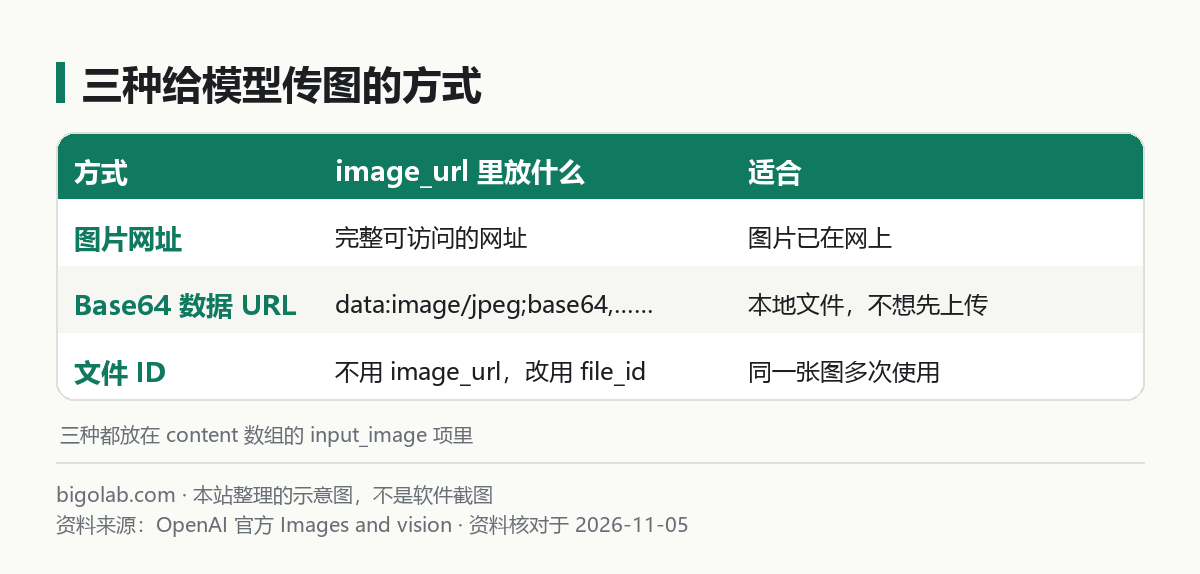
图:本站根据 OpenAI 官方《Images and vision》 整理的示意图
一、传网址:最省事
如果图片已经放在网上、而且能被公开访问,直接给网址就行。官方示例的结构如下(Python):
python
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "这张图里有什么?"},
                {
                    "type": "input_image",
                    "image_url": "https://example.com/your-image.jpg",
                },
            ],
        }
    ],
)

print(response.output_text)
注意几点:
content是个数组,文字和图片是并列的两项;- 网址必须是官方所说的“完整网址”(fully qualified URL),也就是带
https://的; - 网址要能被 OpenAI 的服务访问到,需要登录才能看的图、只在公司内网能打开的图,这种写法不适用(这一条是本站根据“需要可访问”做的推断,请按自己的情况实测)。
二、传 Base64:本地文件最常用
图片在你自己的电脑上时,可以读出来编码成 Base64,再拼成数据 URL 放进 image_url。官方 Node 示例(保存为 .mjs 文件运行):
javascript
import fs from "fs";
import OpenAI from "openai";

const openai = new OpenAI();

const base64Image = fs.readFileSync("example.jpg", "base64");

const response = await openai.responses.create({
  model: "gpt-6-astra", // 以官方模型页当天为准
  input: [
    {
      role: "user",
      content: [
        { type: "input_text", text: "这张图里有什么?" },
        {
          type: "input_image",
          image_url: `data:image/jpeg;base64,${base64Image}`,
          detail: "auto",
        },
      ],
    },
  ],
});

console.log(response.output_text);
Python 的写法同理,官方示例用 base64.b64encode(...) 编码后拼出 f"data:image/jpeg;base64,{base64_image}"。要点是数据 URL 开头的类型要和实际文件格式一致:JPEG 写 image/jpeg,PNG 写 image/png。这一条是本站根据官方 PNG 示例(data:image/png;base64,)归纳的。
三、传文件 ID:同一张图多次用
官方说,也可以先用 Files API 上传文件,再在请求里引用文件 ID。上传时 purpose 填 vision:
python
from openai import OpenAI

client = OpenAI()

with open("example.jpg", "rb") as f:
    uploaded = client.files.create(file=f, purpose="vision")

response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "这张图里有什么?"},
                {"type": "input_image", "file_id": uploaded.id},
            ],
        }
    ],
)

print(response.output_text)
这个写法对应官方 Python 文件 ID 示例。上传一次、多次引用,比每次都重新编码一大串 Base64 更省请求体积。
四、detail 怎么选
官方的 detail 说明:
| 取值 | 官方说的适用场景 |
|---|---|
low | 粗略理解图片。资源消耗随模型而不同,官方特别说明 low 不一定比 high 用的 token 少 |
high | 标准的高保真理解,不需要原图精确坐标时用 |
original | 大图、密集图、对空间位置敏感的图或 computer use,且模型支持时 |
auto | 用模型的默认处理方式 |
官方还提醒:做 OCR、找很小的物体、computer use 这类要看清细节或要精确坐标的任务,在模型支持时用 "detail": "original"。需要精确坐标时,建议先把图片缩放到模型的限制内再发送,并把返回的坐标映射回原图。
不同模型支持的档位不同。例如官方表里,较老的 gpt-4o 系列只有 low、high、auto,没有 original。所以模型名换了,detail 也要核对。
五、限制与费用
官方「Image input requirements」列出:
- 文件类型:PNG、JPEG、WEBP、非动画 GIF;
- 请求大小:一次请求总负载最大 512 MB;
- 图片数量:一次请求最多 1,500 张;
- 对按 patch 计 token 的模型,每张图最多 30,000 个 patch;超过的图会被拒绝,不会自动缩小,需要你自己先缩小尺寸再试。
费用方面,官方说图片会转换成可计费的输入 token,并且也占速率限制里的每分钟 token 数。想估算一张图要多少 token,官方有「Image input cost calculator」,可以按模型、图片尺寸和 detail 选择估算。本文不写单价,以官方价格页当天为准。请求一旦触发限流,处理方法见 /guides/openai-api-429-error。
六、官方列出的局限
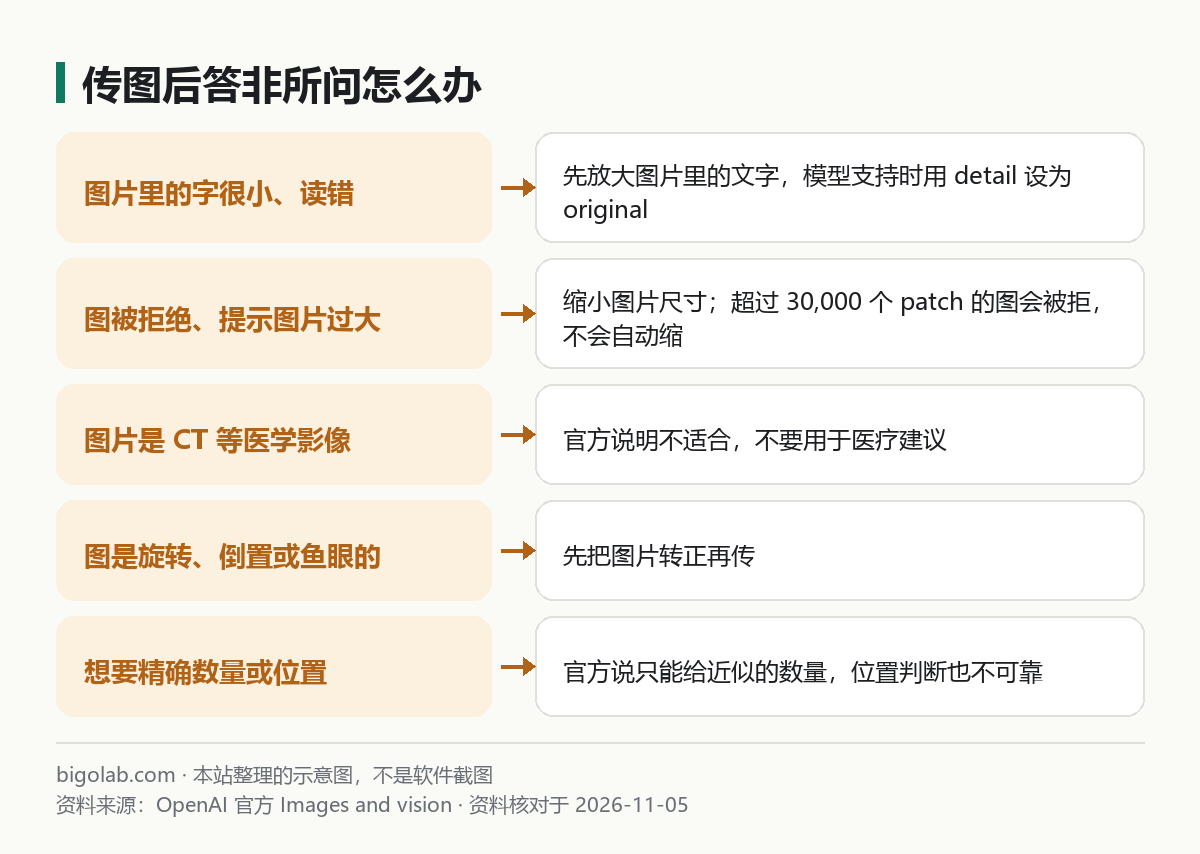
图:本站根据 OpenAI 官方《Images and vision》 整理的示意图,处理办法为本站补充
官方在「Limitations」里写明视觉模型会犯错,设计应用时要考虑:
- 医学影像:不适合解读 CT 等专业医学影像,也不应当用来做医疗建议;
- 非拉丁文字:对日文、韩文等非拉丁字母的文字,效果可能不理想;
- 小字:把图里的文字放大;模型支持时也可用
original; - 旋转:可能误读旋转或倒置的文字和图片;
- 图表样式:线条颜色、实线虚线点线混用时,可能看不懂;
- 空间推理:不擅长精确定位,官方举的例子是识别棋盘局面;
- 准确性:生成的描述或标题可能不对;
- 图片形状:全景图、鱼眼图效果不好;
- 元数据:模型不处理原始文件名和元数据,图片分析前可能被缩放;
- 计数:给出的物体数量可能只是近似;
- 验证码:出于安全原因,系统会阻止提交 CAPTCHA。
所以别把模型的识别结果直接当最终结论。需要准确数字的场景(比如发票金额),建议让程序再校验一遍,这是本站的建议。
常见问题
Q:能一次传多张图吗?
可以,在 content 数组里放多项 input_image 即可。官方提醒每张图都按 token 计费,数量越多越贵。
Q:和 Chat Completions 的传图写法一样吗?
官方端点对照表里 Chat Completions 也能分析图片并返回文字,具体字段本文没有核对,不展开。Responses 与它的区别见 /guides/openai-responses-api,本文只写 Responses 写法。
Q:想让模型“画图”而不是“看图”?
这是另一个能力,官方在同一页的开头区分了:生成图片用 Images API 或 Responses 的图像生成工具,不是 input_image。
Q:提示图片格式不支持?
对照上面的格式表:动图 GIF 不行,其他格式需先转成 PNG、JPEG 或 WEBP。
参考资料
- OpenAI 官方:Images and vision — https://developers.openai.com/api/docs/guides/images-vision
0 条评论
还没有评论,来抢沙发~