
本文根据 OpenAI 官方《Structured model outputs》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 要把模型回答直接交给程序处理的开发者:信息抽取、分类打标、生成表单或界面描述;
- 以前靠提示词“请只输出 JSON”、总是偶尔多一句废话或少一个字段的人;
- 想知道 Structured Outputs 和 JSON 模式有什么区别的人。
如果你想了解跨厂商的思路(只靠提示词、JSON 模式、结构化输出三种做法对比),先看 /guides/llm-json-structured-output-reliable。本文只写 OpenAI 的具体写法。
结论先说
- Structured Outputs 保证输出符合你给的 JSON Schema:不会漏掉必填字段,也不会冒出不存在的枚举值。JSON 模式只保证是合法 JSON,不保证符合 schema。
- 官方建议能用就用 Structured Outputs,不用 JSON 模式。
- Responses API 里的写法:
text.format设成type: "json_schema",并设strict: true。 - 有现成辅助方法:Python 用 Pydantic 加
responses.parse,Node 用 Zod 加responses.parse,结果在output_parsed。 - 仍然要处理两种意外:模型拒绝回答(refusal),以及输出被 token 上限截断(incomplete)。这两种情况输出不一定符合 schema。
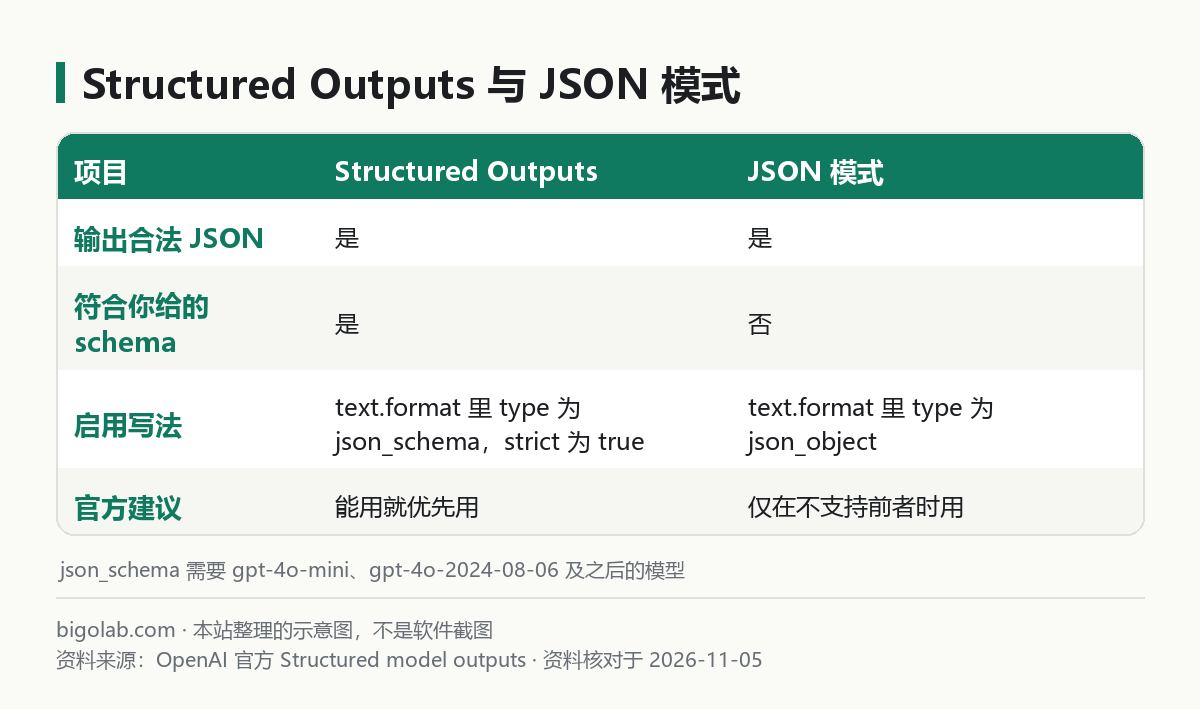
图:本站根据 OpenAI 官方《Structured model outputs》 整理的示意图
一、和函数调用怎么选
官方说 Structured Outputs 有两种形式:一是用在函数调用上,二是用 json_schema 响应格式。区分很简单:
- 模型要连接你的工具、函数、数据:用函数调用,见 /guides/openai-api-function-calling;
- 你想规定模型回答用户时的结构:用
text.format,比如数学辅导应用想让答案分成“步骤”和“最终答案”,好在界面上分别展示。
二、最省事的写法:Pydantic 和 Zod
Python(需要先 pip install openai pydantic)。下面按官方“抽取日程”例子改写:
python
from openai import OpenAI
from pydantic import BaseModel

client = OpenAI()

class CalendarEvent(BaseModel):
    name: str
    date: str
    participants: list[str]

response = client.responses.parse(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[
        {"role": "system", "content": "从用户的话里提取日程信息。"},
        {"role": "user", "content": "小明和小红周五要去参加科学展。"},
    ],
    text_format=CalendarEvent,
)

event = response.output_parsed
print(event.name, event.date, event.participants)
Node.js(需要 npm install openai zod,保存为 .mjs 运行):
javascript
import OpenAI from "openai";
import { zodTextFormat } from "openai/helpers/zod";
import { z } from "zod";

const openai = new OpenAI();

const CalendarEvent = z.object({
  name: z.string(),
  date: z.string(),
  participants: z.array(z.string()),
});

const response = await openai.responses.parse({
  model: "gpt-6-astra", // 以官方模型页当天为准
  input: [
    { role: "system", content: "从用户的话里提取日程信息。" },
    { role: "user", content: "小明和小红周五要去参加科学展。" },
  ],
  text: {
    format: zodTextFormat(CalendarEvent, "event"),
  },
});

console.log(response.output_parsed);
官方推荐尽量用 SDK 的这类辅助方法,理由是避免“JSON schema 和代码里的类型逐渐不一致”。如果你坚持手写 schema,官方建议在 CI 里加规则:只要 schema 或对应的数据类被改了就报警,或者让 CI 从类型定义自动生成 schema。
三、自己写 JSON Schema
不用辅助方法时,直接在 text.format 里写。下面是官方“数学辅导”例子的 Python 结构:
python
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[
        {"role": "system", "content": "你是数学老师,一步一步引导用户解题。"},
        {"role": "user", "content": "8x + 7 = -23 怎么解?"},
    ],
    text={
        "format": {
            "type": "json_schema",
            "name": "math_response",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "steps": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "explanation": {"type": "string"},
                                "output": {"type": "string"},
                            },
                            "required": ["explanation", "output"],
                            "additionalProperties": False,
                        },
                    },
                    "final_answer": {"type": "string"},
                },
                "required": ["steps", "final_answer"],
                "additionalProperties": False,
            },
        },
    },
)

print(response.output_text)
注意 JSON 文本在 output_text 里,是字符串,需要自己 json.loads。官方还说:第一次使用某个 schema 会有额外延迟,之后相同 schema 的请求没有额外延迟。
官方给 schema 的三条建议:键名起得清楚直观;给重要的键写清楚标题和描述;用评测(evals)来决定哪种结构最适合你的场景。
四、schema 的限制
官方说 Structured Outputs 只支持 JSON Schema 的一个子集,要点:
- 支持的类型:字符串、数字、布尔、整数、对象、数组、枚举、
anyOf; - 根必须是对象,且不能是
anyOf。官方特别提醒,用 Zod 的判别联合(discriminated union)会在顶层产生anyOf,这样写不行; - 所有字段必须
required。想表示可选,把类型写成["string", "null"]这样的联合,模型会对每个字段都给值,没有就给null; - 每个对象必须
additionalProperties: false; - 规模上限:最多 5000 个对象属性、最多 10 层嵌套;所有属性名、定义名、枚举值的字符总长不超过 120,000;枚举值总数最多 1000;
- 不支持的关键字:
allOf、not、dependentRequired、dependentSchemas、if、then、else; - 输出里的键顺序和 schema 里的顺序一致;
- 支持
$defs定义和递归 schema。
如果开了 strict: true 却传了不支持的 schema,你会收到错误。字符串还能用 pattern 和部分 format(例如 email、date-time、uuid),数字能用 minimum、maximum 等,数组能用 minItems、maxItems,但官方说这些约束对微调模型暂不支持。
五、两种边界情况必须处理
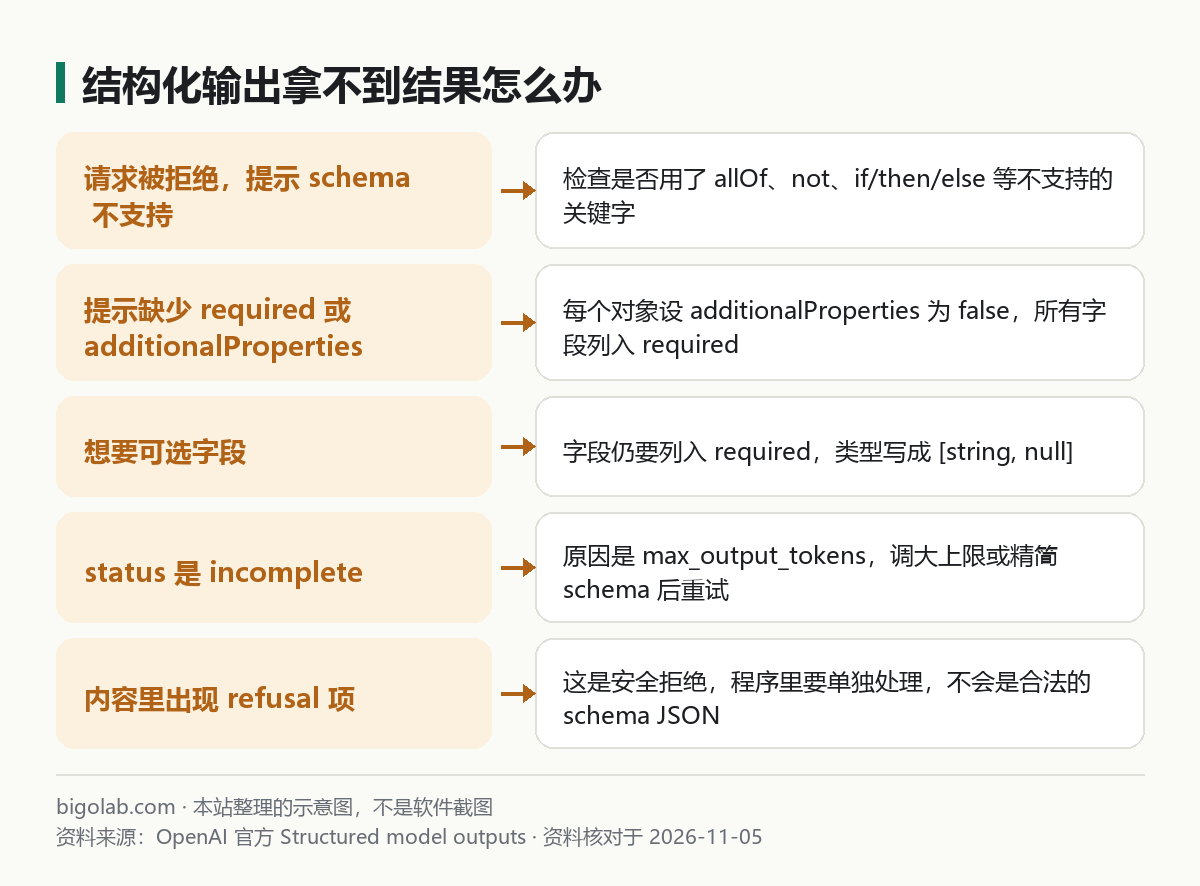
图:本站根据 OpenAI 官方《Structured model outputs》 整理的示意图,处理办法一栏为本站补充
官方强调:模型有时不会生成符合 schema 的有效响应,原因有两个:拒绝和不完整。官方示例的判断结构,改写成 Python 如下:
python
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[{"role": "user", "content": "8x + 7 = -23 怎么解?"}],
    max_output_tokens=1024,
    text={"format": {"type": "json_schema", "name": "math_response",
                     "strict": True, "schema": schema}},  # schema 同上
)

if (response.status == "incomplete"
        and response.incomplete_details.reason == "max_output_tokens"):
    raise RuntimeError("输出被截断,结果不完整")

message = next(i for i in response.output if i.type == "message")
part = message.content[0]
if part.type == "refusal":
    print("模型拒绝:", part.refusal)
elif part.type == "output_text":
print(part.text)- 达到
max_output_tokens时,status是incomplete,JSON 可能是半截的; - 安全拒绝时,内容项的
type是refusal而不是output_text,官方把它称为“可以用程序检测的拒绝”。
另外官方还提醒两件事:一是用户输入与 schema 完全不相关时,模型仍会努力凑出符合 schema 的内容,可能编造,所以提示词里要写明“输入不适用时返回空值或一句固定话”;二是 Structured Outputs 仍然可能出错,内容错了就调整指令、在系统指令里加示例,或把任务拆成更简单的子任务。
常见问题
Q:必须用 gpt-6-astra 吗?
不是。官方说 Structured Outputs 在 gpt-4o 起的最新模型上可用,新项目建议从当天官方推荐的模型起步;json_schema 格式需要 gpt-4o-mini、gpt-4o-2024-08-06 及之后的快照。
Q:可以和流式一起用吗?
可以。官方页面有 SDK 的 stream 方法示例,会收到文字增量和拒绝增量事件,基础流式写法见 /guides/openai-api-streaming。
Q:它会让请求更贵吗?
官方这一页没有写额外费用,价格以官方价格页当天为准,见 /guides/openai-api-price-official-table。schema 本身会占输入 token 这一点,是本站的推断,实际用量请看账单。
Q:第一个请求很慢?
正常,官方说明首次使用新 schema 需要处理时间。
参考资料
- OpenAI 官方:Structured model outputs — https://developers.openai.com/api/docs/guides/structured-outputs
0 条评论
还没有评论,来抢沙发~