
結論先說
- 幾十份以內的核心制度庫,直接走「
Files API+Citations+ 提示詞緩存」比自建粗糙切片 RAG 準得多:用client.files.upload傳一次原版 PDF 拿到file_id,免去每次請求重複上載幾兆字節文件,還能完整保留跨頁上下文。 - 在
document塊加上"citations": {"enabled": True},模型就不再靠記憶亂編頁碼:服務端會在返回塊裏結構化附帶精確的 PDF 起止頁碼(page_location)和逐字原文摘錄(cited_text),且官方規定引用的原文摘錄部分不額外收輸出 Token 費。 - 死守一條多租戶安全紅線:絕對不要信任前端傳上來的
file_id:因為 Files API 上載的文件對當前 API Key 所屬的整個工作區可見,file_id必須由你自己的業務後端按登入員工權限從數據庫查出來拼接。 - 不想自己寫代碼搭前端頁面、只想在現成介面建小團隊制度知識庫時:可以直接用網頁版 Projects 功能,開通訂閱可查看本站 Claude Pro 充值說明 或多人重度檔 Claude Max 充值頁。
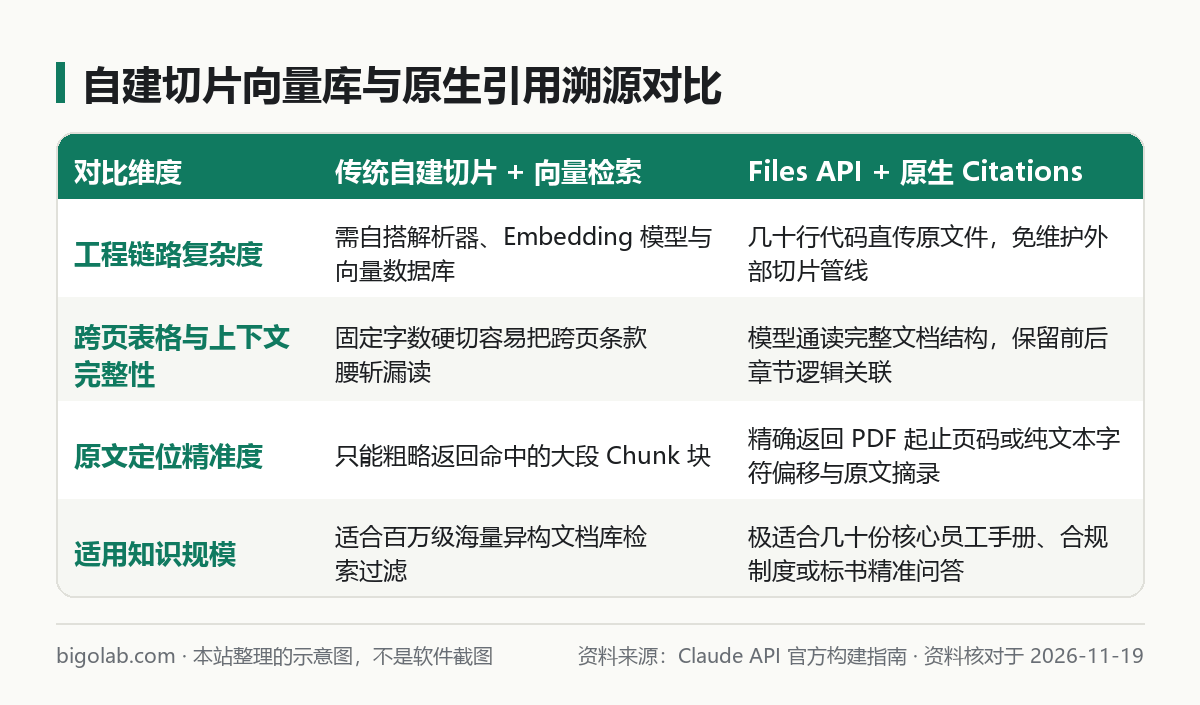
圖:本站根據 Claude API 官方構建文檔 整理的兩種制度問答路線對比圖
本文根據 Anthropic 官方開發者文檔《Citations》《Files API》(platform.claude.com/docs)整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 想給公司內部搭一個「員工手冊、財務報銷制度、標書規範」精準問答助手,要求每一句回答後面都能點開對應 PDF 第幾頁哪句話的開發者;
- 手頭核心制度文件一共就十幾份 PDF,覺得為了這點體量去搭一套切片器 + Embedding + 向量數據庫太重、而且硬切片總是把跨頁表格砍斷的工程師;
- 已經分別看過本站 Files API(1849 號文)和 Citations(1850 號文)單項介紹,想要一份把上載緩存、防越權與前端角標解析串成閉環的生產級代碼的人。
一、從一次上載到帶頁碼溯源輸出的 Python 閉環代碼
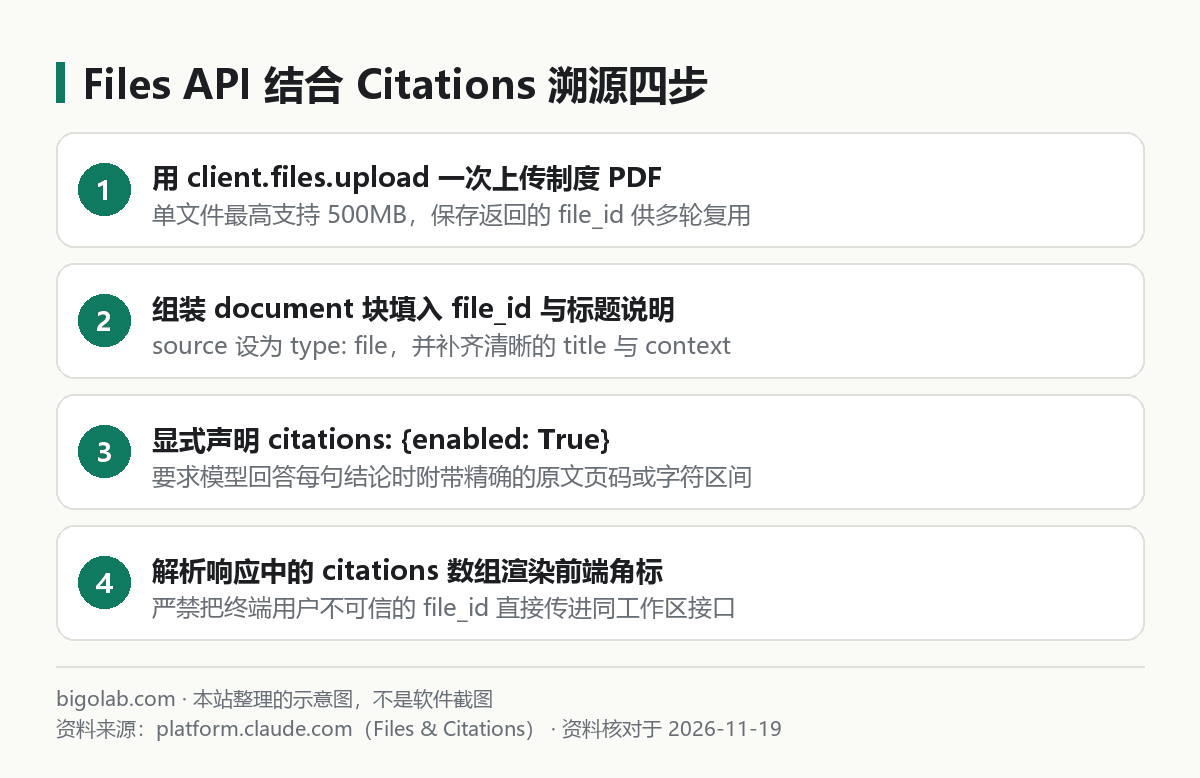
圖:本站根據 Files API 與 Citations 文檔 整理的四步落地流程示意圖
注意:document 內容塊開啟原生引用支持 PDF 與純文本(如果手頭是 .docx 或 .xlsx,請先在後端轉成 PDF 或純文本再傳;文件生命週期與 500MB 限制細則見 Claude Files API 詳解,引用塊全字段格式見 Claude Citations 接口詳解)。
下面演示「管理員後台上載一次入庫 → 員工提問時掛載 file_id、開啟引用並順手加緩存斷點 → 解析頁碼角標」的完整代碼:
python
import anthropic

client = anthropic.Anthropic()

# 第一階段(僅在制度更新時跑一次):上載 PDF 並把返回的 file_id 存入你自己的業務數據庫
uploaded = client.files.upload(
    file=("reimbursement_policy_2026.pdf", open("reimbursement_policy_2026.pdf", "rb"), "application/pdf")
)
policy_file_id = uploaded.id  # 例如 file_011CNha8...

# 第二階段(員工每次提問時調用):引用服務端查出的安全 file_id,同時開啟 Citations 與緩存
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system="你是企業財務合規助手。請嚴格依據提供的制度文檔回答,文檔未規定的事項明確答覆未找到依據。",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "document",
                    "source": {"type": "file", "file_id": policy_file_id},
                    "title": "2026版差旅與日常報銷管理制度",
                    "context": "適用於全體正式員工的國內出差住宿標準與發票時效規定",
                    "citations": {"enabled": True},
                    "cache_control": {"type": "ephemeral"},
                },
                {
                    "type": "text",
                    "text": "一線城市出差住宿晚均上限是多少?跨月發票最晚幾號前提交?",
                },
            ],
        }
    ],
)

# 第三階段:提取正文與精確頁碼角標返回給前端渲染
for block in resp.content:
    if block.type == "text":
        print("回答片段:", block.text)
        for cite in (block.citations or []):
print(f" -> 出處:《{cite.document_title}》第 {cite.start_page_number}-{cite.end_page_number} 頁 | 原文:{cite.cited_text!r}")長文檔精讀與高頻生產力訂閱入口:無論是往 Projects 掛載幾十份背景資料、審閱幾十頁英文商業合同,還是連續繪製複雜架構圖,免費版短窗口配額極易受限。國內用戶可通過本站支付寶、微信支付或 AlipayHK 免上號自助開通 Claude Pro 會員(直達單品 Pro iOS 自助充值)或大額度 Claude Max 充值。
二、上生產前必踩穩的三個工程細節
- 在
document塊順手掛上cache_control:Files API 免掉的是「網絡重複上載大文件字節流」的耗時,但每次推理時文檔裏的文字與頁面視覺依然按輸入 Token 計費。像上面代碼那樣在document塊末尾加一行"cache_control": {"type": "ephemeral"},全公司員工高頻追問同一本手冊時,第二次起就能直接吃進九折以上的緩存讀取優惠(緩存疊加原理見上一篇 提示詞緩存與批處理降本指南)。 - 填好
title和context字段:當你在一次請求裏同時掛了《考勤制度》《報銷制度》《資訊保安紅線》三個document塊時,清晰的title會原樣出現在返回結果的cite.document_title裏,前端不用再自己建映射表就能直接拼出漂亮的角標卡片。 - 多部門權限隔離別偷懶:如果財務部專屬薪酬制度和全員公開考勤制度混傳在同一個 Anthropic Workspace 下,你的後端路由必須先驗當前提問人的部門角色,只把該角色有權看的
file_id數組塞進messages;若做對外 SaaS 多租戶隔離,官方建議按租戶拆分獨立工作區。
常見問題
問:什麼時候這套方案扛不住,還是得老老實實上向量數據庫(RAG)?
答:當你的文檔庫膨脹到幾百上千份、總容量遠超單次上下文窗口(哪怕開了長窗口也沒法每次把五百本 PDF 全掛進同一個請求)時,就需要先用向量或混合檢索篩出最相關的前 3 至 5 份文檔,再把篩出來的這幾份 file_id 塞進上面的 document 塊做精讀溯源——「粗排檢索 + 原生 Citations 精讀」效果最佳。
問:上載進 Files API 的制度 PDF,如果原文件改了一個數字怎麼熱更新?
答:官方規定已上載的文件不支持原地覆蓋修改。制度修訂後,請重新調一次 client.files.upload 拿到新的 file_id 更新你業務數據庫裏的指針,並順手調 client.files.delete 把舊文件刪掉(PDF 視覺圖表解析細節另見 Claude API PDF 支持說明)。
問:開啟 citations 後為什麼偶爾某句過渡話後面 block.citations 是空的?
答:像「根據您提供的制度規定,分以下兩點說明:」這類純禮貌銜接引導句本身不承載具體條款事實,因此不掛引用對象是完全正常的;真正包含金額、天數、審批人的實質斷言塊都會附帶對應的引用列表。
問:新註冊 Claude 收不到手機驗證碼,或者沒有外幣卡怎麼開通 Pro / Max 會員?
答:註冊受阻可先看本站 Claude 註冊與普號說明頁;已有帳號升級會員可直接前往 Claude Pro 充值頁 或 Claude Max 充值頁 獲取自助卡密兌換,支持開具增值稅發票,實時價格與售後邊界(封號不在質保範圍)見各商品頁。
0 條評論
還沒有評論,來搶沙發~