
結論先說
- 調優前先把檢索出來的原始片段打印出來肉眼看一遍:如果正確依據根本不在召回的 Top-K 裏,換再貴的生成模型也救不回來;九成以上的 RAG 答非所問都出在切塊與召回階段。
- 第一步修切片(Chunking):別按固定字數硬劈表格和標題:改按 Markdown 標題或段落邊界遞歸切分,把父級章節標題拼進每個子塊開頭,並留出 10% 至 15% 的重疊區防斷句。
- 第二步補混合檢索(Hybrid Search):單路向量搞不定生僻專有名詞:把稠密向量檢索(懂同義詞語義)和 BM25 稀疏關鍵詞檢索(精確定位型號、法條號、錯誤碼)雙路並行,再用 RRF 融合排序。
- 第三步加 Rerank 重排序:先廣撒網召回 Top-30,再精排截留 Top-5:初篩重速度容易混入似是而非的干擾段,用交叉編碼器(Cross-Encoder)逐對重打分後再餵給大模型,準確率提升最立竿見影。
- 模型訂閱與團隊採購入口:若資料總量不大想直接用官方網頁版項目知識庫或終端編程工具調優代碼,可在本站免外幣卡開通 Claude Pro、ChatGPT Plus,更多服務見 AI 會員充值中心。
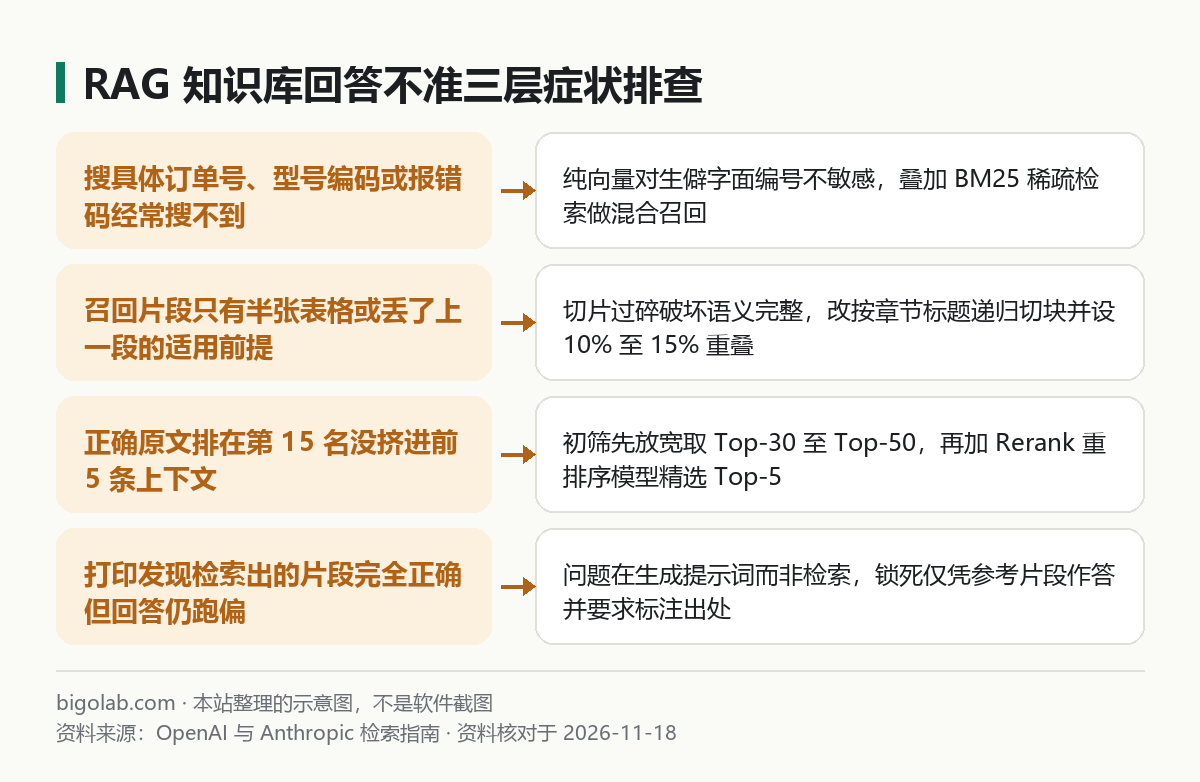
圖:本站根據 OpenAI 官方文檔:Retrieval 與 Anthropic:Contextual Retrieval 整理的示意圖
本文根據 OpenAI 官方文檔《Retrieval》與 Anthropic 官方技術文章《Introducing Contextual Retrieval》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 或 Anthropic 官方網站。
適用於誰
- 用預設參數搭完向量知識庫,發現搜報錯碼、合同條款編號、SKU 型號經常漏檢或張冠李戴的開發者;
- 準備一個勁換更貴的生成大模型,卻還沒確認到底是「沒搜出來」還是「搜出來了沒讀懂」的工程師;
- 想拿到 BM25 混合檢索倒數排序融合(RRF)與重排序(Rerank)清晰調優順序的人。
一、第一步:修復結構化切片(Chunking)與元數據注入
在確認資料規模確實超出了純緩存適用範圍(判斷邊界見 RAG 與長上下文加提示詞緩存選型指南)後,先檢查入庫切片有沒有把一句話或一張表劈成兩半:
- 按文檔層級遞歸切分,而非按字符死切:優先按
# / ## / ###標題、雙換行段落、句號依次降級切分,常規制度與說明文檔單塊控制在 400 至 800 tokens 左右,相鄰塊保留 50 至 100 tokens 重疊。 - 整表不拆行,代碼塊不拆函數:遇到 Markdown 表格一旦從中間截斷,下半截數據行就徹底丟了表頭列名;解析時應將完整小表作為獨立塊保留,大表則在拆分後的每一頁子表頂部重複拼上表頭行。
- 把文檔標題與路徑塞進塊首:一個孤立切片只寫「保修期為 24 個月」,向量化後根本分不清是哪款產品(向量模型調用細節見 OpenAI Embeddings 向量教學 與 Gemini Embeddings 任務類型指南)。入庫前統一拼接為
[文檔:X200 說明書 > 第四章售後] 保修期為 24 個月,能直接消除大量串貨錯答。
二、第二步:用「BM25 + 稠密向量」混合檢索消滅編號漏檢
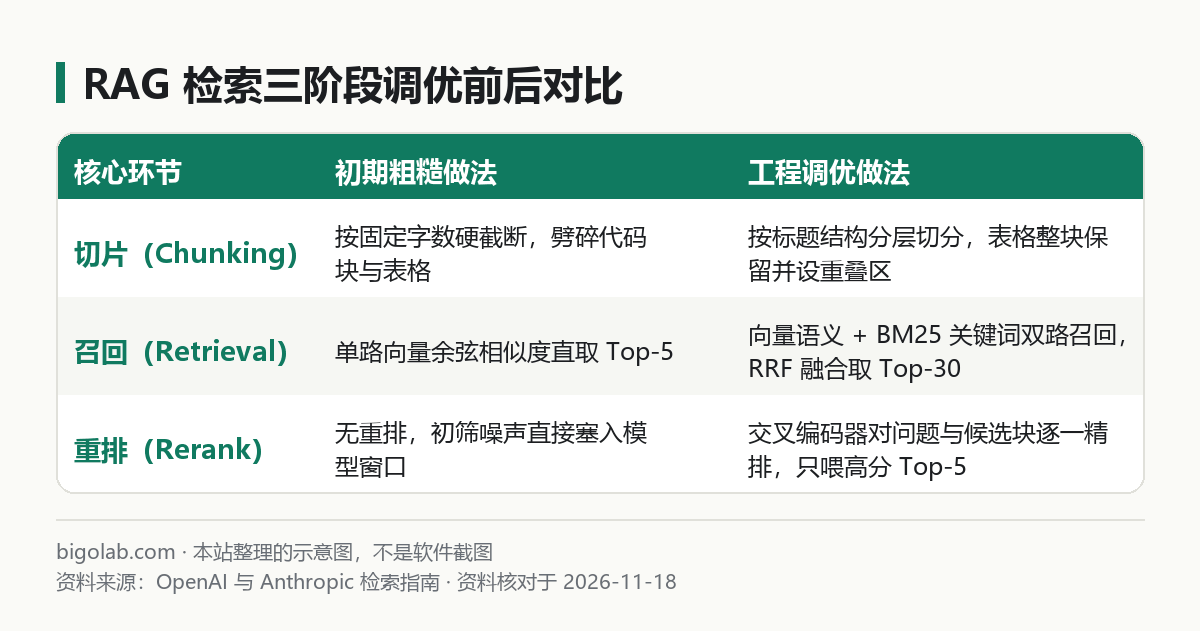
圖:本站根據 Anthropic:Contextual Retrieval 整理的示意圖
純稠密向量把整段話壓縮成一串浮點數,擅長匹配「怎麼退錢」和「退款申請流程」,但遇到 ERR_SSL_PROTOCOL、GB/T 35273 或具體員工工號時,向量距離往往拉不開差距。Anthropic 實驗表明,將向量檢索與傳統 BM25 詞頻檢索合並可顯著降低漏召回。兩路分數由於量綱不同,最穩妥的無參合並算法是 倒數排序融合(Reciprocal Rank Fusion,RRF):
python
def rrf_merge(dense_ids: list[str], bm25_ids: list[str], k: int = 60, top_n: int = 30) -> list[str]:
    """將向量檢索排名與 BM25 排名按 RRF 公式融合,無需手工歸一化分數"""
    scores: dict[str, float] = {}
    for rank, doc_id in enumerate(dense_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    for rank, doc_id in enumerate(bm25_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return [doc_id for doc_id, _ in sorted(scores.items(), key=lambda x: x[1], reverse=True)[:top_n]]
凡是在向量路和關鍵詞路排名都靠前的片段,RRF 得分會自動疊加置頂;即便某一路完全沒搜到,另一路排第一的精確報錯碼也能穩穩進入候選池。
訂閱與帳號準備提示:編寫切片清洗腳本與檢索評測流水線時,可藉助終端編程助手快速生成測試集,國內免境外卡開通可見 Claude Code 訂閱說明;若團隊不想自運維底層檢索庫,也可了解自帶企業網盤連接器的 ChatGPT Business 團隊定製。
三、第三步:接入 Rerank 重排序與鎖死生成提示詞
雙路融合拿到 Top-30 甚至 Top-50 候選塊後,如果一股腦全塞給大模型,既浪費輸入 Token 又容易觸發「中間迷失(Lost in the Middle)」。標準做法是在中間插一道 Rerank(重排序):
- 為什麼重排比向量初篩更準:雙塔 Embedding 模型是把問題和文檔各自獨立算成向量再比夾角,沒法做詞對詞的細粒度交互;而 Cross-Encoder 重排模型把「用戶提問 + 候選片段」拼在一起過注意力層逐字比對,能精準踢掉「字面都有退貨二字、但講的是供應商退貨而非消費者退貨」的偽相關塊。
- 漏斗參數配比:兩路初篩各取 25 至 50 條 → RRF 合併去重留 30 條 → 送入 Rerank 模型按相關性重排 → 截取前 5 至 8 條高分片段拼進提示詞。
- 鎖死生成端兜底紀律:確認喂進去的 5 段已經包含正確答案後,在
system提示詞(長規則可開啟 Claude 提示詞緩存 降本)裏明確要求:「僅依據給定參考片段作答,每條結論句末標註[片段編號];若參考片段未提及,直接回答現有資料未說明,禁止推測」。
常見問題
問:加上 Rerank 重排序後接口變慢了半秒怎麼辦?
答:重排耗時與送入重排的候選條數及單塊字數成正比。把送入 Rerank 的初篩池從 100 條收窄到 25 至 30 條,並控制單塊不超過 600 tokens,通常能把重排延遲壓在 100 至 200 毫秒以內。
問:用戶提問太口語化或帶指代詞(比如第二輪只問「那海外版呢?」)導致搜不準怎麼解?
答:多輪對話進檢索器前必須加一步「查詢改寫(Query Rewriting)」:先用輕量快模型結合前兩輪對話把「那海外版呢?」補全成獨立完整的檢索句「X200 海外版的保修期是多久?」,再拿去跑混合檢索。
問:換更大維度的 Embedding 模型和加 Rerank 哪個優先級更高?
答:只要當前已用上主流多語言或中英文向量模型,先補上「BM25 混合檢索 + Rerank 重排序」帶來的收益通常遠大於單純升級同代更大維度的向量模型,且無需全庫重新刷一遍歷史數據。
問:人在國內沒有外幣卡,怎麼訂閱 Claude、ChatGPT 付費檔或開具報銷發票?
答:可在本站 AI 會員充值中心 自助選購 Claude Pro 免上號卡密 或 ChatGPT Plus 充值服務(無需交出帳號密碼),支持支付寶、微信支付與 AlipayHK 付款並可開具增值稅發票;實時價格與售後邊界(掉訂閱按剩餘天數折退,封號不在質保範圍)以商品頁展示為準。
相關教學
- RAG 檢索增強生成和直接塞長上下文怎麼選:成本、延遲、更新頻率與官方選型判斷框架
- OpenAI Embeddings 向量怎麼用:text-embedding-3-small 調用、dimensions 縮短與搜尋
- Gemini API Embeddings 文本向量怎麼用:gemini-embedding 調用與任務類型
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
參考資料
- OpenAI API 官方文檔:Retrieval — https://platform.openai.com/docs/guides/retrieval
- Anthropic 官方技術網誌:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
0 條評論
還沒有評論,來搶沙發~