
結論先說
- 提問開頭第一句必須寫死「數據庫方言與版本號 + 真實 DDL 表結構」:PostgreSQL、MySQL 8.4、BigQuery、ClickHouse 與 Hive 的日期差函數和窗口幀語法差異極大,不報方言幾乎必報錯。
- 強制要求用 CTE(
WITH ... AS)分層拆解,嚴禁寫三層套娃子查詢:把「數據去重與分區過濾 -> 窗口標記 -> 最終聚合指標」拆成命名清晰的 CTE,出錯時一眼就能定位到哪一層算偏了。 - 寫留存與漏斗必須提前鎖死 3 個業務口徑:單日多次事件是否按
(user_id, dt)去重、漏斗是否要求嚴格按時間先後且限定時間窗(如 24 小時內)、無交易日滑動窗口是用ROWS按行數還是先補齊日期維度。 - 讓 ChatGPT 在內置 Python 沙盒裏用 SQLite 造 15 行極端測試數據自跑一遍:包含同秒並發訂單、單日重複登入、跳過中間步驟的髒數據,能把隱藏口徑 Bug 提前攔在上線之前。
- 複雜多表口徑推導、慢 SQL 執行計劃診斷以及內置沙盒造數驗算對高階推理配額消耗較明顯:免費輕量模型在邊界邏輯上更容易遺漏,國內無外幣卡用戶可通過本站 ChatGPT Plus 自助充值 或 ChatGPT Plus 會員直充 獲得更穩定的高階代碼分析體驗。
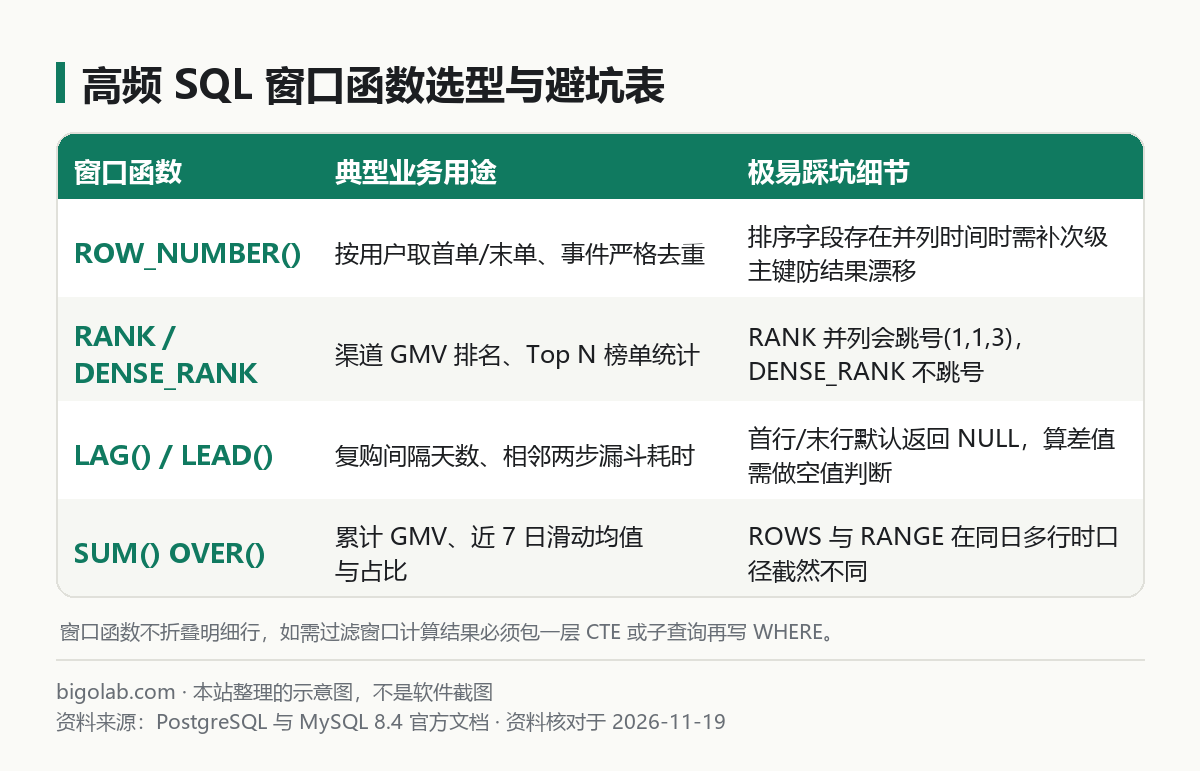
圖:本站根據 PostgreSQL 官方文檔 與 MySQL 8.4 手冊 整理的示意圖
本文根據 PostgreSQL 官方文檔《Window Functions》、MySQL 8.4 參考手冊《Window Functions》及 OpenAI 幫助中心《Data analysis with ChatGPT》整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 數據分析師、產品經理與增長運營,日常要拉取次日/7 日留存、連續活躍天數、復購時間間隔與多步有序轉化漏斗,但寫嵌套
OVER(PARTITION BY ...)常常暈頭轉向的人; - 後端研發與 BI 工程師,希望把又慢又長的多層
SELF JOIN子查詢重構成清晰可讀、易維護且對索引友好的 CTE + 窗口函數查詢的人; - 曾經讓 ChatGPT 直接寫複雜 SQL,結果跑出來「MySQL 不支持該日期函數」「留存率超過 100%」或「漏斗沒限制步驟先後順序」的實戰用戶。
一、實戰場景一:用 MIN OVER 與 LAG 算精準留存與復購間隔
如果是零基礎了解建表和基礎查詢,可先看 用 ChatGPT 寫 SQL 與解釋報錯教學。而在增長分析裏,最容易算錯的就是「同一天多次活躍導致分子虛高」以及「用註冊表還是用首次行為算 Cohort 隊列」。直接套用下面這套提示詞:
text
請用【填寫方言,如:PostgreSQL 16 / MySQL 8.4】編寫一段清晰、可直接用於生產的 CTE 窗口函數 SQL。

表結構(已脫敏):
- `user_events`:`user_id` (BIGINT), `event_name` (VARCHAR), `event_time` (TIMESTAMP), `channel` (VARCHAR)
- 常見數據特點:同一用戶在一天內可能多次觸發 `app_open` 和 `pay_success`;表已按 `event_time` 建索引

業務需求:
1. 統計最近 30 天內,按用戶「首次激活日期(`first_date`)」分組的新增 Cohort 隊列規模,以及次日(D1)、7 日(D7)、30 日(D30)留存人數與留存率(保留 2 位小數);
2. 另寫一段基於 `LAG()` 窗口函數的查詢,統計每位付費用戶在相鄰兩筆 `pay_success` 訂單之間的復購間隔天數(按時間升序,同一時間戳以 `order_id` 兜底排序),並輸出中位數與各間隔區間的分佈;
3. 強制要求:
   - 第一層 CTE 先按 `(user_id, DATE(event_time))` 去重,杜絕留存率超過 100%;
   - 對未滿 7 天或未滿 30 天的近期隊列在結果中標註 `NULL` 而非誤顯示 `0%`;
   - 最後使用內置 Python(sqlite3)構造 12 行含同日多登入、未復購與跨月邊界的測試數據跑一遍,給出預期結果核對錶。
通過把「未滿觀察期標 NULL」和「同日去重」提前寫進約束,拿到的 SQL 質素能直接達到資深數據分析師水準。提醒一句:涉及真實生產業務表時只貼脫敏 DDL 與模擬樣例,不要上載真實用戶明細,私隱配置見 ChatGPT 私隱設定與數據控制說明。
額度與訂閱提示:連續讓模型推導多層 CTE、在 Python 沙盒裏造邊界測試數據並逐行優化EXPLAIN慢查詢,很容易觸及免費帳戶的高階模型限制。國內無外幣卡用戶可通過本站 ChatGPT Plus 充值指南 或免交密碼的 ChatGPT Plus 卡密兌換 提升日常分析配額;每天深度寫複雜數倉 SQL 與大數據腳本的重度工程師也可對比升級 ChatGPT Pro 充值方案(檔位對比見 ChatGPT Plus 和 Pro 區別)。
二、實戰場景二:用 LEAD / RANK 與 SUM OVER 做嚴格有序漏斗和滑動彙總
普通 GROUP BY 統計漏斗最大的漏洞是「不管步驟先後」——用戶先誤點支付失敗頁再回頭看商品詳情,也會被算進轉化。利用窗口函數做「時間有序 + 窗口限定」漏斗及累計趨勢統計,複製下面這段指令:
text
數據庫方言:【例如:MySQL 8.4 / PostgreSQL 16】
數據表 `funnel_events` 字段:`user_id`, `session_id`, `event_name`(含 `view_item`、`add_cart`、`submit_order`、`pay_success`), `event_ts` (TIMESTAMP), `amount` (DECIMAL)。

請分兩段 CTE 窗口函數查詢幫我實現:
任務 A(嚴格有序 24 小時轉化漏斗):
- 僅統計先發生 `view_item`,且在首次瀏覽後的 24 小時內依次發生 `add_cart` -> `submit_order` -> `pay_success` 的去重用戶數與步間轉化率;
- 若用戶跳步直接觸發後端回調事件,不得計入完整轉化鏈路;請用條件聚合或 `MIN() OVER` / 窗口標記寫出無自連接爆炸風險的高效方案。

任務 B(按渠道的累計銷售額與近 7 日滑動均值):
- 先按 `(channel, dt)` 彙總日銷售額,再用 `SUM() OVER(PARTITION BY channel ORDER BY dt ROWS BETWEEN 6 PRECEDING AND CURRENT ROW)` 計算近 7 日滾動總額與累計佔比;
- 請用 `DENSE_RANK()` 標記每日各渠道銷售額排名,並明確提醒我:如果某個渠道某天零訂單缺行,`ROWS BETWEEN 6 PRECEDING` 會產生什麼偏差、該如何先關聯日期維度表補零。
拿到腳本後,可以先在 ChatGPT 代碼沙盒裏驗證邏輯(方法見 用 ChatGPT 寫代碼與運行報錯排查),跑通後再將結果導出做可視化(見 ChatGPT 分析 Excel 數據實戰)。
三、慢查詢排障:把 EXPLAIN 執行計劃貼給 ChatGPT 降耗時
窗口函數雖然語法優雅,但如果 PARTITION BY 和 ORDER BY 沒命中合適索引,在千萬行大表上很容易觸發大規模磁盤排序(Using filesort 或 External Merge Sort)。直接把脫敏後的 EXPLAIN ANALYZE 文本貼給 ChatGPT,附上指令:
text
下面這條窗口函數 SQL 在 3000 萬行訂單表上跑了 42 秒。這是脫敏後的 `EXPLAIN ANALYZE` 輸出與現有索引列表:
[粘貼執行計劃與索引定義]

請幫我:
1. 指出耗時最高的前兩個算子(如全表掃描、磁盤排序、窗口分區下推失敗);
2. 給出精確的聯合索引設計建議(列順序嚴格對齊 WHERE 等值列 -> PARTITION BY 列 -> ORDER BY 列);
3. 重寫一版先做分區時間裁剪、把過濾條件盡量前移到最內層 CTE 的優化後 SQL。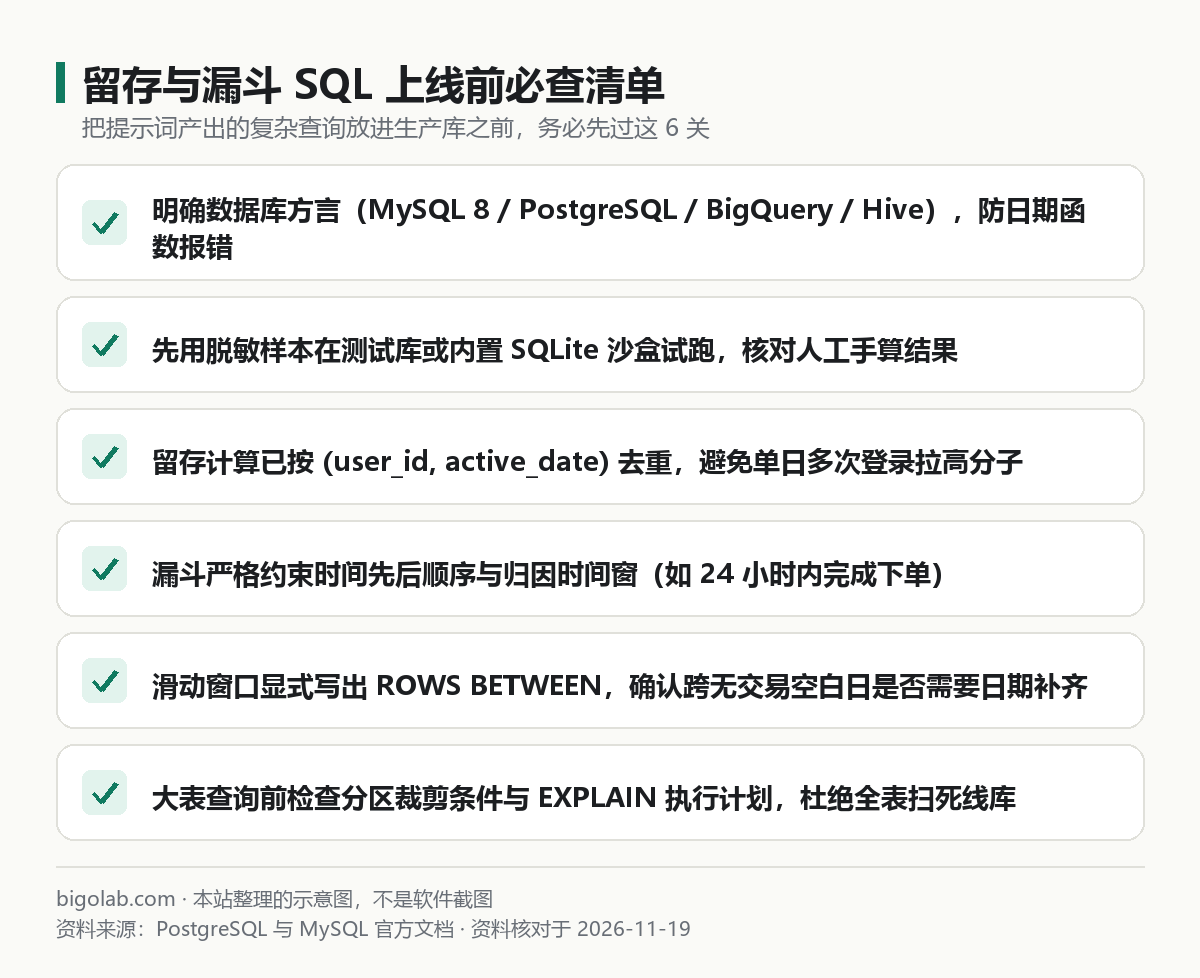
圖:本站根據 PostgreSQL 官方文檔 與 MySQL 8.4 手冊 整理的示意圖
常見問題
問:為什麼把窗口函數直接寫在 WHERE ROW_NUMBER() OVER(...) = 1 裏數據庫會報錯?
答:根據標準 SQL 執行順序,WHERE 子句在窗口函數計算之前執行,所以 PostgreSQL、MySQL 等數據庫禁止在 WHERE 裏直接引用窗口函數(少數數倉如 Snowflake / BigQuery / DuckDB 支持專屬 QUALIFY 語法)。通用寫法是把窗口計算放進上層 CTE,再在外層用 WHERE rn = 1 過濾。
問:ROWS BETWEEN 和 RANGE BETWEEN 到底差在哪,為什麼有時候算出不一樣的數字?
答:ROWS 嚴格按物理行數往前數(比如往前 6 行),而 RANGE 按排序字段的數值或時間範圍計算。如果同一天存在多條記錄或日期排序有並列值,RANGE 會把所有並列行打包一起算,而 ROWS 只截斷固定行數。在提示詞裏顯式寫明「按日先聚合去重,再使用 ROWS 或時間間隔 RANGE」能徹底消除歧義。
問:公司用的還是老版本 MySQL 5.7,不支持窗口函數怎麼辦?
答:在提示詞開頭明確寫「運行環境為 MySQL 5.7,不支持 OVER() 窗口函數」,ChatGPT 會自動改寫為用戶變量(@prev_user / @rn)或受控關聯子查詢兼容方案,並同步提示升級數據庫版本的注意事項。
問:國內沒有外幣卡,怎麼穩定開通 ChatGPT Plus / Pro 或團隊版以解鎖多文件上載與高階模型?
答:可通過本站 AI 會員充值總覽 進入 ChatGPT Plus 充值頁 獲得充足的高階推理與 Python/SQLite 沙盒驗算額度;對於高頻編寫複雜數倉 SQL 與多模型工程分析的重度用戶,可直接選購 ChatGPT Pro 會員直充,數據團隊多人協同且強調數據不參與訓練建議升級 ChatGPT Business 團隊版。支持支付寶、微信支付及 AlipayHK。實時價格以頁面展示為準;訂閱期內若掉訂閱按剩餘天數折退,因違反官方條款導致的封號不在質保範圍內。
相關教學
- 用 ChatGPT 寫 SQL:描述表結構生成查詢、解釋報錯和優化慢查詢,先在測試庫跑再上線
- 用 ChatGPT 寫代碼怎麼用:代碼塊的複製、編輯、預覽、運行 Python,報錯了怎麼辦
- ChatGPT 分析 Excel 數據:上載表格、清洗、透視與出圖(附可複製提問)
- ChatGPT 私隱設定:怎麼關閉「改進模型」訓練、數據控制與私隱中心
- ChatGPT Plus 和 Pro 有什麼區別:Pro 100、200、500 三檔怎麼選
參考資料
- PostgreSQL 官方文檔:Tutorial — Window Functions — https://www.postgresql.org/docs/current/tutorial-window.html
- MySQL 8.4 Reference Manual:Window Functions — https://dev.mysql.com/doc/refman/8.4/en/window-functions.html
- OpenAI 幫助中心:Data analysis with ChatGPT — https://help.openai.com/en/articles/8437071-data-analysis-with-chatgpt
0 條評論
還沒有評論,來搶沙發~