
結論先說
- 主力文本向量模型是
gemini-embedding-001:通過client.models.embed_content調用,contents既能傳單條字符串,也能傳字符串列表一次生成多條向量。 - 做 RAG 檢索時,入庫和查詢必須分設不同的
task_type:文檔切片入庫時設RETRIEVAL_DOCUMENT,用戶搜問題時設RETRIEVAL_QUERY,專門對齊非對稱檢索空間。 - 支持用
output_dimensionality按需裁剪維度:預設輸出3072維,官方推薦的輕量化檔位是1536或768,能大幅減少向量庫存儲和檢索內存佔用。 - 裁剪維度後必須手動補一步
L2 歸一化:官方明確提醒,預設3072維返回時已是單位向量,但縮減到低維後的子向量不再保持模長為 1,算點積或餘弦相似度前要先歸一化。 - 谷歌帳號準備與多工具訂閱入口:使用 Gemini、Google AI Studio 與 Antigravity 需具備符合地區與年齡要求的個人谷歌帳號,缺號可查看本站 谷歌帳號購買說明(含帶 2FA 的 谷歌電郵成品號),跨平台付費訂閱總覽見 AI 會員充值中心。
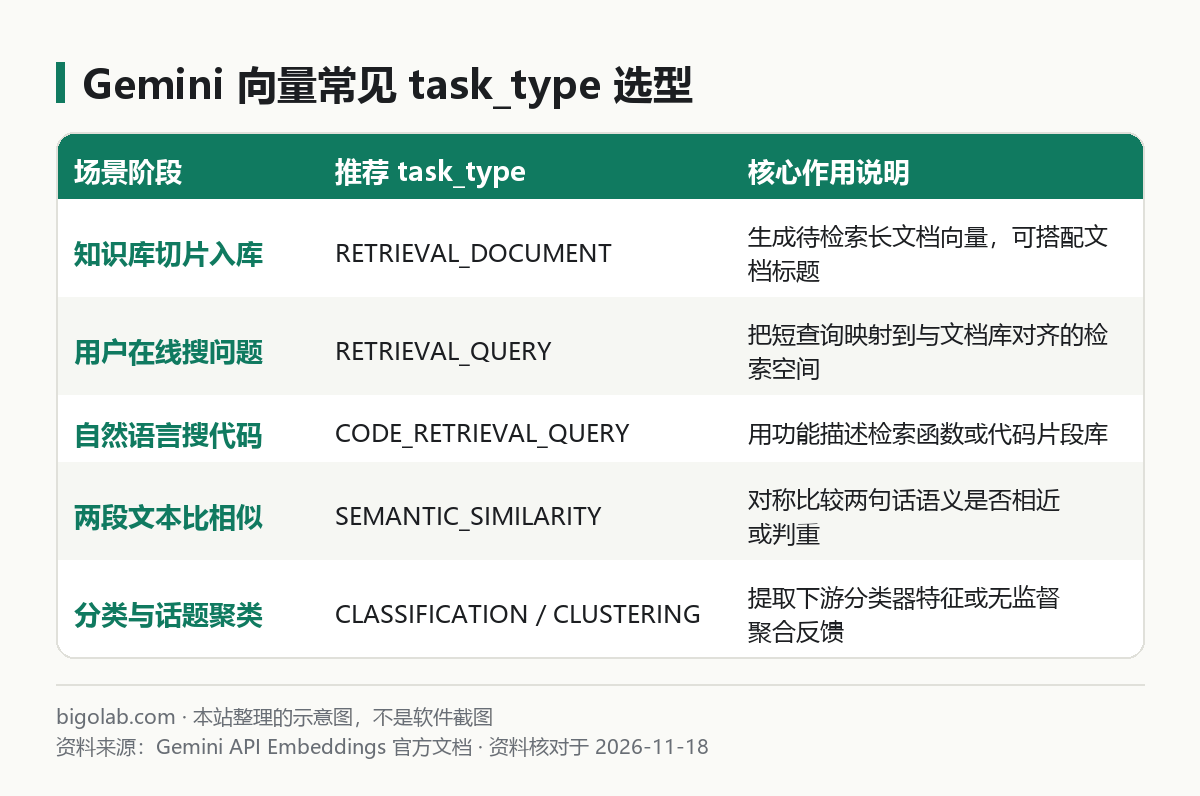
圖:本站根據 Gemini API 官方文檔:Embeddings 整理的示意圖
本文根據 Google AI for Developers 官方文檔《Embeddings》《Gemini Developer API pricing》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Google 官方網站。
適用於誰
- 準備用 Gemini API 給本地 Markdown、PDF、客服問答庫做向量化入庫(RAG)的開發者;
- 搜「gemini embedding api」,想知道
task_type該填哪一個、文檔入庫和用戶提問為什麼要填不同值的人; - 向量數據庫(如 pgvector、Milvus、Qdrant)嫌
3072維太佔內存或受索引上限限制,想安全縮減到768或1536維的人。
一、基礎調用:單條與多條文本一次轉向量
先確認本地已裝好 google-genai 並配好環境變量 GEMINI_API_KEY(未配置見 Gemini API Key 申請與配置教學)。調用 embed_content 把多段文本轉成浮點數向量只需幾行代碼:
python
from google import genai
from google.genai import types

client = genai.Client()

result = client.models.embed_content(
    model="gemini-embedding-001",
    contents=[
        "支持七天無理由退貨,拆封後需保留完整原包裝。",
        "工作日 16:00 前下單當天發出,預設發順豐快遞。",
    ],
    config=types.EmbedContentConfig(
        task_type="RETRIEVAL_DOCUMENT",
        output_dimensionality=768,
    ),
)

for idx, emb in enumerate(result.embeddings):
print(f"第 {idx + 1} 條向量維度:{len(emb.values)},前 4 維:{emb.values[:4]}")如果有幾十萬條歷史文檔要離線建庫,還可以走官方批量向量異步接口(client.batches.create_embeddings)享標準價五折優惠,速率限制與計費口徑見 Gemini API 免費額度與限速說明 與 Gemini API 價格說明。
二、task_type 八種任務類型怎麼選(別全用預設)
在 RAG 知識庫場景裏,用戶問的是短短一句「怎麼退貨」,庫裏存的是幾百字的售後規則——兩者長度和語體不對等。指定任務類型能讓模型把向量投影到最適合該下游任務的子空間:
task_type 參數值 | 適用場景 | 配套用法說明 |
|---|---|---|
RETRIEVAL_DOCUMENT | 知識庫文檔入庫 | 給待檢索的文章段落生成向量,可配合 title 傳標題 |
RETRIEVAL_QUERY | 用戶搜尋詞向量化 | 在線檢索時把用戶的提問轉成向量,匹配 RETRIEVAL_DOCUMENT |
CODE_RETRIEVAL_QUERY | 自然語言搜代碼 | 輸入功能描述,去代碼片段庫裏檢索對應函數 |
QUESTION_ANSWERING | 標準問答對匹配 | 問題側用此類型,答案段落側搭配 RETRIEVAL_DOCUMENT |
FACT_VERIFICATION | 事實核查找證據 | 待核實的陳述句用此類型,去語料庫裏找支撐原文 |
SEMANTIC_SIMILARITY | 兩段話語義判重 | 對稱比較兩句話意思是否相近,兩邊填同一個類型 |
CLASSIFICATION | 文本分類特徵 | 把向量餵給下游分類器識別工單類別或情緒標籤 |
CLUSTERING | 無監督話題聚類 | 把大批用戶反饋自動聚成若干熱點主題簇 |
一句話記憶:對稱比相似用 SEMANTIC_SIMILARITY;短問題搜長文檔,存用 RETRIEVAL_DOCUMENT,查用 RETRIEVAL_QUERY。橫向對比 OpenAI 同類模型見 OpenAI Embeddings 向量使用教學。
三、維度裁剪(MRL)與必做的 L2 歸一化代碼
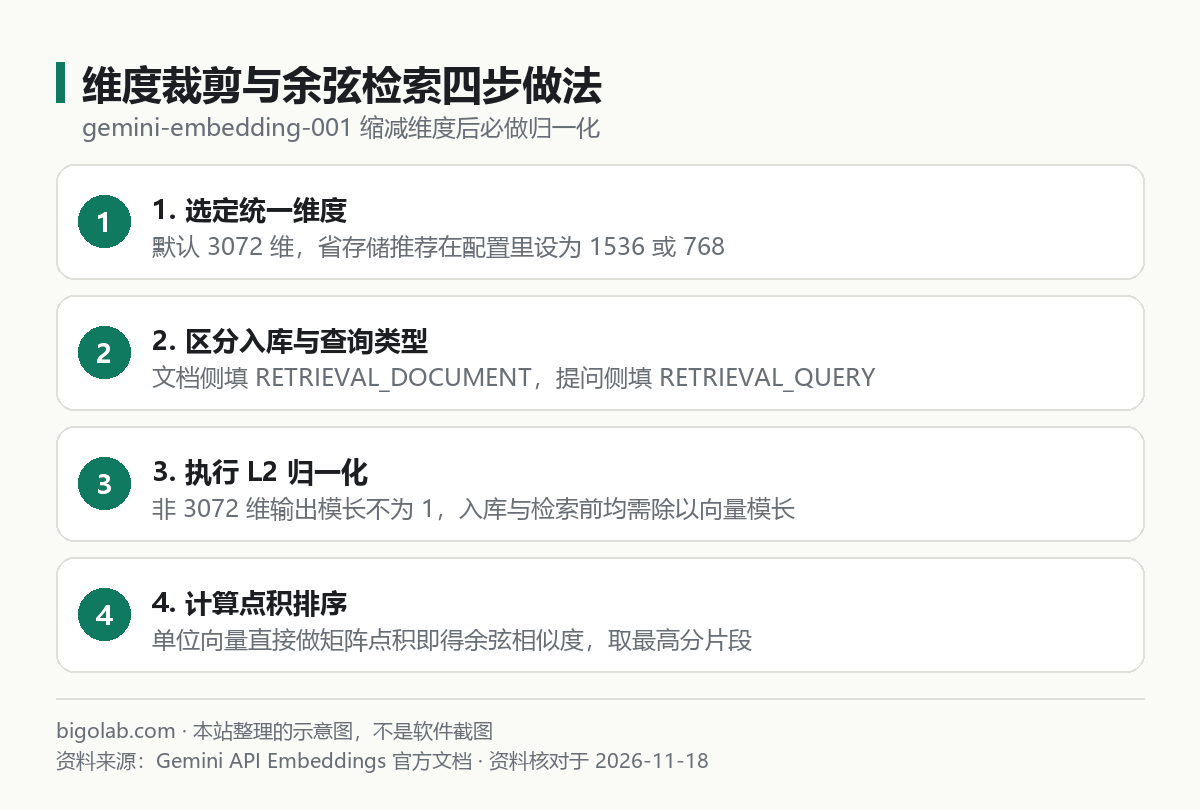
圖:本站根據 Gemini API 官方文檔:Embeddings 整理的示意圖
gemini-embedding-001 採用套娃表示學習(MRL)訓練,最重要特徵集中在最前面的維度。通過 output_dimensionality 把預設的 3072 維截斷成 1536 或 768 維時,無需重訓模型即可把存儲壓降一半到四分之三,也兼容部分向量索引的 2000 維上限。
注意一個關鍵數學細節:官方說明 3072 維完整向量出廠已是單位向量,直接點積等於餘弦相似度;但裁剪成 768 或 1536 維後模長不再等於 1。入庫和檢索前請務必補做 L2 歸一化:
python
import numpy as np
from google import genai
from google.genai import types

client = genai.Client()

def l2_normalize(vec: list[float]) -> np.ndarray:
    arr = np.array(vec, dtype=np.float32)
    norm = np.linalg.norm(arr)
    return arr / norm if norm > 0 else arr

docs = ["退款會在審核通過後 1 至 3 個工作日原路退回。", "修改收貨地址請在發貨前聯絡在線客服。"]
doc_res = client.models.embed_content(
    model="gemini-embedding-001",
    contents=docs,
    config=types.EmbedContentConfig(task_type="RETRIEVAL_DOCUMENT", output_dimensionality=768),
)
doc_matrix = np.vstack([l2_normalize(e.values) for e in doc_res.embeddings])

query_res = client.models.embed_content(
    model="gemini-embedding-001",
    contents="申請退錢之後多久能到賬?",
    config=types.EmbedContentConfig(task_type="RETRIEVAL_QUERY", output_dimensionality=768),
)
scores = doc_matrix @ l2_normalize(query_res.embeddings[0].values)
best_idx = int(np.argmax(scores))
print(f"最匹配文檔:{docs[best_idx]}(相似度:{scores[best_idx]:.4f})")
若準備海外開發環境時需要獨立 Google 帳號開通 AI Studio 和 API 項目,可查看本站 谷歌帳號購買說明 或瀏覽 充值服務總覽。
常見問題
問:能不能入庫時存 768 維,查詢時忘記傳維度用預設 3072 維去搜?
答:不能。維度不一致在任何向量數據庫裏都會直接報錯,建庫與在線檢索必須鎖定同一個模型名稱和同一個維度數字。
問:升級向量模型後需要重跑全庫索引嗎?
答:必須全量重新生成向量(Re-index)。不同模型的向量空間互不相通,即便把維度裁成一樣的數字,算出的餘弦距離也沒有意義。
問:單條文本最長能塞多少字進去轉向量?
答:向量模型的單條輸入上限(數千 token 級)遠小於對話模型的百萬窗口,以官方 Models 頁標註為準。長文檔建議按 300 至 800 字做語義分塊(Chunking)效果更穩。
問:沒有可用的個人谷歌帳號,或者同時想開其他主流 AI 會員怎麼辦?
答:本站提供即買即發的 谷歌電郵成品號(登入方法見 谷歌帳號購買頁),同時支持支付寶、微信支付與 AlipayHK 自助充值 ChatGPT Plus、Claude Code 等主流服務,實時價格與質保細則以各商品頁說明為準。
相關教學
- Gemini API Python 調用教學:安裝 google-genai SDK 與基礎請求
- Gemini API 免費額度是多少:免費層級、RPM / TPM 速率限制查詢
- Gemini API 價格:各模型每百萬 tokens 計費標準速查
- OpenAI Embeddings 向量怎麼用:dimensions 縮短與餘弦相似度搜索對比
參考資料
- Gemini API 官方文檔:Embeddings — https://ai.google.dev/gemini-api/docs/embeddings
- Gemini Developer API pricing — https://ai.google.dev/gemini-api/docs/pricing
0 條評論
還沒有評論,來搶沙發~