
結論先說
- 裸塞長上下文只適合偶發單次提問;高頻問答必須在「長上下文 + 提示詞緩存(Prompt Caching)」與「RAG 檢索增強生成」之間做選擇。
- 資料總量小於 20 萬 token(Anthropic 官方參考線,約 500 頁文本)且內容相對靜態時,優先用長上下文 + 提示詞緩存。省去切塊、向量化與重排鏈路,也不會因漏召回而答錯跨章節問題。
- 資料達到 GB 級、百萬條記錄,或內容每分鐘都在變動,必須用 RAG。物理窗口裝不下全量數據,高頻改動也會不斷擊穿前綴緩存。
- 必須核算緩存存活期(TTL)內的訪問頻率:如果幾小時才有人問一句,緩存每次都已過期重算,輕量級 RAG 反而更省錢。
- 生產環境常採用混合架構:把固定的系統指令、工具定義、核心手冊放前綴開緩存,再用 RAG 把海量庫裏檢出的動態片段拼在消息末尾。
- 國內免卡開通與帳號服務入口:自有帳號免上號自助開通可見本站 Claude Pro 充值頁 與 Claude Max 充值頁;缺可用帳號或遇身份核驗可查看 Claude 註冊說明 與 Claude KYC 認證協助。
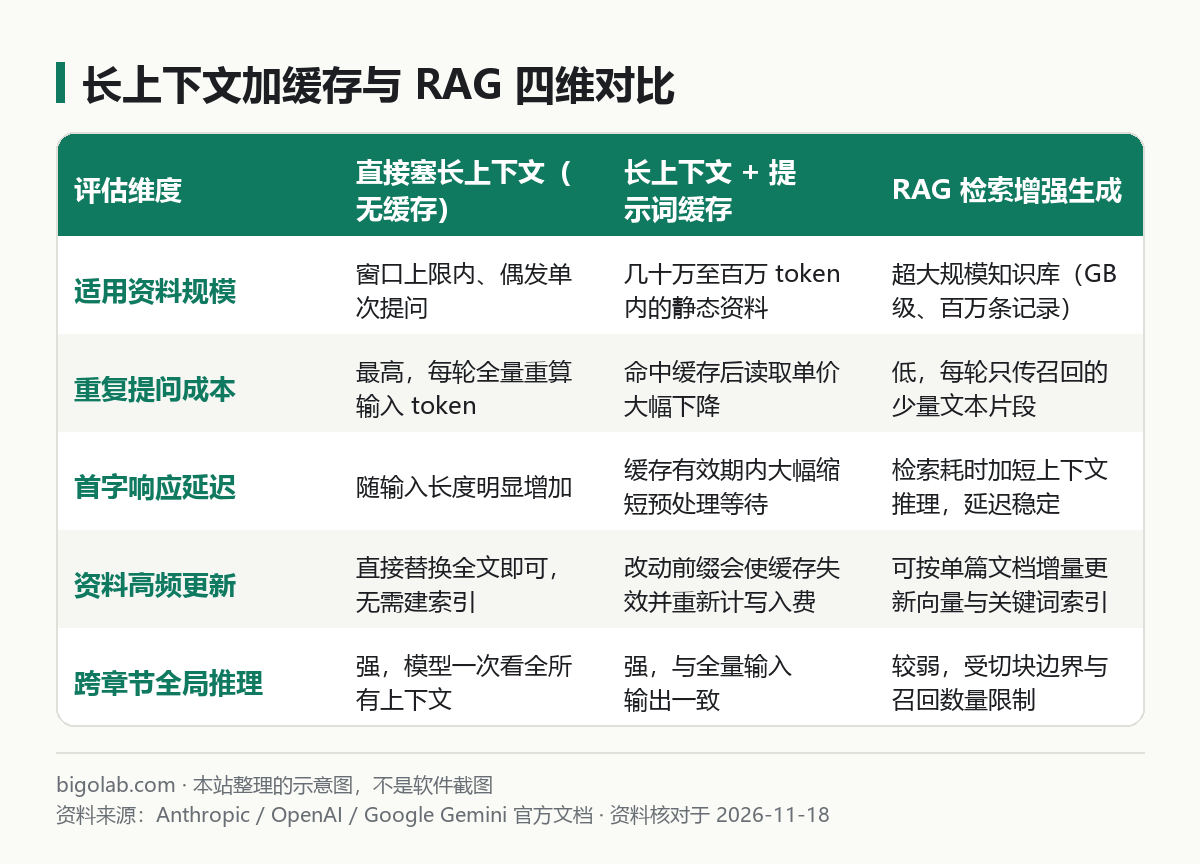
圖:本站根據 Anthropic:Introducing Contextual Retrieval 與 Google Gemini:Long context 整理的示意圖
本文根據 Anthropic 官方文檔《Prompt caching》《Introducing Contextual Retrieval》、OpenAI 官方文檔《Prompt Caching》《Retrieval》與 Google Gemini API 官方文檔《Long context》《Context caching》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic、OpenAI 或 Google 官方網站。
適用於誰
- 準備搭建企業制度問答、產品手冊客服或代碼庫分析工具,糾結要不要上向量數據庫的開發者;
- 聽說模型支持百萬級上下文,想知道「RAG 是不是不用做了」的技術負責人;
- 把長文檔直接塞進 API 提示詞後發現帳單偏貴、首字響應偏慢,想找優化方案的人。
一、本質差異:切塊召回 vs 全量緩存
傳統 RAG 先把文檔切成幾百字的小塊(Chunks)轉成向量入庫,提問時只取最相關的幾個片段放進提示詞。它的短板是切塊有損:一旦問題需要跨十幾個章節彙總數據,或者切塊切斷了上下文指代,檢索漏掉後模型就無法作答。
Google 在《Long context》文檔中對比指出:把整份代碼庫或多篇財報一次性塞進幾十萬至百萬 token 的窗口,模型擁有全局視野,能直接完成跨文檔推理。而各家推出的提示詞緩存(Prompt Caching / Context Caching)解決了每次重算全量 token 太貴太慢的問題:把固定前綴的計算狀態留在服務端內存,有效期內再次命中同一前綴時大幅降低輸入單價與首字等待。
二、三家官方的提示詞緩存規則對比
| 平台 | 觸發方式 | 緩存有效期(TTL) | 計費特點(按官方規則) |
|---|---|---|---|
| Claude API | 頂層自動緩存,或在內容塊標 cache_control | 預設 5 分鐘(命中續期),可選 1 小時 | 寫入按 1.25 倍或 2 倍計費;讀取通常降至基礎輸入價的 0.1 倍及以下 |
| OpenAI API | 達最短門檻(通常 1024 token 起)且前綴一致時自動觸發 | 按近期訪問熱度自動保留(通常數分鐘至一小時內) | 寫入不加價,命中部分按官方折扣輸入單價計費 |
| Gemini API | 除隱式緩存外,可顯式調用 Context Caching 上載大文件 | 支持自定義指定存活時長 | 按緩存讀取單價加按小時駐留存儲費兩部分計費 |
Claude 緩存斷點與命中率排查詳見 Claude 提示詞緩存入門教學。如果不調 API、只在網頁端傳幾十頁項目資料日常提問,可直接用官方網頁版的項目知識庫(Projects),需要更大上載容量與長窗口額度時可了解 ChatGPT Plus 或 Claude Pro;網頁端窗口規則見 ChatGPT 上下文長度限制 與 Claude 上下文超限處理辦法。
三、四步選型判斷框架
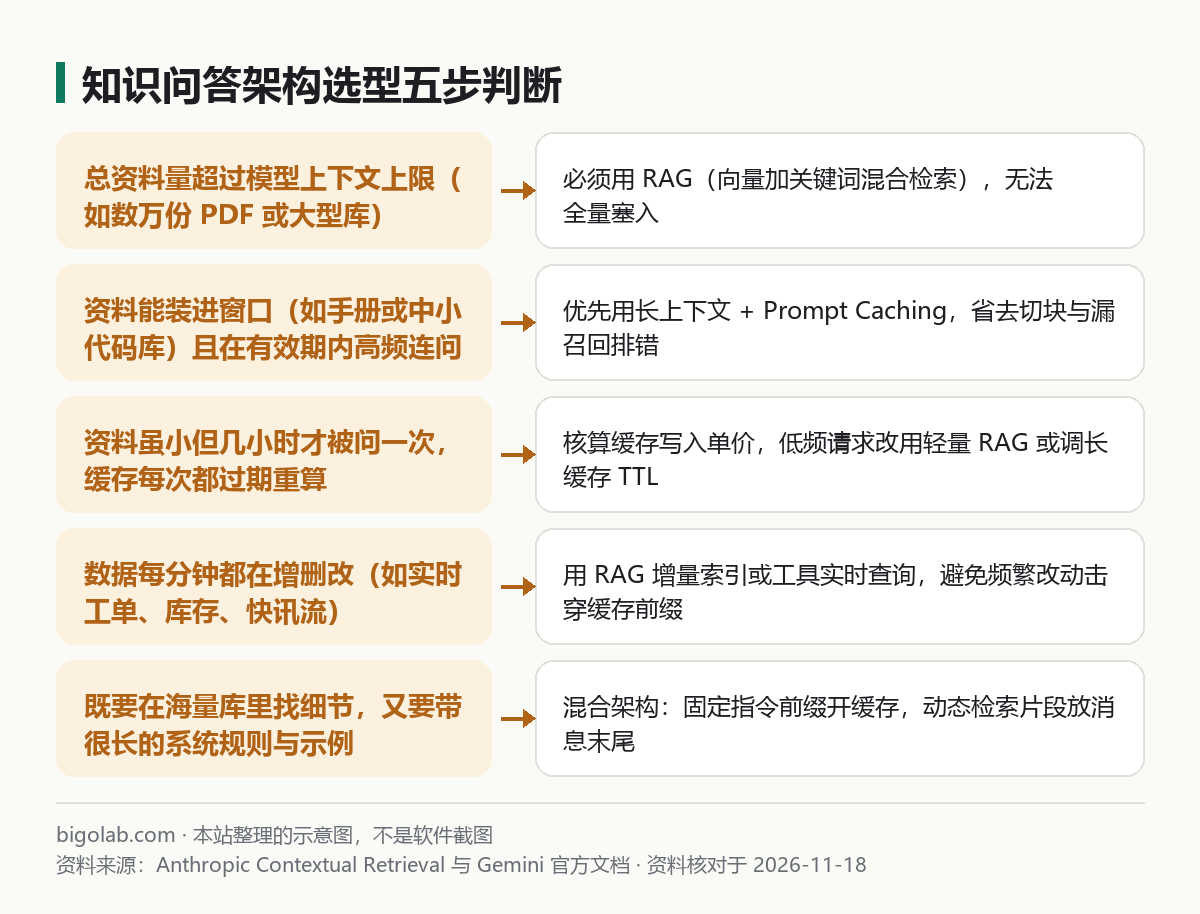
圖:本站根據 Anthropic:Prompt caching 與 OpenAI:Retrieval 整理的示意圖
- 看資料總規模:小於 20 萬 token 的靜態手冊,Anthropic 明確建議整份塞入並開 Prompt Caching,不必搭向量庫;20 萬到 100 萬 token 之間,做整書歸納走長窗口,查孤立小事實走 RAG(國產百萬窗口表現可參考 DeepSeek 上下文長度說明);超過百萬 token 必須上 RAG。
- 看請求間隔:高峰期每分鐘都有提問,5 分鐘緩存持續續期,長上下文極划算;若一天只問兩三次,每次都冷啟動重算幾十萬 token,帳單會遠高於每次只傳幾千 token 的 RAG。
- 看更新頻率:提示詞緩存要求前綴一字不差,前綴裏改一個字就會使後續緩存全部失效。年度手冊、法規彙編適合進緩存;每分鐘變動的工單、庫存、資訊流只能用 RAG 增量索引或工具實時查詢。
- 看問題形態:「報錯碼 E4012 是什麼」這類局部查點,關鍵詞(BM25)加向量檢索最快最省;「彙總兩百頁紀要裏所有人的分歧」這類全局綜合,優先走長上下文全量輸入。
四、混合架構:固定前綴開緩存 + 動態片段走 RAG
知識庫大到必須用 RAG 時,仍可把兩者結合起來:
- 切塊時補背景(Contextual Retrieval):按 Anthropic 官方方案,切分長文時先讓模型結合全文給每個小塊生成 50 到 100 字背景說明,拼在小塊前再建向量與 BM25 索引;生成說明時對整篇原文開啟 Prompt Caching 壓低預處理成本。
- 提問時靜態在前、檢索在後:嚴格按「工具定義 → 系統規則與固定示例(此處打緩存斷點)→ 本輪 RAG 召回片段 + 用戶提問」組裝請求,讓前半截始終命中緩存。
python
# 靜態前綴放在 system 並開啟緩存,動態檢索片段放 messages 末尾
messages = [
    {
        "role": "user",
        "content": f"參考片段:\n{rag_chunks}\n\n問題:{user_query}"
    }
]
常見問題
問:有了百萬級上下文,全塞進去準確率一定比 RAG 高嗎?
不一定。Google 與 OpenAI 文檔均指出,無關背景過多時仍可能干擾細小事實定位並拖慢響應;若只需一小段明確依據,乾淨的高相關性檢索片段往往更快更準。
問:開了 Prompt Caching 為什麼帳單沒降?
常見原因有三:把時間戳或動態檢索內容放在了提示詞開頭破壞了前綴一致;未達到該模型最短可緩存 token 門檻;兩次提問間隔超過了緩存 TTL。
問:OpenAI 的 File Search 屬於長上下文還是 RAG?
屬於託管式 RAG。OpenAI《Retrieval》文檔說明它會自動解析文件、切塊、生成向量並做混合檢索,無需自建向量庫。
問:人在國內沒有外幣信用卡,怎麼訂閱或升級 Claude 付費套餐?
答:可在本站 AI 會員充值總覽頁 選擇 Claude Pro 自助充值 或 Claude Max 充值,付款後即時發卡密、24 小時自助兌換且可開具增值稅發票;實時價格與售後邊界(含封號不質保)以商品頁當天展示為準。
相關教學
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
- ChatGPT 上下文長度與字數限制:一次能輸入多少字、長對話變慢怎麼辦
- Claude 上下文長度不夠、對話太長怎麼辦:報錯提示與各模型窗口大小
- DeepSeek 上下文長度與最大輸出是多少:1M 上下文與超限表現
參考資料
- Claude API 官方文檔:Prompt caching — https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Anthropic 官方技術網誌:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
- OpenAI API 官方文檔:Prompt Caching — https://platform.openai.com/docs/guides/prompt-caching
- OpenAI API 官方文檔:Retrieval — https://platform.openai.com/docs/guides/retrieval
- Google Gemini API 官方文檔:Long context — https://ai.google.dev/gemini-api/docs/long-context
- Google Gemini API 官方文檔:Context caching — https://ai.google.dev/gemini-api/docs/caching
0 條評論
還沒有評論,來搶沙發~