
本文根據 DeepSeek 官方 API 文檔整理,資料核對於 2026-10-24。數字可能隨模型更新變化,以官方頁面和接口返回為準。圖為本站整理的示意圖。
適用於誰
- 搜「deepseek 上下文長度」「deepseek 最大輸出」「deepseek 能處理多長的文檔」的人;
- 想一次性丟一整本書、一個大倉庫給它的人;
- 遇到輸出被截斷、請求報 400 說太長的開發者。
結論先說
- 上下文長度是 1M,最大輸出長度是 384K。官方價格頁的模型細節裏,
deepseek-flash和deepseek-v4-pro這兩行寫的是相同的數字:上下文長度 1M,輸出長度最大 384K。 - 精確數字:官方「獲取模型列表」接口的示例裏,兩個模型都是
context_window1048576(輸入和輸出 token 合計)、max_output_tokens393216(max_tokens可接受的最大值)。 - 上下文包括輸入和輸出合計:接口文檔對
context_window的說明是「輸入與輸出 token 合計」,所以輸入越長,留給輸出的空間越少。 - 超過限制會報錯,而不是自動截斷:Responses API 文檔寫明,
truncation參數不支持,輸入超出上下文窗口時返回 400 錯誤。
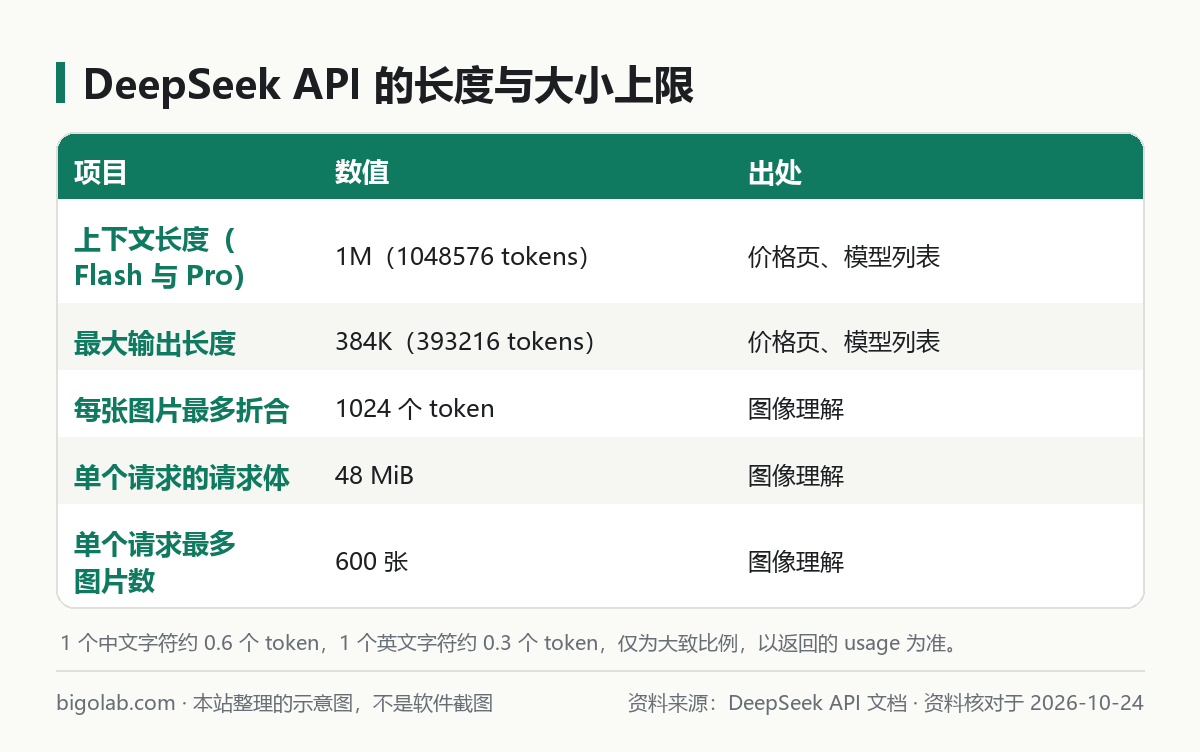
圖:本站根據 DeepSeek 官方價格頁 與圖像理解文檔整理的示意圖
一、1M token 大概是多少字
token 是模型的計量單位,也是計費單位。官方 Token 用量文檔給出的大致換算:
- 1 個英文字符約 0.3 個 token;
- 1 箇中文字符約 0.6 個 token;
- 但不同模型的分詞不同,實際處理的 token 數以返回結果裏的
usage為準。
按這個比例粗略估算,1M(約 105 萬)token 對應的中文大約是一百多萬字符的量級。這只是估算,具體內容裏夾雜代碼、數字、英文時差別會很大,所以真要接近上限,務必用 usage 或官方提供的離線 tokenizer 去算。官方文檔提供了 tokenizer 壓縮包下載,可以在本地離線計算一段文本的 token 用量。
二、輸出長度:384K 是上限,不是建議
最大輸出 384K 說明模型單次回覆最多可以很長。幾點提醒:
- 設定
max_tokens就是限制這次最多輸出多少。JSON 輸出尤其要設夠,官方提醒設定太小會讓 JSON 被中途截斷,見 /guides/deepseek-json-output-function-calling; - 思考模式下,思維鏈也算輸出。官方 2025-05-28 的 R1-0528 說明裏提到那一代模型的
max_tokens包含思考過程,預設 32K、最大 64K,那是舊模型的規則;現在的上限見價格頁,是否包含思維鏈請以最新官方文檔為準; - 寫長文時,更長不等於更好,分章節寫更容易控制,參考 /guides/deepseek-write-novel-prompts。
三、圖片、請求體大小的限制
給 deepseek-flash 傳圖片時,官方圖像理解文檔給出這些數字:
- 每張圖片會自動縮放,每張圖消耗的 token 數有上限,為 1024 個,比如 2000×2000 和 5000×5000 的圖片,縮放後消耗的 token 數相同;
- 請求體大小限制 48 MiB(內聯的 base64 圖片計入);
- 外部 URL 圖片最大 32 MiB,URL 長度最多 8192 個字符,需在 60 秒內下載完成;
- 通過 Files API 上載、用
file_id引用的圖片最大 64 MiB; - 單個請求最多 600 張圖片;圖片最長邊最多 8192 像素,一個請求包含 15 張及以上圖片時降為 4096 像素;
detail設為low時,圖片在推理前縮放到 512×512,更快、更省 token。
DeepSeek-V4 Pro 不支持圖像輸入。圖片相關的更多說明見 /guides/deepseek-upload-file-image。
四、長上下文怎麼省錢:緩存
官方的「上下文硬碟緩存」對所有用戶預設開啟。簡單說:後續請求和之前請求的前綴重複的部分,計入「緩存命中」,單價低很多。命中的前提是前綴被完整匹配:
- 多輪對話裏,第二輪請求裏包含第一輪請求的全部內容,就能命中第一輪的緩存;
- 如果第一輪是 A+B,第二輪是 A+C,第二輪沒法命中;但系統檢測到公共前綴 A 後會把 A 單獨緩存,第三輪 A+D 就能命中 A。
所以把固定的系統提示、長文檔放在最前面,把會變化的問題放在最後,能讓緩存命中率更高。命中與未命中的價格見 /guides/deepseek-v4-pro-vs-flash-api-price。
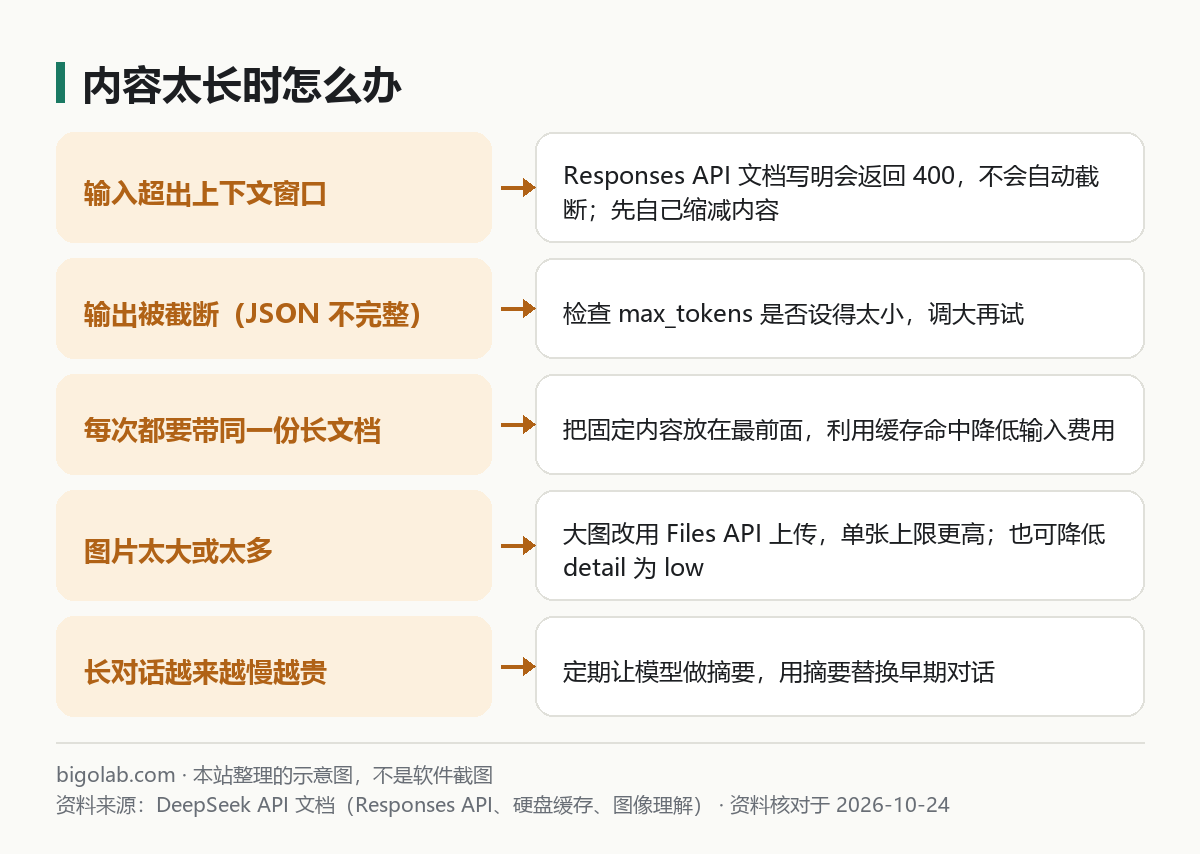
圖:本站根據 DeepSeek 官方 Responses API、硬碟緩存與圖像理解文檔整理的示意圖
常見問題
Q:1M 上下文是不是意味着可以把整本書丟進去問?
容量上可以,但內容越長,響應越慢、費用越高,也更容易出現「中間部分被忽略」的情況。長文檔提問的技巧見 /guides/long-document-prompting-tips。
Q:網頁版能上載多大的文件、對話能多長?
官方沒有給統一數字,介面會有提示,見 /guides/deepseek-upload-file-image。
Q:不同模型的上下文一樣嗎?
價格頁上 deepseek-flash 和 deepseek-v4-pro 相同。別家模型各自不同,比如 ChatGPT 的見 /guides/chatgpt-context-length-limits。
Q:輸出被截斷了怎麼辦?
先看返回的結束原因,再檢查 max_tokens;JSON 輸出被截斷時調大它。報錯類問題見 /guides/deepseek-api-error-codes。
想同時用 ChatGPT、Claude 等海外模型做對比?本站提供 AI 會員充值,ChatGPT 可看 Plus 充值。
參考資料
- DeepSeek API 文檔:模型 & 價格 — https://api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek API 文檔:獲取模型列表 — https://api-docs.deepseek.com/zh-cn/api/list-models
- DeepSeek API 文檔:Token 用量計算 — https://api-docs.deepseek.com/zh-cn/quick_start/token_usage
- DeepSeek API 文檔:使用 Responses API — https://api-docs.deepseek.com/zh-cn/guides/responses_api
- DeepSeek API 文檔:上下文硬碟緩存 — https://api-docs.deepseek.com/zh-cn/guides/kv_cache
- DeepSeek API 文檔:圖像理解 — https://api-docs.deepseek.com/zh-cn/guides/vision
- DeepSeek-V4 預覽版發佈公告 — https://api-docs.deepseek.com/zh-cn/news/news260424
0 條評論
還沒有評論,來搶沙發~