
結論先說
- 核心原理是在建索引前「先補背景再入庫」:傳統切塊直接把孤立段落轉成向量,丟掉了全文語境;Contextual Retrieval 讓模型結合整篇文檔,為每個小塊生成一段 50 至 100 字的專屬背景說明拼在塊首。
- 雙路同步增強效果翻倍:拼好背景的新文本不僅用來算稠密向量(Contextual Embeddings),還同步寫入關鍵詞倒排庫(Contextual BM25),Anthropic 官方公開評測顯示 Top-20 檢索失誤率降低 49%;再疊加上 Reranking 重排序後失誤率降低 67%。
- 靠 Prompt Caching 把離線建庫成本壓低一個數量級:處理同一篇長文檔的幾十個切片時,把整篇原文固定在提示詞前綴並打上
cache_control,除第 1 塊外其餘所有塊都按低至一折的緩存讀取價計費。 - 資料小於 20 萬 token 時不必折騰這套流水線:Anthropic 明確指出,若整個知識庫不到 20 萬 token(約 500 頁文本),直接把全量文檔塞入提示詞並開啟緩存比任何 RAG 都省事(對比見 RAG 與長上下文加緩存選型框架)。
- Claude 會員與開發工具訂閱入口:日常使用 Claude 網頁端項目知識庫或 Claude Code 寫檢索工程,國內免外幣卡開通可見本站 Claude Pro 充值頁、Claude Max 充值頁 與 AI 會員充值中心。
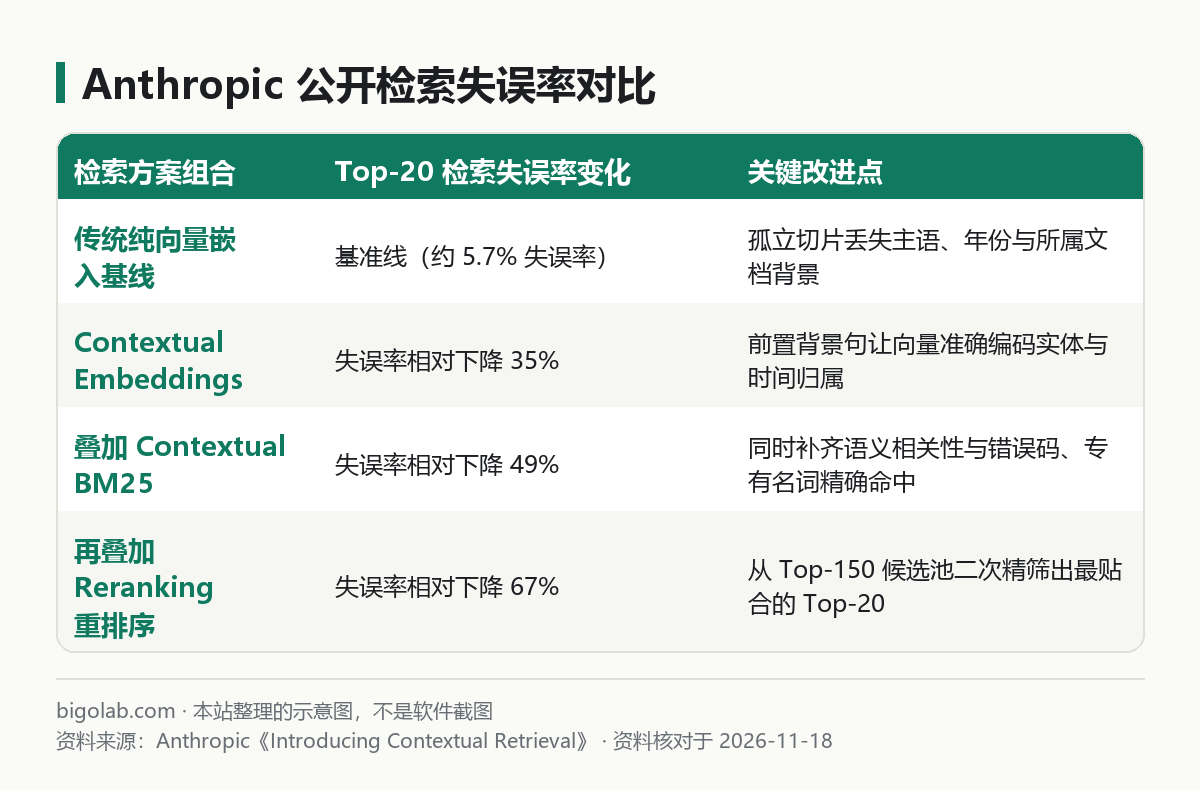
圖:本站根據 Anthropic:Introducing Contextual Retrieval 整理的示意圖
本文根據 Anthropic 官方技術網誌《Introducing Contextual Retrieval》與 Claude API 官方文檔《Prompt caching》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 檢索多份歷年財報、多產品型號手冊或多主體合同時,經常把 A 公司數據錯當成 B 公司召回來的開發者;
- 聽說 Anthropic 提出的 Contextual Retrieval 能顯著降低漏檢率,想看清它跟普通標題拼接有什麼本質區別的工程師;
- 擔心給幾萬個文檔塊逐條調用大模型補背景會把 API 帳單燒穿,想掌握官方緩存省錢寫法的團隊。
一、它到底解決了傳統 RAG 的什麼死穴
假設你的知識庫裏存了十幾家上市公司近五年的季報,其中一個切片原文只有一句話:「該公司本季度營收環比增長 3%,主要受雲業務帶動」。當用戶提問「ACME 公司 2023 年二季度營收漲了多少?」時,傳統向量庫和 BM25 都會抓瞎——因為這個小塊裏既沒有 ACME 這個詞,也沒有 2023 年二季度。
經 Contextual Retrieval 預處理後,入庫文本會變成:
text
這段文字摘自 ACME 公司 2023 年第二季度 SEC 財報文件,前文匯報了 2023 年一季度營收為 3.14 億美元。該公司本季度營收環比增長 3%,主要受雲業務帶動。
補上這一句簡短定位後,無論是稠密向量(調用細節可參考 OpenAI Embeddings 向量教學)還是 BM25 詞面匹配,都能一次性精準鎖定公司名稱與季度歸屬。
二、官方標準提示詞與 Prompt Caching 省錢實現代碼
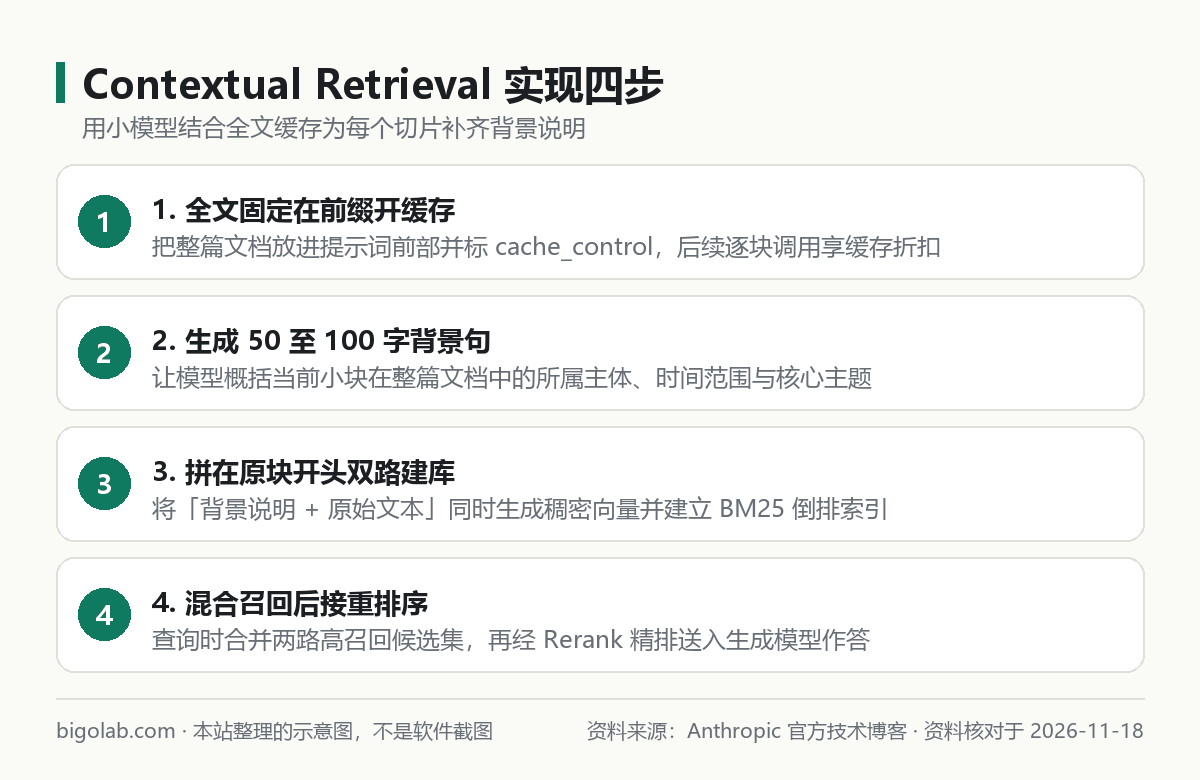
圖:本站根據 Anthropic:Prompt caching 整理的示意圖
如果每處理一個切片都把幾萬字的整篇文檔重新計費一遍,帳單會非常昂貴。官方做法是利用 Claude 的 提示詞緩存(計費倍率與最短緩存門檻詳見 Claude 提示詞緩存入門教學):按「一篇文檔接一篇文檔」順序串行或小並發跑批,把 <document> 全文鎖在前綴加上 "cache_control": {"type": "ephemeral"},5 分鐘有效期內同篇文檔的第 2 至第 N 個切片全部享受緩存命中折扣:
python
import anthropic

client = anthropic.Anthropic()

def situate_chunk(whole_doc: str, chunk_text: str) -> str:
    """結合整篇文檔緩存,為單個切片生成簡短上下文定位說明"""
    resp = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=200,
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": f"<document>\n{whole_doc}\n</document>",
                        "cache_control": {"type": "ephemeral"},  # 固定全文前綴打緩存斷點
                    },
                    {
                        "type": "text",
                        "text": (
                            f"以下是我們需要定位在整篇文檔中的片段:\n<chunk>\n{chunk_text}\n</chunk>\n"
                            "請給出一段簡短精煉的背景說明(50-100字),交代該片段在整篇文檔中的語境以改進檢索效果。"
                            "請只返回這段簡短背景說明本身,不要輸出任何額外解釋。"
                        ),
                    },
                ],
            }
        ],
    )
    context_prefix = resp.content[0].text.strip()
    return f"{context_prefix}\n\n{chunk_text}"
拿到返回的拼接字符串後,把它同時送進向量數據庫生成 Embedding,並送進本地或搜尋引擎的 BM25 分詞索引。實操時請打印 resp.usage.cache_read_input_tokens,確認從第 2 個切片開始該字段大於 0,說明緩存真正生效了(各模型單價速查見 AI 大模型 API 官方價格對比)。
訂閱與帳號準備提示:搭好檢索底座後日常改寫業務代碼可配合 Claude Code 提效,支持在本站開通 Claude Code 訂閱;若註冊官方 API 或網頁帳號時彈出身份核驗卡住,也可查看本站 Claude KYC 人工協助(失敗不收費)。
三、落地上線的三項工程優化細節
- 按業務領域微調背景提示詞:金融財報、法律合同與代碼倉庫需要補齊的要素不同。例如對代碼倉庫做切塊時,可把上述指令微調為「交代該函數所在文件路徑、所屬類職責及上下游調用關係」,命中率比通用模板更高。
- 控制單篇文檔不超模型單次窗口:如果遇到單本長達上百萬 token 的超巨型 PDF,先按大章拆成幾萬 token 一份的獨立父章節作為
<document>,同樣能保留完整語境且不爆窗口。 - 離線批量任務可疊加 Message Batches 批處理:不着急幾分鐘內建完索引的歷史存量文檔,可優先測試批量接口或控制同文檔塊在 5 分鐘緩存 TTL 內緊湊跑完,防止請求間隔過長導致緩存過期重算。
常見問題
問:只往塊首拼「文件名 + Markdown 標題路徑」能不能代替 Contextual Retrieval?
答:拼標題是零成本的基礎操作,建議必做;但如果章節標題只叫「第三節:經營表現」,標題裏依然不含前文提到的年份、幣種單位或對比基準,大模型讀完全文生成的動態背景句能補上靜態標題樹沒有的跨段隱含主語。
問:檢索召回後餵給生成模型時,是喂「原始切片」還是「帶背景說明的拼接切片」?
答:Anthropic 官方方案直接把「背景說明 + 原始切片」一併送給後續 Rerank 重排模型和最終生成大模型。因為前置的那句背景同樣能幫重排器和生成模型看懂代詞指代,防止張冠李戴。
問:文檔局部修訂了一段話,需要整篇重新跑一遍所有切片的背景生成嗎?
答:如果只是改正錯別字或局部數字,只重跑被修改的那一兩個切片即可;但如果修改了文檔開頭的適用對象、生效年份等全局前提,則應整篇重刷以保證各子塊背景一致。
問:人在國內沒有境外信用卡,怎麼訂閱 Claude 會員或為團隊採購報銷開票?
答:可前往本站 AI 會員充值中心 自助選購 Claude Pro 免上號卡密 或 Claude Max 充值服務(無需交出密碼,24 小時自助兌換),支持支付寶、微信支付與 AlipayHK 並可開具增值稅發票;實時價格與售後邊界(掉訂閱按剩餘天數折退,封號不在質保範圍)以頁面展示為準。
相關教學
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
- RAG 檢索增強生成和直接塞長上下文怎麼選:成本、延遲、更新頻率與官方選型判斷框架
- OpenAI Embeddings 向量怎麼用:text-embedding-3-small 調用、dimensions 縮短與搜尋
- AI 大模型 API 價格對比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方價格頁速查
參考資料
- Anthropic 官方技術網誌:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
- Claude API 官方文檔:Prompt caching — https://platform.claude.com/docs/en/build-with-claude/prompt-caching
0 條評論
還沒有評論,來搶沙發~