
結論先說
- 官方提供開箱即用的
docker compose up全棧編排:克隆官方倉庫後一條命令即可拉起 Web 控制檯、異步 Worker、PostgreSQL、ClickHouse、Redis 與 MinIO,無需註冊任何外部雲服務。 - 本機 Docker 至少預留 4GB 以上內存:新版架構依賴 ClickHouse 高速寫入海量調用鏈,內存太小會導致容器反覆重啟或健康檢查超時。
- 上生產前必須改掉預設密鑰:測試跑通後若要對團隊內網暴露,務必修改環境變量中的
NEXTAUTH_SECRET、SALT、ENCRYPTION_KEY與數據庫預設密碼。 - 提示詞管理靠
production標籤加客戶端內存緩存實現零延遲熱更新:運營或研發在網頁後台把新版本切到production標籤後,線上代碼在緩存過期(預設 60 秒)後自動生效,Langfuse 掛掉時 SDK 也會降級使用內存舊緩存不崩業務。 - AI 編程訂閱與團隊採購入口:部署與編寫後端工程可搭配高頻編程助手提效,國內免外幣卡開通可見本站 Claude Code 訂閱說明、ChatGPT Business 團隊定製 與 AI 會員充值中心。
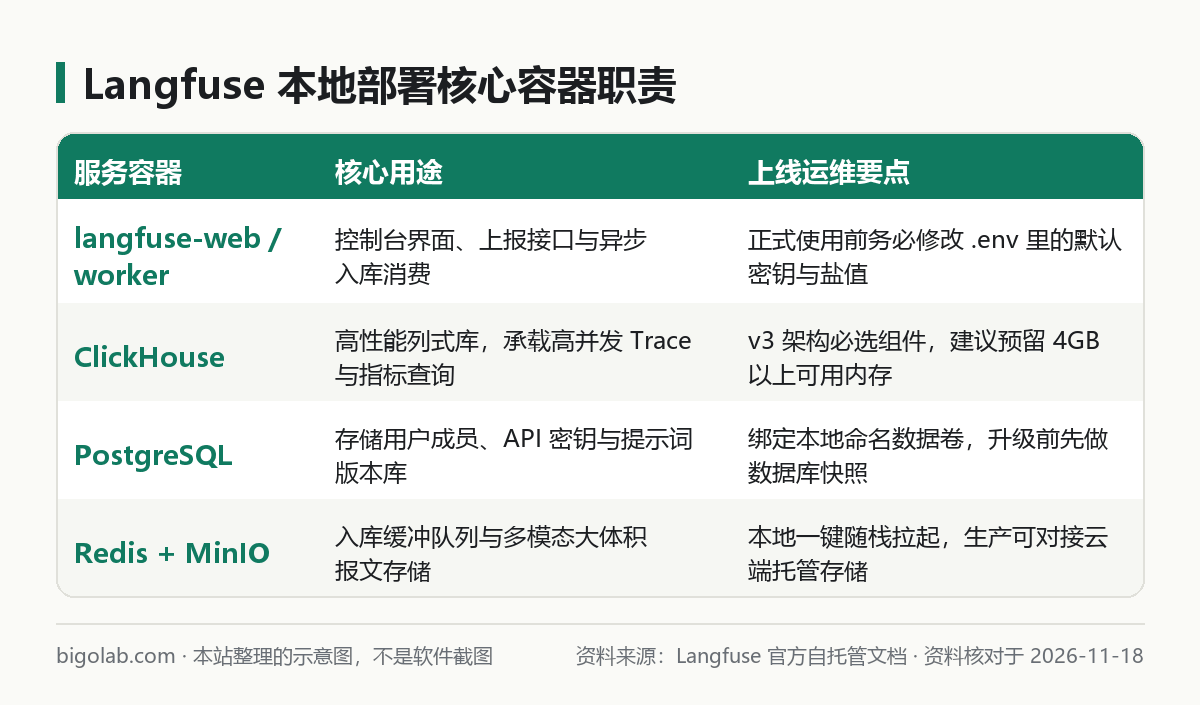
圖:本站根據 Langfuse 官方文檔:Local Deployment 整理的示意圖
本文根據 Langfuse 官方自託管文檔《Local Deployment (Docker Compose)》與《Prompt Management》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Langfuse 官方網站。
適用於誰
- 有數據合規要求,希望把所有用戶對話 Trace、Token 帳單與評測數據完全留在公司自有伺服器或本機的開發團隊;
- 厭倦了每次只改提示詞裏一句話都要走 Git 提交、CI 構建和重新發版流程的工程師;
- 準備用 Docker Compose 在本地快速拉起 Langfuse v3 並跑通第一條提示詞熱加載的人。
一、Docker Compose 本地一鍵部署步驟與資源要求
在裝好 Docker Desktop(macOS / Windows WSL2)或 Linux Docker Engine 的機器上,確保 Docker 可用內存不低於 4GB(推薦 8GB),且本機 3000、5432、8123、9090 等端口未被佔用,按順序執行:
bash
# 1. 克隆官方倉庫並進入目錄
git clone https://github.com/langfuse/langfuse.git
cd langfuse

# 2. 後台啟動完整容器棧(首次拉取鏡像並初始化 ClickHouse 約需 2 至 3 分鐘)
docker compose up -d

# 3. 觀察 langfuse-web 容器日誌,看到 Ready 即可訪問
docker compose logs -f langfuse-web
看到服務就緒後,打開瀏覽器訪問 http://localhost:3000:
- 點擊 Sign up 在本地數據庫創建第一個管理員帳號(數據僅存本機 PostgreSQL,不聯網發送);
- 依次創建 Organization(組織)與 Project(項目);
- 進入項目左側 Settings > API Keys,點擊創建密鑰,複製儲存
pk-lf-...(公鑰)、sk-lf-...(私鑰)以及本地地址http://localhost:3000。
內網長期運行必改項:官方示例編排文件裏硬編碼了演示用密碼與 # CHANGEME 標記。正式給團隊用之前,請用 openssl rand -hex 32 重新生成 NEXTAUTH_SECRET、SALT 與 ENCRYPTION_KEY,並將 NEXTAUTH_URL 改為內網真實訪問域名或 IP 端口。
二、提示詞版本管理(Prompt Management)實戰
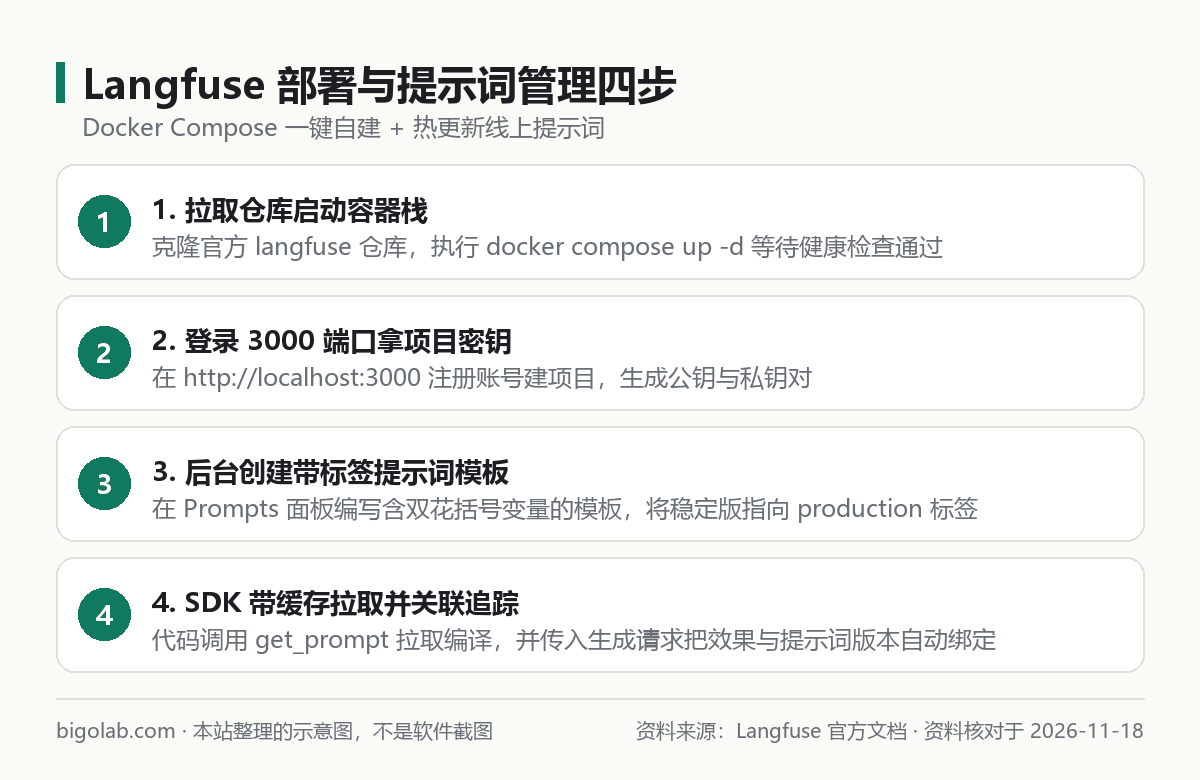
圖:本站根據 Langfuse 官方文檔:Prompt Management 整理的示意圖
把提示詞硬編碼在 Python 代碼裏有兩大痛點:產品經理沒法幫忙調優措辭,而且線上追查 Bug 時不知道昨天下午那條錯答究竟用的是哪一版提示詞。Langfuse 的提示詞中心通過「不可變版本號 + 環境標籤(Labels)」解決這一問題:
- 在控制檯新建模板:點擊左側選單 Prompts > New prompt,名稱填
order-refund-assistant,類型選Chat(對話消息列表)或Text(純文本)。 - 使用雙花括號定義動態變量:在內容框寫入如下結構,勾選底部的 Set the "production" label 儲存為
Version 1:
text
你是企業售後客服助手。請嚴格依據以下制度回答,不要編造條款:
【制度片段】:{{policy_context}}
【用戶提問】:{{question}}- Python 代碼拉取編譯並與調用鏈雙向綁定:安裝
pip install langfuse openai(首次調模型接口可參考 大模型 API 首次調用通用入門),寫入以下代碼:
python
import os
from langfuse import Langfuse
from langfuse.openai import OpenAI

os.environ["LANGFUSE_PUBLIC_KEY"] = "pk-lf-你的公鑰"
os.environ["LANGFUSE_SECRET_KEY"] = "sk-lf-你的私鑰"
os.environ["LANGFUSE_HOST"] = "http://localhost:3000"

langfuse = Langfuse()
client = OpenAI()  # 使用 Langfuse 包裝版客戶端

# 預設拉取 label="production" 的版本,客戶端自動內存緩存 60 秒(0 網絡阻塞)
prompt = langfuse.get_prompt("order-refund-assistant", label="production", cache_ttl_seconds=60)
compiled_text = prompt.compile(
    policy_context="數碼產品拆封激活後無質素問題不支持七天無理由退貨。",
    question="剛激活的平板不喜歡能退嗎?",
)

# 將 langfuse_prompt 傳入請求,後台會自動按提示詞版本號彙總成功率與成本
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": compiled_text}],
    langfuse_prompt=prompt,
)
print(resp.choices[0].message.content)
langfuse.flush()
代碼上線後,如果發現某類邊界問題回答生硬,直接在 localhost:3000 網頁端編輯儲存為 Version 2,先打上 staging 標籤在測試環境驗證,確認無誤後把 production 標籤挪到 Version 2,線上服務無需重啟就會在 1 分鐘內平滑切換過去。
訂閱與帳號準備提示:在本地調試 Docker 編排報錯或編寫後端服務時,配合終端智能體可大幅減少查日誌時間(入門見 Claude Code 中文入門教學);國內開發者可在本站免外幣卡自助開通 Claude Pro 或大額度的 Claude Max。
三、成本核算與緩存架構聯動建議
Langfuse 內置了主流模型的公開價格表,也可以在控制檯 Models 頁添加企業私有化部署模型的自定義單價(官方公開價格速查見 AI 大模型 API 價格對比)。當你在管理十幾萬字長系統提示詞模板時,記得把固定規則放在 system 頂部、動態 {{question}} 放在末尾,避免破壞模型廠商的前綴提示詞緩存(原理見 RAG 與長上下文加提示詞緩存選型框架)。
常見問題
問:執行 docker compose up -d 後 langfuse-web 反覆報錯退出怎麼辦?
答:九成是 clickhouse 或 postgres 容器還沒初始化完畢,或者宿主機內存不足導致 ClickHouse 被系統 OOM 殺掉。運行 docker compose ps 檢查各依賴容器是否為 healthy,清理無用鏡像釋放內存後再執行 docker compose up -d。
問:萬一自建的 Langfuse 容器重啟維護,會導致線上業務調 get_prompt 全部報錯癱瘓嗎?
答:只要該進程啟動後成功拉取過一次提示詞,SDK 就算遇到後台網絡超時也會自動回退使用內存裏的舊緩存副本繼續服務;冷啟動防災還可在 get_prompt(..., fallback="兜底提示詞") 參數裏傳入本地硬編碼兜底文本。
問:後續怎麼安全升級本地 Docker 版本的 Langfuse?
答:先對 PostgreSQL 數據卷做一次 pg_dump 備份,再拉取最新倉庫配置或修改鏡像版本號執行 docker compose pull && docker compose up -d,容器啟動時會自動按序執行數據庫與 ClickHouse 表結構遷移腳本。
問:國內個人或研發團隊沒有外幣信用卡,怎麼訂閱 AI 編程會員或開具報銷發票?
答:可前往本站 AI 會員充值中心 自助兌換 Claude Pro 卡密、ChatGPT Plus 或諮詢團隊定製(自助卡密無需提供帳號密碼),支持支付寶、微信支付與 AlipayHK 付款並支持開具增值稅發票;實時價格與售後邊界(掉訂閱按剩餘天數折退,封號不在質保範圍)以頁面展示為準。
相關教學
- 大模型 API 怎麼用:從申請 Key 到第一次調用,OpenAI、Claude、Gemini 通用入門
- AI 大模型 API 價格對比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方價格頁速查
- RAG 檢索增強生成和直接塞長上下文怎麼選:成本、延遲、更新頻率與官方選型判斷框架
- Claude Code 中文入門教學(2026):安裝、登入、第一個任務、常用命令
參考資料
- Langfuse 官方自託管文檔:Local Deployment (Docker Compose) — https://langfuse.com/self-hosting/local
- Langfuse 官方文檔:Prompt Management Get Started — https://langfuse.com/docs/prompts/get-started
- Langfuse 官方 GitHub 倉庫 — https://github.com/langfuse/langfuse
0 條評論
還沒有評論,來搶沙發~