
結論先說
- Prompt Caching 和 Message Batches 完全可以合法疊加,是官方離線降本的王炸組合:異步批處理本身享半價折扣,再加上共享長前綴命中緩存的高額折扣,大批量固定規則任務的綜合輸入成本能壓到常規同步調用的零頭。
- 在異步批處理裏強烈建議把緩存設為
"ttl": "1h"(1 小時):因為 Batches 是後台隊列異步分波調度的,跨度一旦超過 5 分鐘,預設的"5m"緩存就會在半途過期導致重複寫入扣費。 - 批內緩存屬於「盡力而為(Best-effort)」並發匹配:如果第一波幾十個請求在同一毫秒並發落地而緩存尚未寫完,前幾個請求可能會同時觸發寫入,建議可先發單條同步請求「預熱建好緩存」再投遞大批量任務。
- 驗證提示詞模板或領取會員附贈 API 額度:上線大規模批處理前建議先在網頁端調準規則,或利用高階訂閱附贈的月度開發額度試跑,可查看本站 Claude Max 充值說明 與 Claude Pro 充值頁。
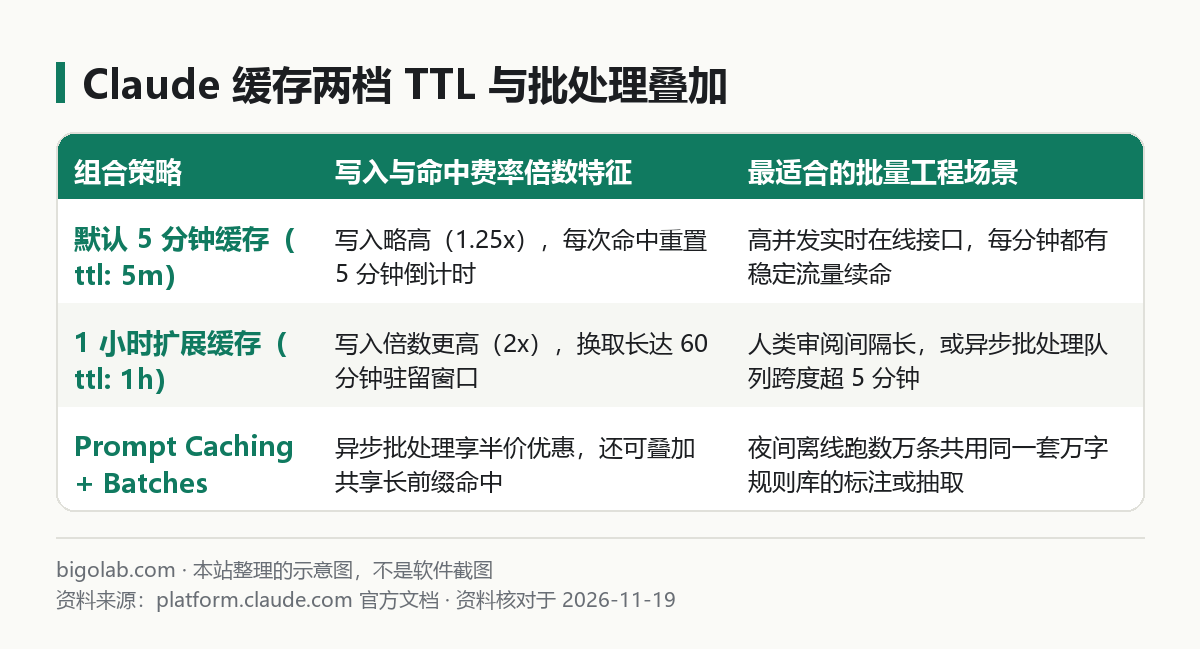
圖:本站根據 Anthropic 官方緩存與批處理文檔 整理的費率倍數與場景對比圖
本文根據 Anthropic 官方開發者文檔《Prompt caching》《Message Batches》(platform.claude.com/docs)整理,資料核對於 2026-11-19。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 要在夜間離線跑幾千甚至幾萬條工單分類、簡歷初篩或文檔結構化提取,每條請求都掛着同一套兩萬字規則手冊的後端工程師;
- 已經分別看過提示詞緩存(本站 222 號文)和異步批處理(本站 1844 號文),想知道把兩者疊在一起到底怎麼寫代碼、為什麼預設 5 分鐘緩存在大批次裏容易半路斷掉的人;
- 糾結
cache_control裏的"ttl": "5m"和"ttl": "1h"寫入差價怎麼算回本的架構師。
一、5m 與 1h 兩檔 TTL 怎麼算回本,為什麼批處理偏愛 1h
如果你還不熟悉兩個單項基礎概念,可以先回顧本站 Claude 提示詞緩存基礎教學 與 Claude API Message Batches 批處理入門。把兩者合體時,核心算術題就在 ttl 參數上:
- 預設 5 分鐘檔(
"ttl": "5m",省略不填即為此檔):首次寫入緩存按基礎輸入價的 1.25 倍 計費,只要 5 分鐘內有下一次請求命中,倒計時就自動重置回 5 分鐘。非常適合白天每秒都有用戶訪問的在線客服機器人——只付一次 1.25 倍寫入費,能靠源源不斷的流量續命一整天。 - 擴展 1 小時檔(
"ttl": "1h"):首次寫入按基礎輸入價的 2 倍 計費,換來整整 60 分鐘免刷新的穩固駐留期。非常適合兩種情況:一是人類每隔二十分鐘才回來審一次方案的慢節奏代碼助手;二是後台排隊執行耗時十幾到幾十分鐘的 Message Batches 異步任務。只要同一批次裏有三四條以上的請求成功讀到緩存,多付的那一點首次寫入費瞬間就賺回來了。
長文檔精讀與高頻生產力訂閱入口:無論是往 Projects 掛載幾十份背景資料、審閱幾十頁英文商業合同,還是連續繪製複雜架構圖,免費版短窗口配額極易受限。國內用戶可通過本站支付寶、微信支付或 AlipayHK 免上號自助開通 Claude Pro 會員(直達單品 Pro iOS 自助充值)或大額度 Claude Max 充值。
二、Python 完整實戰代碼(預熱緩存 + 投遞 1h 批處理 + 核驗命中)
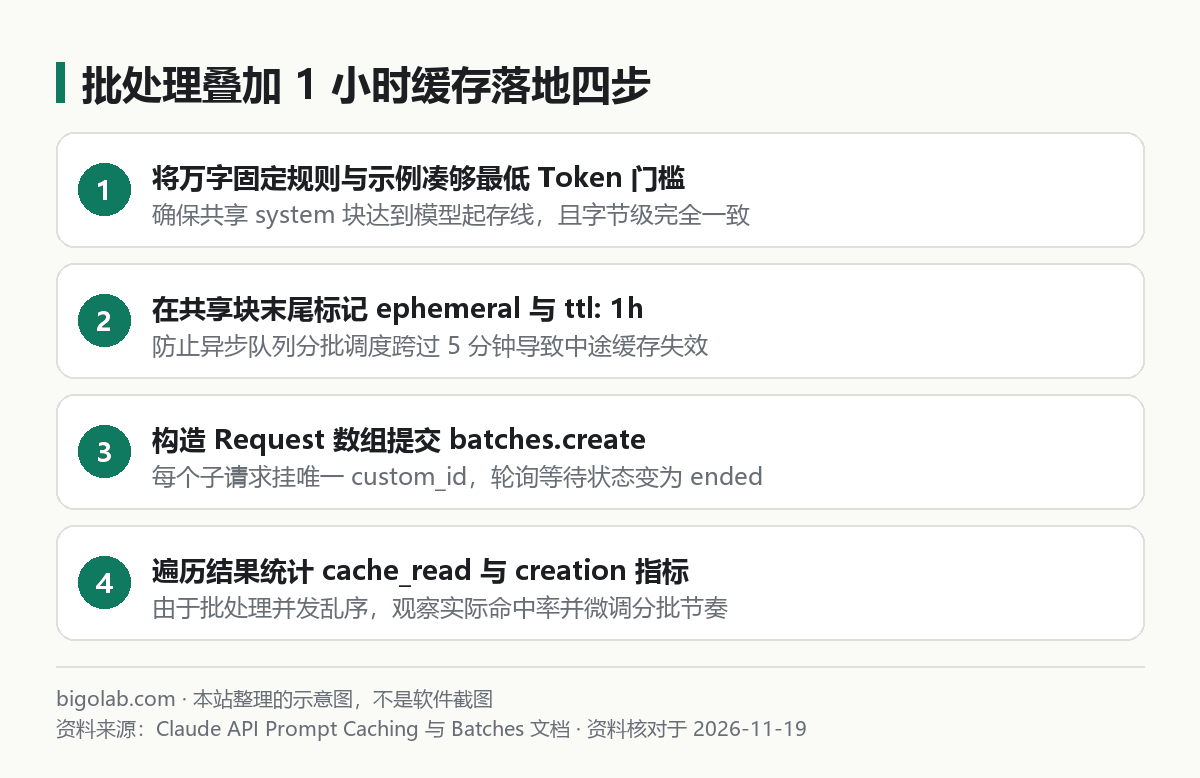
圖:本站根據 Claude API 官方文檔 整理的四步架構落地示意圖
為了讓整批幾千條請求幾乎百分之百命中讀取折扣、避開首波並發重複寫入,工程上最穩的做法是先用一條輕量請求把 1 小時緩存熱好,緊接着立刻把整包 Batch 推進去(API 密鑰準備見 Claude Console 獲取 API Key 指南,計算前綴有沒有達標可用 Count Tokens 接口教學):
python
import time
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()
MODEL_ID = "claude-sonnet-5-5"

# 注意:共享長前綴必須達到對應模型的最低起存 Token 門檻,且所有請求中字節級一字不差
shared_system_blocks = [
    {
        "type": "text",
        "text": open("enterprise_classification_manual.md", encoding="utf-8").read(),
        "cache_control": {"type": "ephemeral", "ttl": "1h"},
    }
]

# 第一步(推薦技巧):先發 1 條極短同步請求完成緩存首次寫入預熱
client.messages.create(
    model=MODEL_ID,
    max_tokens=16,
    system=shared_system_blocks,
    messages=[{"role": "user", "content": "回覆就緒即可"}],
)

# 第二步:組裝共享完全相同 system 前綴的大批量異步請求
tickets = [("ticket-001", "退款一直沒到賬"), ("ticket-002", "發票抬頭填錯了怎麼重開")]
requests_payload = [
    Request(
        custom_id=cid,
        params=MessageCreateParamsNonStreaming(
            model=MODEL_ID,
            max_tokens=512,
            system=shared_system_blocks,
            messages=[{"role": "user", "content": body}],
        ),
    )
    for cid, body in tickets
]

batch = client.messages.batches.create(requests=requests_payload)

# 第三步:輪詢等待異步批處理變為 ended 並核查緩存讀取指標
while True:
    status = client.messages.batches.retrieve(batch.id)
    if status.processing_status == "ended":
        break
    time.sleep(20)

for item in client.messages.batches.results(batch.id):
    if item.result.type == "succeeded":
        u = item.result.message.usage
        print(item.custom_id, "緩存寫入:", u.cache_creation_input_tokens, "緩存讀取命中:", u.cache_read_input_tokens)
常見問題
問:我已經照抄加上了 cache_control,為什麼跑完看 cache_read_input_tokens 全是 0?
答:排查兩件事:第一,你的 enterprise_classification_manual.md 總字數太短,沒跨過所選模型的最低緩存起存門檻(未達標時服務端不會報錯,而是靜默當普通無緩存請求處理);第二,你在拼裝每條子請求的 system 字符串時混入了當前時間戳或變動編號,破壞了從頭開始逐字節完全一致的前綴匹配鐵律。
問:如果一個超大批次排了整整 4 個小時才跑完,1h 緩存中途還是過期了會報錯嗎?
答:完全不會報錯失敗。緩存過期後,下一波被調度到的子請求只是自動重新觸發一次緩存寫入並開啟新的 1 小時窗口,後續子請求接着繼續命中。你也可以把幾萬條超大任務按每兩三千條一包分批投遞,命中率更可控。
問:訂閱了 Claude Max 會員送的月度 API 額度能用來跑這個批處理接口嗎?
答:只要在 Anthropic Console 正常綁定領取了計劃附贈的 API 額度(綁定方法見 Claude Max 與 Team 月度贈送 API 額度領取教學),該額度在 Console 組織帳戶裏同樣可用於常規 Messages 與 Batches 接口調用。
問:新註冊 Claude 收不到手機驗證碼,或者沒有外幣卡怎麼開通 Pro / Max 會員?
答:註冊受阻可先看本站 Claude 註冊與普號說明頁;已有帳號升級會員可直接前往 Claude Pro 充值頁 或 Claude Max 充值頁 獲取自助卡密兌換,支持開具增值稅發票,實時價格與售後邊界(封號不在質保範圍)見各商品頁。
0 條評論
還沒有評論,來搶沙發~