
結論先說
- 快篩與精讀應當分工:在 Zotero 內置閱讀器裝 Translate for Zotero 插件負責摘要與圖注的即時劃詞翻譯;確定要精讀的核心文獻,再把原 PDF 或高亮筆記餵給 Claude / ChatGPT 深挖方法細節。
- 切勿在未脫敏情況下上載未發表審稿件:同行評審(Peer Review)保密稿件或涉密課題數據嚴禁傳給外部商業模型,僅對已公開出版的 arXiv、IEEE、ACM、Nature 等文獻使用雲端精讀。
- 批註轉 Markdown 是最省額度的上下文喂法:利用 Zotero 右側「從批註添加條目筆記(Add Item Note from Annotations)」,只把你標黃的核心段落導出提問,比整本塞入幾十頁附錄更聚焦。
- 參考文獻格式一律由 Zotero 本地生成,絕不讓 AI 默寫引文:只允許大模型基於你實際投餵的真實 PDF 總結觀點,正文中插入 BibTeX 或 GB/T 7714 引文全部走 Zotero Word 插件自動生成。
- 長文獻多篇對比主力訂閱入口:一次性投餵多篇雙欄長 PDF 做橫向綜述極吃上下文窗口,國內無外幣卡可在本站自助開通 Claude Pro 或 ChatGPT Plus。
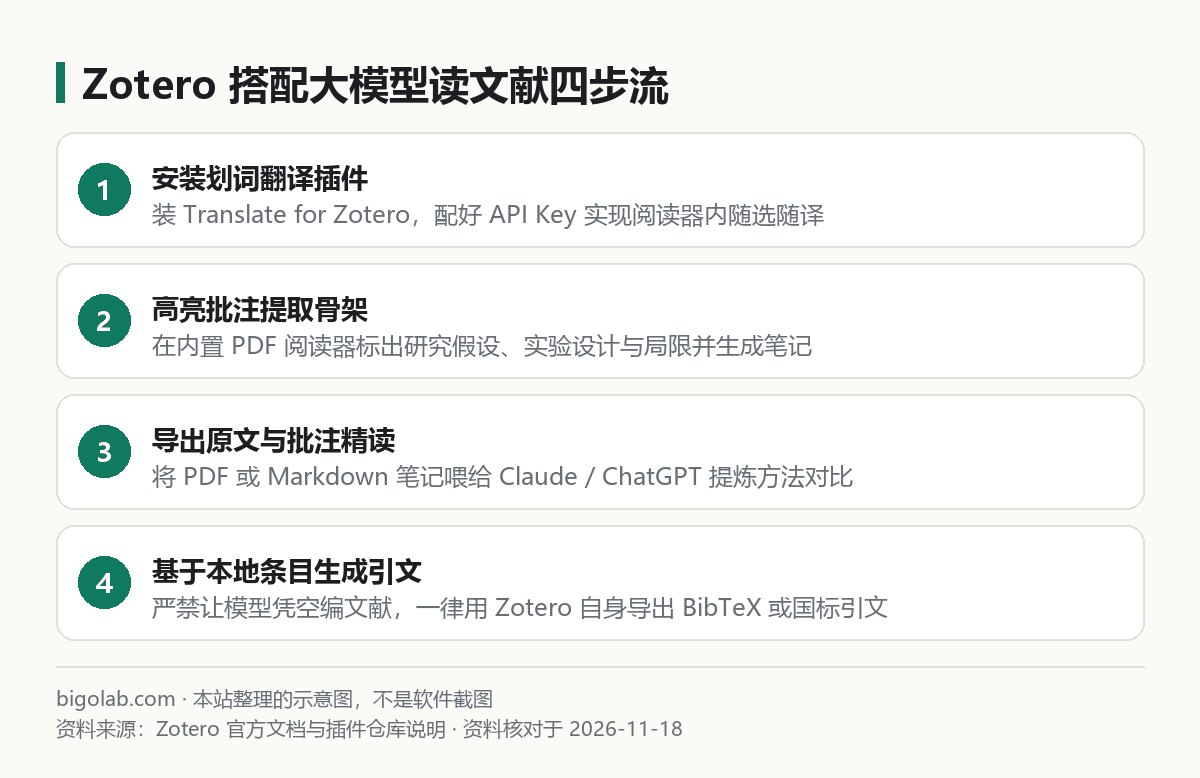
圖:本站根據 Zotero 官方文檔:PDF Reader and Note Editor 整理的示意圖
本文根據 Zotero 官方文檔《Zotero PDF Reader and Note Editor》及開源插件 Translate for Zotero 說明整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Zotero、Anthropic 或 OpenAI 官方網站。
適用於誰
- 每天要在 Zotero 裏篩讀大量英文期刊或頂會 PDF,希望邊看邊劃詞翻譯專業長難句的研究生與科研人員;
- 想把多篇文獻的實驗設定、基線指標和研究侷限交給 Claude 或 ChatGPT 做橫向對比表的人;
- 擔心大模型編造不存在的論文標題、假作者或錯誤 DOI,需要建立合規文獻綜述流程的寫作者。
一、在 Zotero 閱讀器配置大模型劃詞翻譯插件
Zotero 7 原生內置了響應很快的標籤頁 PDF 閱讀器,配合開源插件 Translate for Zotero(倉庫名 zotero-pdf-translate)即可實現選中英文自動在右側欄顯示專業譯文,整篇長文檔翻譯的通用原則也可參考 AI 翻譯 PDF 和長文檔完整流程。
配置步驟如下:
- 安裝
.xpi插件包:前往 GitHub 倉庫 Releases 頁面下載最新.xpi文件,打開 Zotero 頂部選單「工具(Tools)> 插件(Plugins)」,點擊右上角齒輪圖標選「Install Plugin From File...」導入啟用。 - 填入官方大模型翻譯源:打開「編輯(Edit)> 設定(Settings)> 翻譯(Translate)> 服務(Service)」,選擇 OpenAI 或兼容大模型通道,填入你在官方平台申請的 API Key(申請方法見 OpenAI API Key 怎麼獲取 與 Claude API Key 怎麼獲取)。
- 選輕量高速模型降延遲:劃詞翻譯每次只發一兩句話,不需要昂貴的推理模型,優先填輕量快速檔(如
gpt-4o-mini或 Haiku 檔),並在系統提示詞加上「保留本學科英文專業縮寫,在首次出現處用括號附原文」。 - 閱讀器內隨選隨存:雙擊打開任意 PDF 文獻,滑鼠框選摘要或圖表說明即可在右側面板看到譯文;點擊面板上的「添加到批註」還能把雙語對照直接存進高亮卡片。
二、導出高亮批註餵給 Claude / ChatGPT 做單篇與多篇精讀
篩出值得深讀的 3–5 篇核心文獻後,不建議只在窄小的側邊欄逐句翻譯,而是結合 Zotero 官方批註導出與長窗口網頁端(如 Claude Projects 或 ChatGPT Projects)做結構化拆解,完整綜述提綱寫法見 用 AI 讀論文、做文獻綜述的流程。
- 在 Zotero 提取核心高亮:邊看邊用不同顏色標記(如黃色標研究痛點、綠色標核心公式與架構、紅色標實驗侷限),點右側筆記面板加號「Add Item Note from Annotations」,右鍵該筆記導出為 Markdown。
- 上載原 PDF 或批註筆記發問:將核心 PDF 連同你自己的批註疑問一起上載,複製以下防幻覺精讀提示詞:
text
請僅嚴格依據我上載的這幾篇論文 PDF 原文回答,禁止引入外部未提及的猜測:
1. 用 Markdown 表格對比各篇的【核心解決問題、輸入輸出假設、關鍵創新模組、所用數據集與評估指標】;
2. 每一格結論後必須用括號標註原文所在的【文件名 + 頁碼 + 章節/圖表號】(如 PaperA, p.4, Table 2),方便我回 Zotero 核對;
3. 單獨列出作者在 Discussion 或 Limitations 章節承認的適用邊界,若原文未寫請直接填「原文未說明」。科研課題組與個人長文本訂閱提示:連續上載十幾篇高密度英文頂會 PDF 極易撞上免費版每日文件與消息配額上限。若國內沒有雙幣信用卡或課題組報銷需要正規票據,可前往本站開通 Claude Pro(長文檔細節定位與圖表解讀表現突出)或 ChatGPT Plus,更多套餐與開票說明見 AI 會員充值中心。
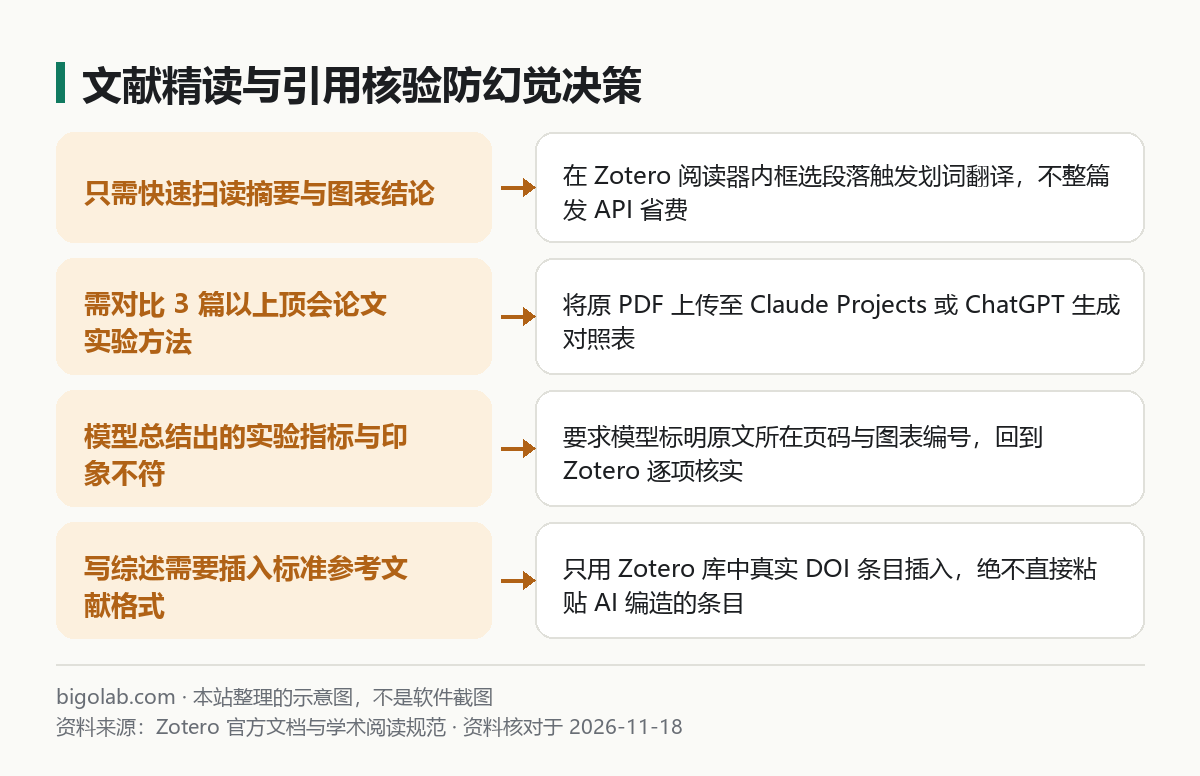
圖:本站根據 Zotero 官方文檔:PDF Reader and Note Editor 整理的示意圖
三、嚴守學術紅線:杜絕 AI 捏造參考文獻的三步核驗法
直接對大模型說「幫我推薦 10 篇近三年關於某某方向的參考文獻並給出國標格式」,極高概率會得到真實學者姓名 + 拼湊出來的假標題 + 指向毫不相關文章的假 DOI。正確分工必須遵循以下鐵律(更多學術寫作提示詞見 Claude 論文寫作提示詞 與 用 ChatGPT 做論文開題和文獻綜述):
- 找文獻走學術檢索庫而非純聊天生成:用大模型幫你把中文研究點發散成地道英文檢索布爾表達式(如
("retrieval augmented generation" OR RAG) AND ("table parsing" OR "financial report")),自己去 Google Scholar、Web of Science 或 Semantic Scholar 檢索並通過 Zotero Connector 瀏覽器插件抓入本地庫。 - 按頁碼回查實驗數字:凡是要寫進你開題報告或論文 Related Work 裏的具體提升百分比、參數量,必須順着模型標註的
Table X / Section Y在 Zotero 原文裏親眼核實一遍。 - 引文格式化 100% 交給 Zotero:寫作時只讓模型幫你潤色邏輯銜接句,文內角標與文末 Reference 列表統一用 Zotero 的 Word / LaTeX(Better BibTeX)插件從你已核實的本地文獻庫一鍵生成。
常見問題
問:雙欄排版的英文 PDF 框選跨列句子時,換行符把一句話截斷導致翻譯不通順怎麼辦?
答:Translate for Zotero 插件在設定中預設提供「自動拼接PDF換行符」選項,開啟後會自動把段內硬回車替換為空格再發給大模型接口,遇到公式與上下標交叉處可手動框選單欄段落。
問:能不能直接讓第三方插件掃描我整個 Zotero 文獻庫幾百篇 PDF 自動建知識庫?
答:技術上雖有開源問答擴展支持,但幾百篇英文長論文全量切塊調雲端 API 會瞬間消耗數百萬 Token 併產生高昂帳單。更穩妥省錢的做法是按子課題建 Zotero 分類文件夾,每次只挑最核心的 5–10 篇放進 Claude Projects 做專題精讀。
問:用大模型幫忙潤色英文論文初稿算不算學術不端?
答:取決於目標期刊或高校的最新聲明規範。主流出版商(如 Elsevier、Springer Nature、IEEE)普遍禁止將 AI 列為共同作者或直接生成無核實的實驗論述,但多數允許作者在規定範圍內用於語言語法潤色,並要求在文末方法或致謝/聲明處按期刊模板如實披露所使用的工具名稱與用途。
問:國內學生和科研人員沒有外幣卡,怎麼訂閱 Claude Pro 或 ChatGPT Plus 讀文獻,能開發票報銷嗎?
答:可在本站 Claude Pro 充值頁、ChatGPT Plus 充值頁 或 AI 會員充值總覽 自助下單,支持支付寶、微信支付及 AlipayHK,提供免交帳號密碼的自助卡密充值方式,並支持開具國內增值稅發票供課題組與企業合規報銷;實時價格與售後保障(掉訂閱按剩餘天數折退,封號不在質保範圍)以商品頁說明為準。
相關教學
- 用 AI 讀論文、做文獻綜述的流程:單篇精讀、多篇對比、綜述提綱與引文核對
- Claude 論文寫作提示詞:選題、文獻梳理、大綱、修改的可複製模板
- 用 ChatGPT 做論文開題和文獻綜述:選題、研究問題到開題提綱
- AI 翻譯 PDF 和長文檔:術語表、分段翻譯、雙語校對的完整流程
參考資料
- Zotero 官方文檔:Zotero PDF Reader and Note Editor — https://www.zotero.org/support/pdf_reader
- Translate for Zotero 開源插件文檔 — https://github.com/windingwind/zotero-pdf-translate
- OpenAI API 官方接口參考 — https://platform.openai.com/docs/api-reference/chat
- Anthropic Claude API 官方文檔 — https://docs.claude.com/en/api/messages
0 條評論
還沒有評論,來搶沙發~