
結論先說
- Obsidian 接入 AI 問答主要靠兩款開源社區插件:偏重側邊欄對話與
@筆記精準引用的選 Copilot for Obsidian,偏重雙鏈語義自動推薦與全庫塊級檢索的選 Smart Connections。 - 問答配置必須拆開看「對話模型」和「向量(Embedding)模型」兩項:即便對話選 Claude 或 GPT,也應注意 Claude 官方不直接提供通用文本 Embedding 接口,向量索引通常搭配 OpenAI Embedding 或本地 Ollama 嵌入模型完成。
- 連接本地 Ollama 必配跨域白名單環境變量:Obsidian 桌面端請求發自
app://obsidian.md,未設定OLLAMA_ORIGINS時會被 Ollama 預設攔截並報連接失敗。 - 私隱敏感倉庫務必先設排除目錄再建索引:在插件的排除文件夾(Excluded folders)填入日記、財務帳單、客戶資料和密鑰筆記路徑,防止全庫掃描時誤傳雲端。
- 長文深度整理與日常主力會員入口:若插件 API 按量計費難以預估,日常寫長篇綜述也可將脫敏筆記直接粘入網頁端或桌面端對話,無外幣卡可在本站開通 Claude Pro 或 ChatGPT Plus。
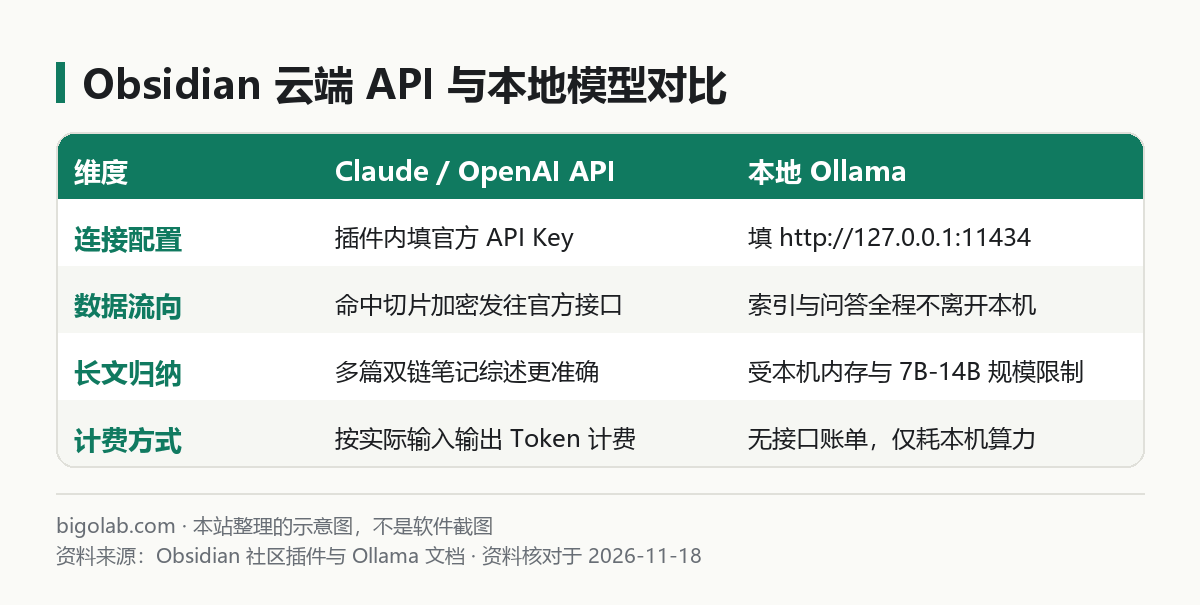
圖:本站根據 Obsidian 官方幫助:Community plugins 與 Ollama 官方文檔 整理的示意圖
本文根據 Obsidian 官方幫助中心《Community plugins》、Copilot 與 Smart Connections 開源倉庫說明及 Ollama 官方文檔整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Obsidian、Anthropic 或 OpenAI 官方網站。
適用於誰
- 在 Obsidian 積累了上百篇雙鏈 Markdown 筆記,想按語義檢索舊想法、跨多篇讀書筆記做彙總提問的人;
- 糾結用 Claude / OpenAI 雲端 API 還是本地 Ollama 模型,不清楚哪些內容會被髮往外部伺服器的人;
- 配置本地 Ollama 時遇到連不上
11434端口、跨域報錯(CORS)或全庫向量索引卡死的用戶。
一、主流插件選型:Copilot 與 Smart Connections 怎麼選
首次安裝前,需在 Obsidian 左下角打開「設定(Settings)> 第三方插件(Community plugins)」,點擊「關閉安全模式(Turn on community plugins)」,再進入「瀏覽(Browse)」搜尋安裝:
| 維度 | Copilot for Obsidian | Smart Connections |
|---|---|---|
| 核心定位 | 側邊欄聊天助手、選中文本改寫續寫、Vault QA 全庫問答 | 自動發現語義相近筆記段落、構建本地向量連接圖譜與對話 |
| 上下文指定方式 | 支持輸入 @筆記標題、#標籤 或當前活動標籤頁精準餵給模型 | 自動檢索全庫相似度最高的 Markdown 標題塊拼入提示詞 |
| 模型支持範圍 | 原生支持 Anthropic Claude、OpenAI、Gemini 與本地 Ollama | 支持本地內置輕量嵌入模型、Ollama 及主流雲端官方 API |
建議只保留其中一款開啟全庫向量索引,同時啟用兩款向量插件會導致每次儲存 Markdown 文件時雙倍計算嵌入向量,拖慢筆記軟件響應。
二、接入 Claude、ChatGPT 官方 API 與本地 Ollama 步驟
1. 配置雲端官方 API Key
先在各廠商開發者後台申請密鑰(步驟見 Claude API Key 怎麼獲取 與 OpenAI API Key 怎麼獲取),隨後在插件設定面板操作:
- 進入「設定(Settings)> Copilot(或 Smart Connections)> Model / API 設定」;
- 在對應廠商欄填入
Anthropic API Key或OpenAI API Key; - 關鍵細節:若聊天模型選了 Claude(如 Sonnet 系列),切到「Embedding Model(嵌入模型)」選項卡時不要留空,需指定 OpenAI 的
text-embedding-3-small或本地 Ollama 嵌入模型,否則全庫Vault QA無法建立本地向量庫。
2. 配置本地 Ollama 實現零外發離線問答
若筆記內容涉密不允許離開本機,先按 Ollama 怎麼用:安裝、下載模型與常用命令 拉取對話模型與中文向量模型:
bash
ollama pull qwen2.5:7b
ollama pull bge-m3
接着配置跨域放行(否則 Obsidian 內部 WebView 請求 http://127.0.0.1:11434 會返回 403 或連接錯誤):
- macOS / Linux:終端執行
launchctl setenv OLLAMA_ORIGINS "app://obsidian.md*"(Linux 寫入 systemd 服務環境變量)並重啟 Ollama; - Windows:在系統環境變量新建用戶變量
OLLAMA_ORIGINS,值填app://obsidian.md(或測試期填),徹底退出右下角托盤羊駝圖標後重開。
最後在 Obsidian 插件中將服務地址設為 http://127.0.0.1:11434(兼容模式填 /v1,詳見 Ollama API 本地接口與 OpenAI 兼容寫法),對話模型填 qwen2.5:7b,嵌入模型填 bge-m3。
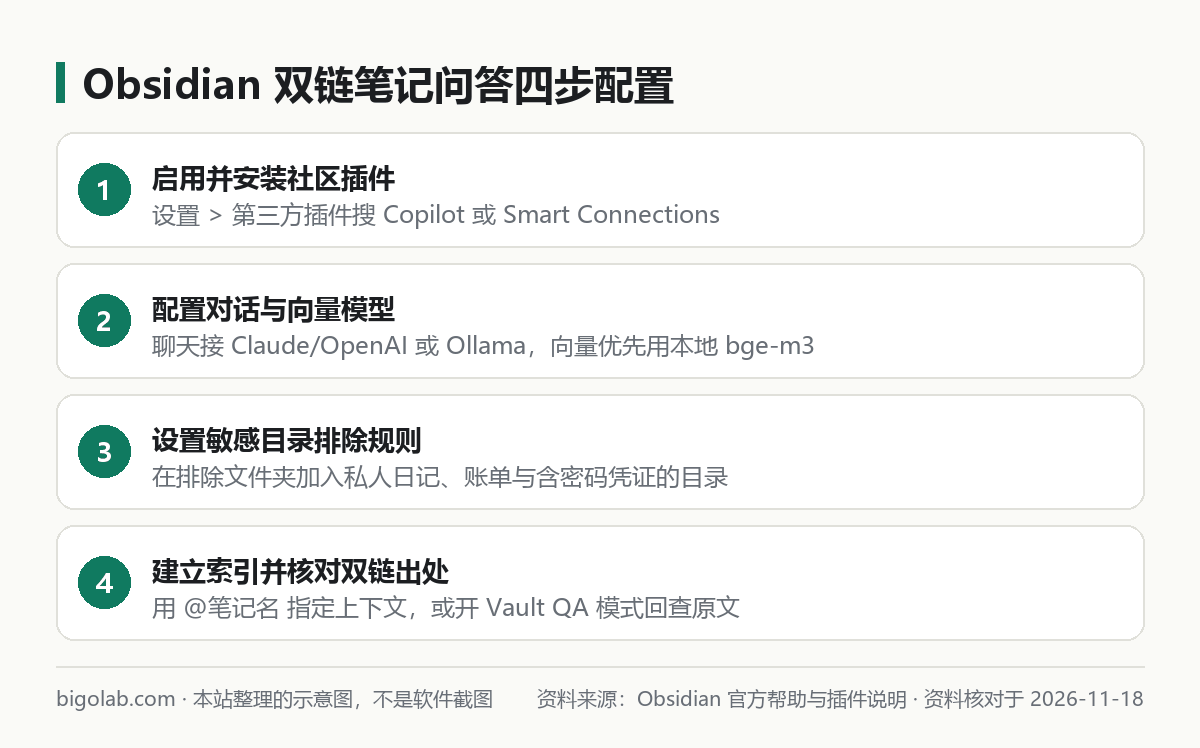
圖:本站根據 Obsidian 官方幫助:Community plugins 整理的示意圖
深度閱讀與編程聯動訂閱提示:插件內調 API 按每次塞入的筆記切片字數計費,頻繁全庫問答帳單容易超支。若你想把幾十篇公開讀書筆記導出給高階模型做深度綜述,或直接用終端工具操作本地 Markdown 倉庫,可在本站自助開通固定月費的 Claude Pro、Claude Code 或 ChatGPT Plus。
三、私隱脫敏邊界:哪些數據會上載、怎麼隔離敏感目錄
很多用戶誤以為「筆記文件存在本機硬碟,裝個插件提問就不會泄密」,實際數據流向取決於你配置的組合,通用安全核查可對照 AI 使用私隱與數據安全清單:
- 純本地組合(Ollama 對話 + Ollama / 本地內置 Embedding):建索引與生成回答全程在本機內存完成,斷網也能運行,沒有任何字符發往外部。
- 混合組合(本地 Embedding + 雲端 Claude / OpenAI 對話):平時寫筆記建索引不聯網;但當你發起
Vault QA提問時,插件會把檢索命中的那幾段筆記原文連同你的問題一起通過 HTTPS 發給官方 API 伺服器。 - 必做的三條脫敏防線:
- 在插件設定找到
Excluded folders / Exclusions,把日記/、財務/、密碼與憑證/等私有目錄加進去,建索引前先設好; - 不要用雲端 API 全庫問答模式直接掃未過濾的整個倉庫,改用單次對話手動
@公開筆記名定向投餵; - 團隊或企業內部文檔確認所綁定的官方 API 帳號不屬於免費公開訓練層級(官方商業 API 預設不將接口輸入用於訓練基座模型,具體以各家 API 數據私隱條款為準)。
常見問題
問:我已經開通了網頁版 ChatGPT Plus 或 Claude Pro 會員,能免 API Key 直接填進 Obsidian 插件嗎?
答:不能。網頁版個人訂閱額度和開發者平台的 API 餘額是兩套完全獨立的計費體系,Obsidian 社區插件走的是官方 HTTP API 接口,必須填入開發者後台生成的 API Key 按實際 Token 結算,切勿在第三方未知插件中填入網頁帳號 Cookie 以防觸發風控封號。
問:幾千篇雙鏈筆記第一次建向量索引非常慢、風扇狂轉怎麼辦?
答:首次全庫向量化需要對每篇文檔分塊推理,建議先通過排除規則過濾掉附件目錄、Excalidraw 畫板源碼文件(.excalidraw.md 體積巨大且無問答價值)和歷史歸檔目錄,並使用輕量級向量模型如 nomic-embed-text 或 bge-m3。
問:為什麼 AI 回答時沒有理解筆記之間的 [[雙鏈]] 跳轉關係?
答:常規向量檢索只按單段文本語義相似度召回切片,不會自動順着雙鏈展開多層鄰居節點。提問時可在 Copilot 輸入框顯式用 @ 同時掛載主筆記與關聯筆記,讓模型一次性讀全上下文。
問:國內沒有境外信用卡,想開通 Claude Pro、ChatGPT Plus 配合整理筆記怎麼辦理,支持報銷開票嗎?
答:可前往本站 Claude Pro 充值頁、ChatGPT Plus 充值頁 或 AI 會員充值中心 下單,支持支付寶、微信支付與 AlipayHK 付款,提供無需交出密碼的自助卡密兌換模式,企業與科研課題組採購可開具國內增值稅發票;實時價格與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以頁面展示為準。
相關教學
- Ollama 怎麼用:安裝、下載模型與常用命令(Windows / macOS / Linux)
- Ollama API 調用教學:本地接口地址、Python 調用與 OpenAI 兼容寫法
- Claude API Key 怎麼獲取:Claude Console 創建密鑰、充值與用量查看
- AI 使用私隱與數據安全清單:哪些不能輸入、訓練開關在哪關
參考資料
- Obsidian 官方幫助文檔:Community plugins 安全與管理 — https://help.obsidian.md/Plugins/Community+plugins
- Copilot for Obsidian 官方開源倉庫說明 — https://github.com/logancyang/obsidian-copilot
- Smart Connections 官方開源倉庫說明 — https://github.com/brianpetro/obsidian-smart-connections
- Ollama 官方 API 文檔 — https://docs.ollama.com/api
0 條評論
還沒有評論,來搶沙發~