
結論先說
- 完全不依賴 LangChain 框架也能獨立使用:只要安裝極輕量的
langsmithSDK,用一行wrap_openai或wrap_anthropic加上@traceable裝飾器,就能把純原生 Python / TypeScript 代碼的完整調用樹上報到控制檯。 - LangGraph 與 LangChain 項目真正零改代碼:只需在環境變量裏設好
LANGSMITH_TRACING=true與LANGSMITH_API_KEY,所有圖節點流轉、條件邊跳轉與工具返回會自動串成嵌套火焰圖。 - 自動折算 Token 成本與緩存明細:控制檯會按模型公開單價自動統計輸入、輸出及提示詞緩存命中 Token,哪一步燒錢一眼可見(各家單價對照見 AI 大模型 API 官方價格對比)。
- 個人 Developer 檔自帶月度免費額度:註冊即送單人工作區與月度免費基礎 Trace 配額(超額前適合個人開發聯調,預設留存期較短),日誌異步後台上報不阻塞主業務響應。
- AI 編程工具與會員充值入口:日常編寫與調試智能體代碼若需搭配高配額終端助手,可在本站免外幣卡開通 Claude Code 訂閱 或 ChatGPT Plus,更多開發者訂閱見 AI 會員充值中心。
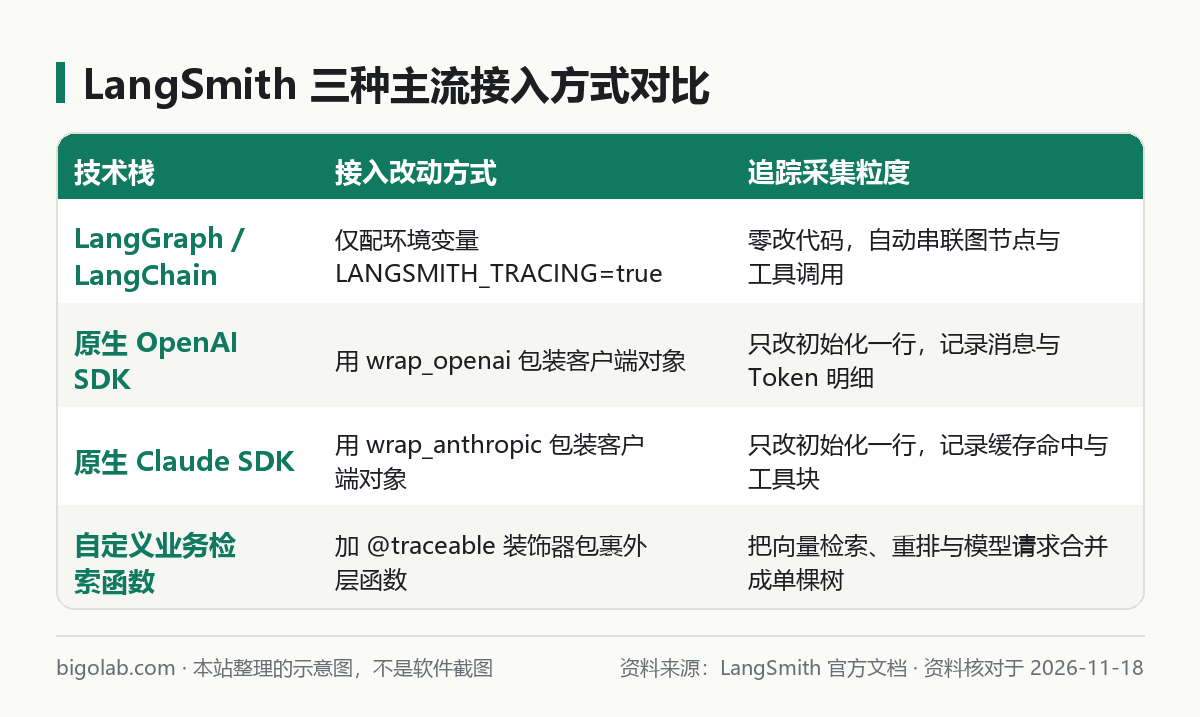
圖:本站根據 LangSmith 官方文檔:Trace with LangSmith 整理的示意圖
本文根據 LangSmith 官方文檔與 LangChain 官方定價頁整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 LangChain 官方網站。
適用於誰
- 用 LangGraph 或原生 OpenAI、Anthropic SDK 寫多步智能體,遇到工具死循環或回答跑偏卻沒法看中間拼接提示詞的開發者;
- 想在後台直觀看到每次問答的首字延遲(TTFT)、各子節點耗時佔比與緩存命中 Token 成本的團隊;
- 想弄清不用 LangChain 框架能不能單獨用 LangSmith,以及個人免費版夠不夠日常調試的人。
一、三步完成初始化:拿密鑰與配環境變量
如果你是第一次申請大模型接口密鑰,可先參考 大模型 API 從申請 Key 到首次調用入門。接入 LangSmith 只需三步準備:
- 生成 API Key:登入
https://smith.langchain.com(支持 GitHub 或 Google 帳號登入),點擊左下角齒輪圖標進入 Settings > API Keys > Create API Key,選擇 Personal Access Token 並複製儲存lsv2_pt_...開頭的密鑰。 - 安裝依賴包:在虛擬環境中執行
pip install -U langsmith openai anthropic。 - 寫入三項核心環境變量(新版官方統一使用
LANGSMITH_*前綴,同時向下兼容舊版LANGCHAIN_TRACING_V2):
bash
export LANGSMITH_TRACING="true"
export LANGSMITH_API_KEY="lsv2_pt_你的真實密鑰"
export LANGSMITH_PROJECT="rag-agent-dev"   # 不填預設歸入 default 項目
如果你的工程基於 LangGraph 或 LangChain 構建,配完上面三行環境變量直接運行原有腳本,打開網頁後台就能看到完整節點拓撲與狀態變更,一行 Python 代碼都不用動。
二、原生 OpenAI / Claude 接口怎麼加嵌套追蹤
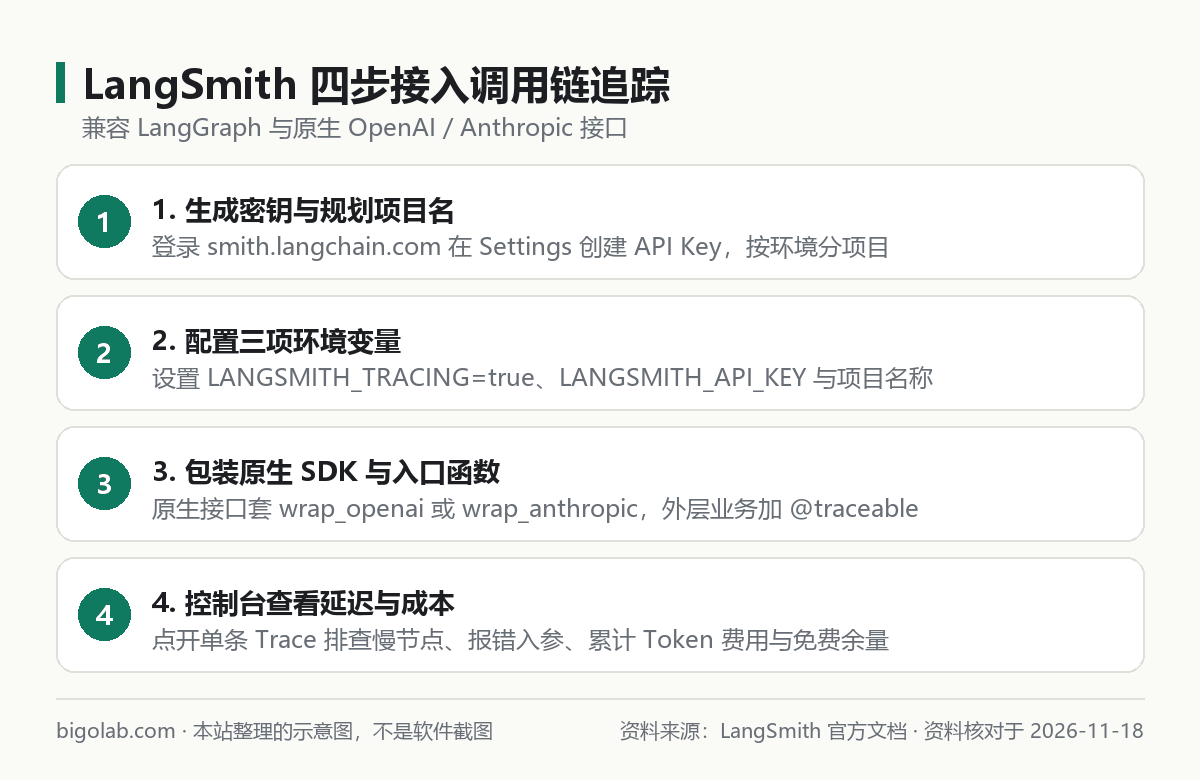
圖:本站根據 LangSmith 官方文檔 整理的示意圖
很多生產項目嫌重沒有引 LangChain,而是直接調官方 openai 或 anthropic SDK。此時把 客戶端包裝器(Wrappers) 與 @traceable 裝飾器 組合起來效果最好:外層函數加 @traceable 建立父根節點,內部多次向量檢索、重排和大模型請求就會自動收納在同一條 Trace 樹下,而不是散成幾條孤立記錄:
python
from openai import OpenAI
from anthropic import Anthropic
from langsmith import traceable
from langsmith.wrappers import wrap_openai, wrap_anthropic

# 包裝原生客戶端,後續所有調用自動記錄模型參數、耗時與 Token
oai_client = wrap_openai(OpenAI())
claude_client = wrap_anthropic(Anthropic())

@traceable(run_type="retriever", name="vector_search")
def retrieve_docs(query: str) -> list[str]:
    return ["退換貨規則:簽收 7 天內未拆封支持無理由退貨。"]

@traceable(name="customer_qa_pipeline", metadata={"env": "staging"})
def answer_question(user_query: str) -> str:
    docs = retrieve_docs(user_query)
    resp = claude_client.messages.create(
        model="claude-sonnet-4-5",
        max_tokens=512,
        messages=[{"role": "user", "content": f"依據:{docs}\n問題:{user_query}"}],
    )
    return resp.content[0].text

print(answer_question("拆封了還能退貨嗎?"))
運行後點開 rag-agent-dev 項目裏的這條記錄,左側會清晰展示父節點 customer_qa_pipeline 下掛着 vector_search(綠色檢索圖標)與 Messages(大模型圖標),右側能直接檢查提示詞緩存是否命中。關於兩家前綴緩存的觸發門檻,可對照 OpenAI API 提示詞緩存教學 與 Claude 提示詞緩存入門。
訂閱與帳號準備提示:開發階段除了用 API 跑追蹤流水線,日常寫業務邏輯與排查慢鏈路強烈建議交給高頻編程訂閱承擔,省去心疼按量 API 帳單;國內開發者可在本站免外幣卡開通 Claude Pro 或 ChatGPT Plus。
三、免費層(Developer)限額、數據脫敏與採樣控制
上線前務必了解官方計費與私隱控制邊界:
| 關注維度 | 官方規則說明(以定價頁當天為準) | 工程配置建議 |
|---|---|---|
| Developer 免費層限額 | 面向單人開發者免費開放,含每月固定免費基礎 Trace 配額(常見為 5,000 條/月),數據預設保留 14 天 | 本地開發與小流量驗證夠用;多人協作或需 400 天長留存再升級 Plus 檔 |
| 開啟追蹤對接口延遲的影響 | SDK 採用後台異步線程批量打包發送日誌,不阻塞主請求返回 | Serverless(如 AWS Lambda / Vercel)環境退出前需開 LANGSMITH_TRACING_BACKGROUND=false 或調 flush 防丟包 |
| 生產高並發採樣與脫敏 | 支持設 LANGSMITH_TRACING_SAMPLING_RATE=0.1(僅採 10% 流量),支持註冊匿名化函數遮蔽手機號密鑰 | 嚴禁在內網嚴監管金融醫療場景裸傳明文私隱字段;必須不出內網請改用自建開源方案 |
常見問題
問:配好了環境變量,為什麼網頁控制檯裏一條記錄都沒有?
答:按順序核查三處:第一,LANGSMITH_TRACING 字符串是否拼成了純小寫 "true";第二,若帳號建在歐盟區(eu.smith.langchain.com),必須額外配置 LANGSMITH_ENDPOINT="https://eu.api.smith.langchain.com";第三,短生命週期腳本剛跑完進程就退出導致後台隊列沒來得及發完,可在腳本末尾調用 langsmith.Client().flush() 驗證。
問:一條複雜的 LangGraph 對話跑了 8 個節點,算 1 條 Trace 還是 8 條?
答:按 LangSmith 官方計費口徑,一次完整頂層調用樹算作 1 條根 Trace(內部包含多個子 Run / Span),這也是為什麼要用 @traceable 把同一次用戶請求包在一個根節點下,既清晰又省免費配額。
問:公司要求所有提問日誌絕不能發往外部 SaaS 雲端怎麼辦?
答:LangSmith 自託管版僅面向 Enterprise 企業商業合同開放;中小團隊若要求零授權費在自己伺服器用 Docker 私有化部署可觀測平台,直接選用 MIT/開源自託管方案(如 Langfuse)更合適。
問:人在國內沒有境外信用卡,怎麼開通 Claude 或 ChatGPT 會員輔助寫代碼?
答:可在本站 AI 會員充值中心 自助選購 Claude Pro 免上號卡密 或 ChatGPT Plus 充值服務(無需交出帳號密碼),支持支付寶、微信支付與 AlipayHK 付款並可開具增值稅發票;實時價格與售後邊界(掉訂閱按剩餘天數折退,封號不在質保範圍)以商品頁展示為準。
相關教學
- 大模型 API 怎麼用:從申請 Key 到第一次調用,OpenAI、Claude、Gemini 通用入門
- AI 大模型 API 價格對比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方價格頁速查
- OpenAI API 提示詞緩存(Prompt Caching)怎麼用:1024 token 門檻與命中排查
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
參考資料
- LangSmith 官方文檔:Trace with LangSmith — https://docs.smith.langchain.com/observability/how_to_guides/trace_with_langsmith
- LangSmith 官方文檔首頁 — https://docs.smith.langchain.com/
- LangChain & LangSmith 官方定價頁 — https://www.langchain.com/pricing
0 條評論
還沒有評論,來搶沙發~