
結論先說
- 預設自動開啟,無需手動打斷點:在支持的模型上,OpenAI 會自動對請求開頭的相同前綴做精確匹配緩存,命中緩存本身不收額外的寫入費。
- 硬門檻是共同前綴滿 1024 token:短於 1024 token 的提示詞不會觸發緩存;達到 1024 token 後,按 128 token 為步長遞增計算命中長度。
- 省錢且降延遲:官方數據顯示緩存命中最高可降低 80% 首字延遲(TTFT),緩存輸入單價相比普通輸入最高可省 90%–95%(視具體型號而定)。
- 用
prompt_cache_key提升路由命中率:傳入穩定的會話或業務標識字符串,可幫助網關把共享相同前綴的請求路由到同一批緩存實例。 - 排查只看
cached_tokens:Responses API 看usage.input_tokens_details.cached_tokens,為0時優先查長度是否夠 1024、開頭是否混入了時間戳等動態文本。 - 國內免境外卡開通入口:若沒有境外銀行卡或遇到支付被拒,可在本站通過支付寶、微信支付或 AlipayHK 自助獲取兌換碼開通 ChatGPT Plus 或 ChatGPT Pro,團隊多席位支持聯絡客服定製 ChatGPT Business 團隊版。
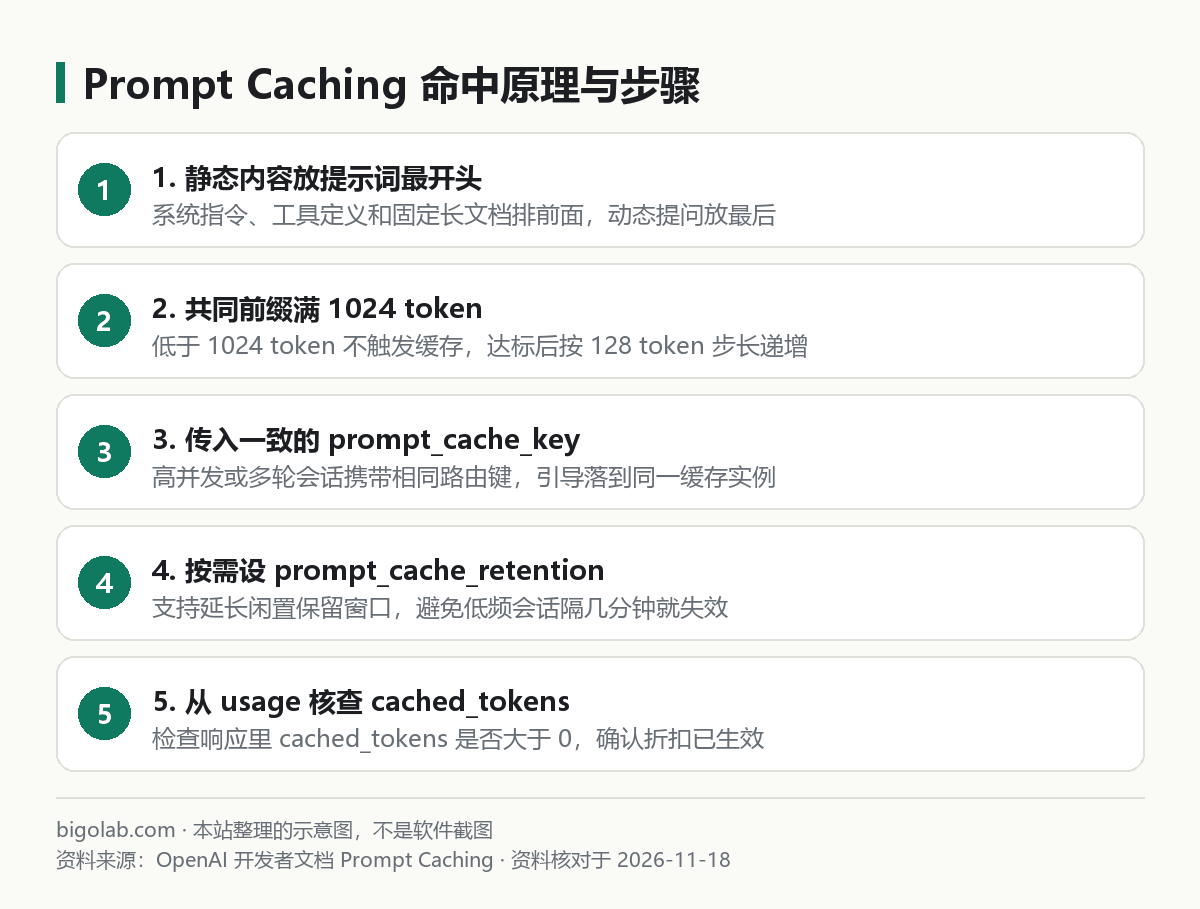
圖:本站根據 OpenAI 開發者文檔:Prompt Caching 整理的示意圖
本文根據 OpenAI 開發者文檔《Prompt Caching》《Counting tokens》與官方 API 價格頁整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 每次調用 OpenAI API 都要塞入長系統指令、固定業務文檔或幾十個工具定義,希望大幅壓低輸入成本與首字延遲的開發者;
- 發現響應
usage裏的cached_tokens一直顯示為0,想知道卡在哪條規則上的人; - 想搞清 OpenAI 自動緩存與
prompt_cache_key、prompt_cache_retention參數怎麼配合的人。
一、工作原理、1024 token 門檻與省費比例
OpenAI 的提示詞緩存採用嚴格前綴匹配(Exact prefix matching):系統從整個請求的最開頭第 1 個 token 往後比對,包括頂層 instructions(或系統消息)、tools 工具列表、歷史消息以及圖片等輸入。只要開頭有一段連續完全一致的內容且達到 1024 token,後續請求複用這段前綴時就直接跳過預填充計算。
遞增規則很直觀:滿 1024 token 先緩存 1024,之後每多出整 128 token(1152、1280、1408……)再往上擴一格,不足一個步長的尾部按普通輸入計費。發請求前不確定前綴夠不夠 1024,可調用官方計數接口精確測算,方法見 /guides/openai-api-token-count-estimate。
在計費上,OpenAI 不收緩存創建或存儲附加費(這與 Anthropic 顯式緩存收寫入倍率不同,對比見 /guides/claude-prompt-caching)。按官方 API 價格表,主力模型的緩存摺扣非常可觀:例如 gpt-6-astra 標準輸入每百萬 token 為 $10.00、緩存輸入僅 $1.00(打 1 折);gpt-6.1-sol 標準輸入 $2.00、緩存輸入 $0.10(省 95%)。完整型號單價表見 /guides/openai-api-price-official-table。注意 API 帳單與個人網頁會員分開結算,日常網頁問答或用 Codex 訂 ChatGPT Plus 即可,兩者區別見 /guides/chatgpt-subscription-vs-openai-api。
二、代碼怎麼寫:固定前綴、prompt_cache_key 與保留策略
想拿到穩定的高命中率,寫請求時遵循「靜態全放前、動態全放後」即可,並配合 prompt_cache_key 做實例路由:
python
from openai import OpenAI

client = OpenAI()

# 靜態長背景與規則(確保連同 tools 一起超過 1024 tokens)
LONG_SYSTEM_SPEC = "你是企業財務合規審核助手……(此處省略超過 1024 tokens 的固定制度全文)"

response = client.responses.create(
    model="gpt-6.1-sol",  # 以官方價格頁與模型頁當前可用型號為準
    instructions=LONG_SYSTEM_SPEC,
    prompt_cache_key="finance-audit-v1",  # 相同前綴業務傳一致的 key 提高路由命中率
    input=[
        {"role": "user", "content": "請核查這份報銷單摘要是否符合差旅標準:……"}
    ],
)

print("總輸入 token:", response.usage.input_tokens)
print("命中緩存 token:", response.usage.input_tokens_details.cached_tokens)
兩個實用控制參數:
prompt_cache_key:當你的應用並發很高時,請求可能被分發到多台不同後端機器導致緩存分散。給共用同一套系統指令或同一用戶線程的請求傳相同的prompt_cache_key(注意單個 key 每分鐘請求量不要極端集中過載,可按租戶或業務線分桶),能顯著提高命中率。- 保留時間與
prompt_cache_retention:預設內存緩存通常在閒置 5–10 分鐘後自動淘汰(低峰期偶有延長)。在支持擴展緩存保留的模型與接口上,可配置prompt_cache_retention(例如內存級"in_memory"或長保留窗口"24h",具體枚舉取值以所用模型的最新 API 參考為準),適合間隔幾十分鐘才繼續說話的異步智能體。Responses API 基礎結構見 /guides/openai-responses-api。
本站訂閱與團隊開通提示:如果你在國內遇到銀行卡被拒或急需提升對話與推理配額,可前往本站 ChatGPT Plus 充值說明頁 或 ChatGPT Pro 5x/20x 充值頁 自助獲取卡密完成開通(全程無需交出帳號密碼,可開增值稅發票);企業多成員協作可直接查看 ChatGPT Business 團隊定製方案。
三、怎麼看有沒有命中、為什麼 cached_tokens 總是 0
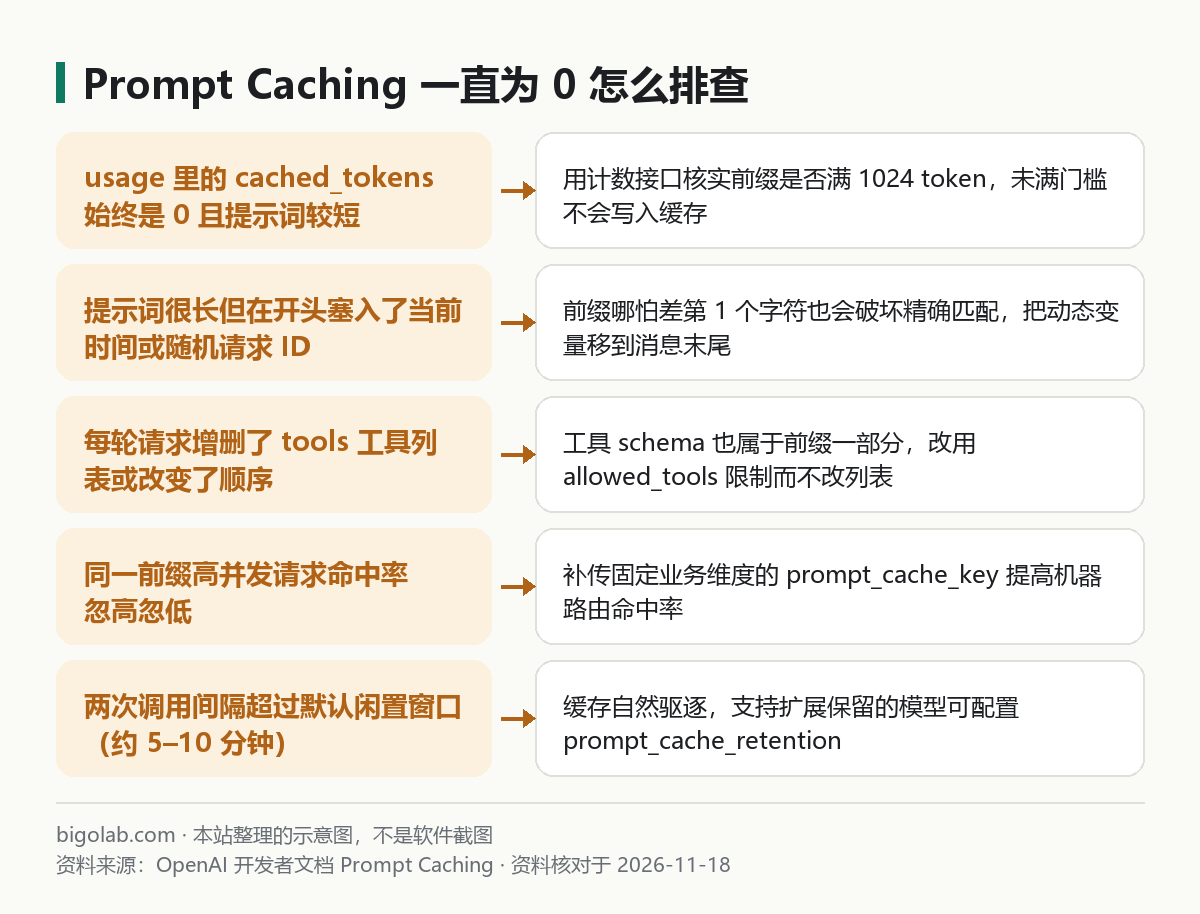
圖:本站根據 OpenAI 開發者文檔:Prompt Caching 整理的示意圖
每次調用返回後,直接檢查響應裏的 usage 對象:
- Responses API:讀
response.usage.input_tokens_details.cached_tokens; - Chat Completions API:讀
completion.usage.prompt_tokens_details.cached_tokens。
如果連續發兩次請求,cached_tokens 依然是 0,按下面五點逐一核對:
- 前綴不到 1024 token:中英文分詞密度不同,幾百漢字往往只有幾百 token,先湊夠 1024 門檻。
- 開頭混入了動態變量:最常見的坑是在系統提示詞第一行寫了
當前時間:2026-11-18 19:30:05或隨機用戶請求 ID。第 10 個 token 一變,後面 1 萬個 token 全軍覆沒。務必把動態時間、檢索出的實時片段放到最後一條用戶消息裏。 tools列表順序或增刪變動:工具定義位於上下文前部。如果想在某輪禁用部分函數,不要直接刪改tools數組,改用tool_choice裏的allowed_tools限定可用範圍,用法見 /guides/openai-api-function-calling。- 第一次請求剛發完就並發發第二次:緩存需要在首筆請求完成前綴處理後才能寫入就緒,緊挨着毫秒級同時發出的請求來不及複用。
- 閒置超時被逐出:兩次請求相隔十幾分鍾以上,內存緩存已被回收,重新熱身一次即可恢復。
常見問題
問:開啟了零數據保留(ZDR)或 store: false,還能用提示詞緩存嗎?
答:預設內存級提示詞緩存不把用戶內容持久化落盤,通常仍可在請求間短暫命中;但依賴持久存儲的跨長週期特性請以組織合規協議與官方文檔說明為準。
問:緩存命中的 token 還會佔用模型的上下文窗口上限和 TPM 速率限制嗎?
答:上下文窗口總長度依然按完整輸入 token 數計算;至於每分鐘 token 速率限制(TPM)各層級如何折算緩存部分,可在控制檯 Limits 頁查看當前模型說明。
問:圖片、音頻和結構化輸出 Schema 能被緩存嗎?
答:可以。只要圖片條目(相同的圖片內容與 detail 檔位)或 text.format 的 JSON Schema 位於不變的共同前綴內,且總前綴滿 1024 token,同樣計入緩存。
問:國內沒有境外信用卡,怎麼開通或續費 ChatGPT Plus / Pro?
答:可在本站使用支付寶、微信支付或 AlipayHK 下單獲取卡密自助兌換(支持 ChatGPT Plus、Pro 5x 可覆蓋檔 與 Pro 5x 空白號檔),實時價格、兌換前提與售後規則(掉訂閱按剩餘天數折退,封號不在質保範圍)以對應頁面說明為準。
相關教學
- OpenAI API 價格是多少:輸入、緩存輸入與輸出價格表
- OpenAI API 的 token 怎麼算、怎麼估算費用
- OpenAI Responses API 是什麼:和 Chat Completions 的區別
- Claude 提示詞緩存(Prompt Caching)入門
參考資料
- OpenAI 開發者文檔:Prompt Caching — https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI API 價格頁 — https://developers.openai.com/api/docs/pricing
- OpenAI 開發者文檔:Counting tokens — https://developers.openai.com/api/docs/guides/token-counting
0 條評論
還沒有評論,來搶沙發~