
本文根據 Claude 開發者平台官方文檔《Citations》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 做文檔問答、合同 / 報告核對、知識庫問答,需要讓用戶看到「這句話出自哪裏」的開發者;
- 不想自己用字符串匹配去反查依據的人。
基礎調用見 /guides/claude-api-python-quickstart。聯網搜尋自帶的引用是另一套機制,見 /guides/claude-api-web-search-tool;本文講的是基於你自己提供的文檔的引用。
結論先說
- 官方定義: 引用讓 Claude 在回答關於文檔的問題時,給出支持每個論斷的原文段落,方便核對來源。官方寫明所有活躍模型都支持。
- 打開方式: 在每個
document塊裏加"citations": {"enabled": true}。官方限制:一次請求裏要麼所有文檔都開,要麼都不開。 - 三種文檔: 純文本(按句分塊,引用是字符位置)、PDF(按句分塊,引用是頁碼)、自定義內容(不再分塊,引用是內容塊編號)。
- 目前只支持文本引用,不支持圖片引用。 所以掃描件 PDF(沒有可提取文字)無法被引用。
- 與結構化輸出衝突: 開了引用又帶
output_config.format(或已棄用的output_format),API 返回 400。
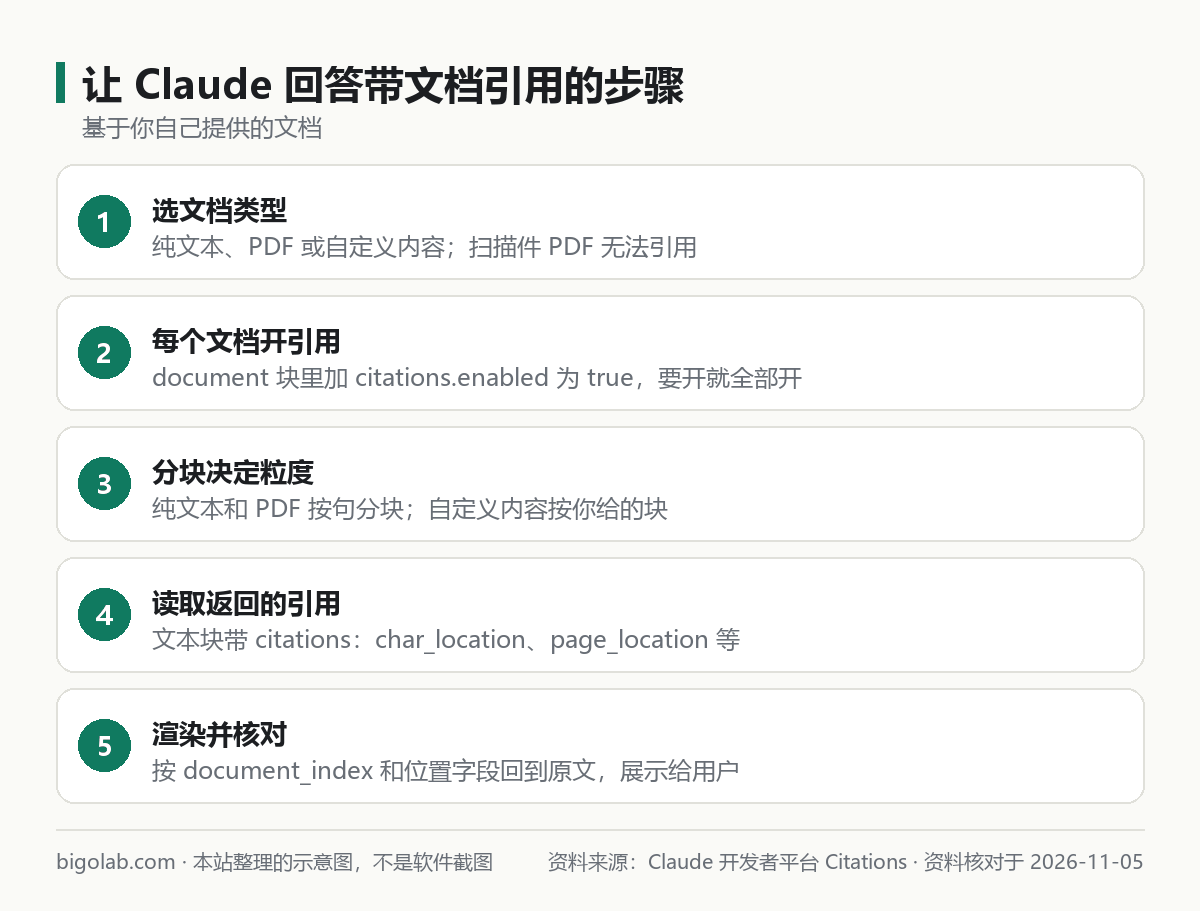
圖:本站根據 Claude 官方文檔:Citations 整理的示意圖
一、最小請求
官方示例是一個純文本文檔。下面是把它轉寫成 Python 的版本(模型 ID 沿用官方示例中的 claude-opus-5-5):
python
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "document",
                    "source": {
                        "type": "text",
                        "media_type": "text/plain",
                        "data": "The grass is green. The sky is blue.",
                    },
                    "title": "My Document",
                    "context": "This is a trustworthy document.",
                    "citations": {"enabled": True},
                },
                {"type": "text", "text": "What color is the grass and sky?"},
            ],
        }
    ],
)
print(response)
字段說明(官方):
source裏的文字是可以被引用的內容;title和context是可選字段,會傳給模型,但不會被當作引用來源;title長度有限制,要放文檔元數據(比如編號、來源)可以用context,寫成文本或序列化後的 JSON。
二、官方說的處理過程
- 你提供文檔並設定
citations.enabled; - 文檔內容被「分塊」,分塊決定了引用的最小粒度。比如按句分塊,Claude 可以引用單句,也可以把連續幾句串起來引用一整段;
- Claude 返回帶引用的回答:回答可能由多個文本塊組成,每個文本塊可以帶一個支持該論斷的引用列表。
引用的位置格式取決於文檔類型:
| 文檔類型 | 適合 | 分塊 | 引用格式 |
|---|---|---|---|
| 純文本 | 普通文字、散文 | 按句 | 字符位置(從 0 開始,結束位置不含) |
| 帶文字的 PDF | 按句 | 頁碼(從 1 開始,結束頁不含) | |
| 自定義內容 | 列表、逐字稿、特殊格式、更細粒度 | 不再分塊 | 內容塊編號(從 0 開始,結束編號不含) |
文檔編號(document_index)從 0 開始,按整個請求中所有文檔塊的順序算(跨所有消息)。
官方的建議:想讓 Claude 引用 RAG 檢索片段裏的具體句子,就把每個片段放進一個純文本文檔;如果不想再被分塊,或想自己定義粒度,就把片段放進自定義內容文檔。
三、返回裏的字段
啟用後,響應的 content 是一串文本塊,帶引用的塊長這樣(官方示例,省略部分字段):
json
{
  "type": "text",
  "text": "the grass is green",
  "citations": [
    {
      "type": "char_location",
      "cited_text": "The grass is green. ",
      "document_index": 0,
      "document_title": "Example Document",
      "start_char_index": 0,
      "end_char_index": 20
    }
  ]
}
三種引用類型:
- 純文本:
char_location,字段start_char_index、end_char_index; - PDF:
page_location,字段start_page_number、end_page_number; - 自定義內容:
content_block_location,字段start_block_index、end_block_index。
它們都帶 cited_text、document_index、document_title。
怎麼用在頁面上: 按順序遍歷文本塊,把有 citations 的塊渲染成可點擊的角標,點擊時用 document_index 找到文檔、用位置字段高亮原文。官方示例裏的 cited_text 是為方便而提供的。
四、自定義內容文檔
想控制引用粒度,用 source.type: "content",把每一塊自己切好放進去(官方示例的結構):
json
{
  "type": "document",
  "source": {
    "type": "content",
    "content": [
      {"type": "text", "text": "First chunk"},
      {"type": "text", "text": "Second chunk"}
    ]
  },
  "title": "Document Title",
  "citations": {"enabled": true}
}
官方說明:不做額外分塊,提供的塊原樣交給模型;引用的是塊編號範圍。
PDF 可以用 base64、URL 或 file_id 提供;官方說明掃描件沒有可提取文本時不可引用。官方還指出 .docx、.xlsx 等 document 塊不支持的格式,要先轉成純文本再放進消息;.csv、.md 這類純文本文件可以用明確的 text/plain 類型上載。文件上載見官方 Files API 頁面。
五、費用、緩存、流式
- Token: 官方說啟用引用會讓輸入 token 略有增加(系統提示詞增加和文檔分塊導致),但對輸出 token 很高效;
cited_text不計入輸出 token,在後續對話輪中回傳時也不計入輸入 token。 - 提示詞緩存: 可以配合使用。官方說回覆裏生成的引用塊不能直接被緩存,但它們引用的源文檔可以;做法是在頂層的文檔內容塊上加
cache_control。緩存基礎見 /guides/claude-prompt-caching。 - 其他兼容: 官方說引用可以與提示詞緩存、token 計數、批量處理配合。
- 流式: 引用以
content_block_delta事件裏的citations_delta類型到達,每個增量帶一條引用,要追加到當前文本塊的citations列表裏。
六、想要結構化數據又要引用怎麼辦
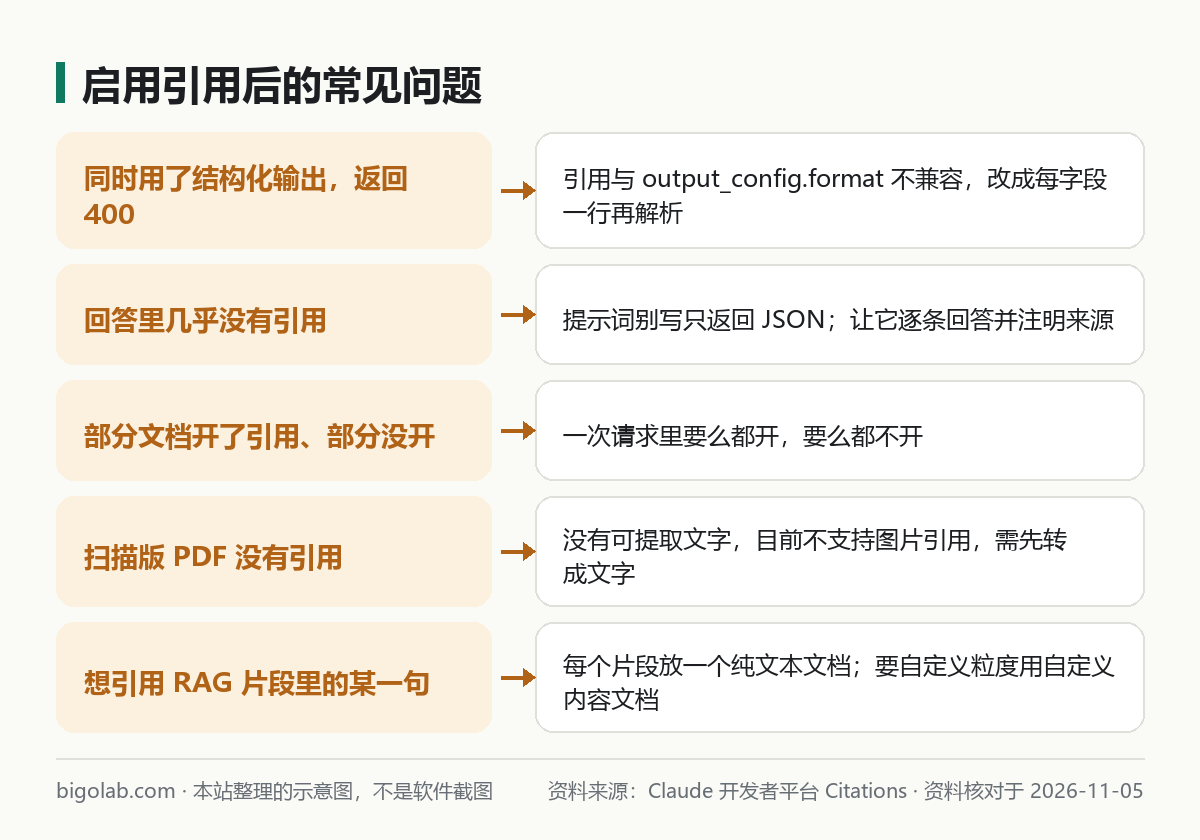
圖:本站根據官方文檔整理的示意圖
官方明確:引用和結構化輸出不兼容,因為引用需要在文本輸出裏穿插引用塊,而結構化輸出要求嚴格的 JSON 模式。同時用會返回 400。
官方給的替代辦法:讓 Claude 每個字段一行回答,例如 field: value,並要求每行都引用文檔;然後在你的代碼裏把行解析成結構化數據。官方提示詞示例:
text
Extract these fields from the document: grass_color, sky_color.
Answer with one line per field in the form "field: value", and cite the document for each line. After the colon, write only the value, with no explanation or quotation.
官方還提醒兩點:
- 避免只要 JSON 的提示詞,例如「只返回一個 JSON 對象,不要其他文字」。這樣的請求能成功,但回答裏可能很少甚至沒有引用;
- 解析後要檢查:每個字段要有值且至少有一條引用,API 不保證這兩點。
常見問題
Q:有些文檔開了引用、有些沒開可以嗎?
不可以。官方寫的是「目前引用必須在一次請求的所有文檔上都啟用或都不啟用」。
Q:圖片能引用嗎?
不能,官方說目前不支持圖片引用,PDF 裏的圖片同理。
Q:和聯網搜尋的引用有什麼區別?
聯網搜尋的引用總是開啟,字段是 web_search_result_location;文檔引用需要你在每個文檔塊裏顯式打開。
Q:我碰到 429 或 400 怎麼處理?
429 見 /guides/claude-api-error-429-rate-limit;400 先對照本文第六節檢查是不是引用和結構化輸出同時開了。
相關教學
- /guides/claude-api-python-quickstart:Python 快速上手
- /guides/claude-prompt-caching:提示詞緩存
- /guides/claude-api-web-search-tool:聯網搜尋工具
參考資料
- Claude 開發者平台文檔:Citations — https://platform.claude.com/docs/en/build-with-claude/citations
0 條評論
還沒有評論,來搶沙發~