
本文根據 Claude 官方《PDF support》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 Anthropic 官方網站。API 是按用量計費的獨立服務,與 Claude 訂閱分開計算,Key 的獲取見 /guides/claude-api-key-console。
適用於誰
- 想讓 Claude 總結合同、論文、財報、說明書,或者從 PDF 裏抽取字段的開發者;
- 網頁版能拖文件,卻不知道 API 裏怎麼傳的人(網頁端文件限制見 /guides/claude-file-upload-limits);
- 想估算一份 PDF 要花多少 token 的人。
結論先說
- PDF 用
document內容塊傳,和text塊一起放在用戶消息的content裏。 - 三種來源:
url(公開網址)、base64(把文件編碼進請求,media_type寫application/pdf)、file(先傳到 Files API,再用file_id引用)。 - 限制:第一方 Claude API 請求總大小 128 MB;每個請求最多 600 頁,上下文窗口小於 1M token 的請求最多 100 頁;PDF 不能有密碼或加密。
- Claude 同時看文字和圖像:每頁會轉成圖像,再配上提取出的文字,所以能讀懂圖表、示意圖。
- 官方給的估算:每頁文字大約 1500 到 3000 token,另加圖像的 token;沒有額外的 PDF 附加費。
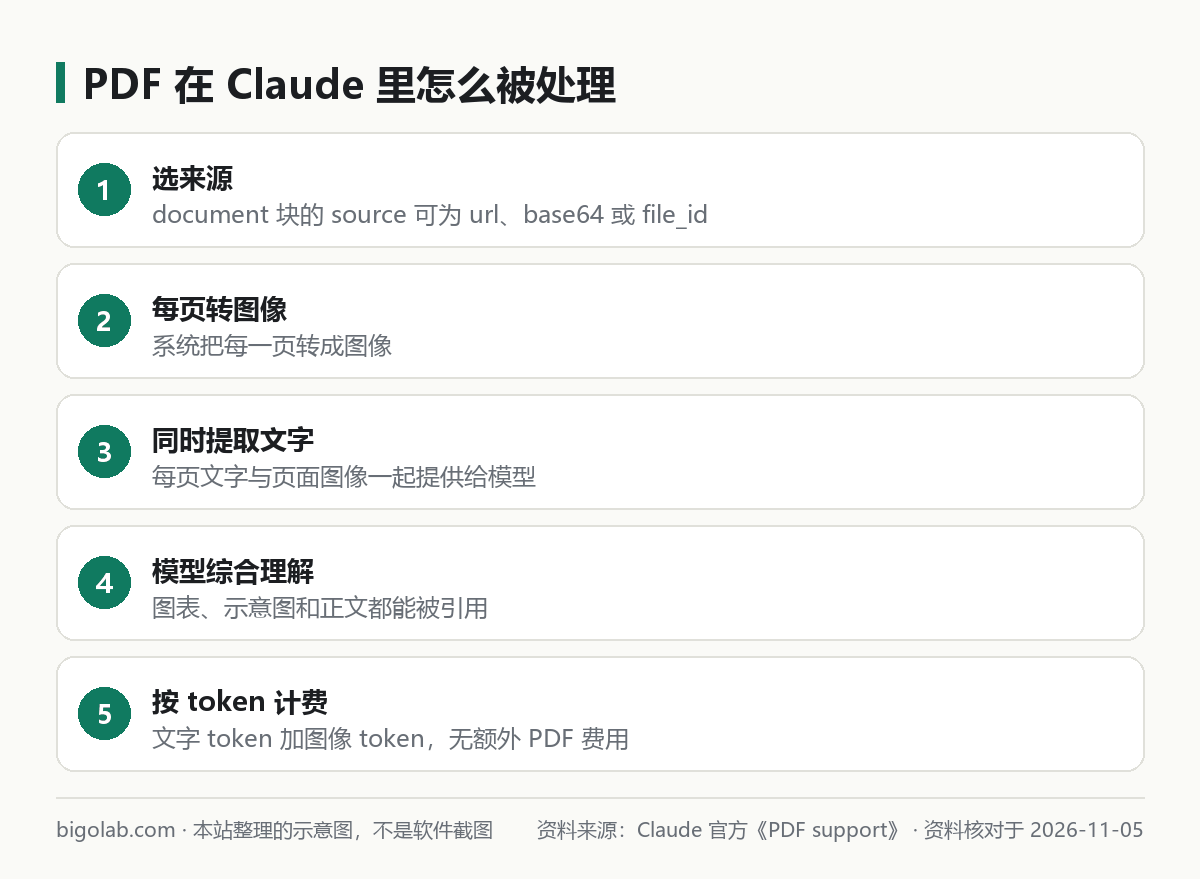
圖:本站根據 Claude 官方《PDF support》 整理的示意圖
一、方式一:url
PDF 已經在公開網址上時,最省事:
python
import anthropic

client = anthropic.Anthropic()

message = client.messages.create(
    model="claude-opus-5-5",  # 以官方模型頁當天為準
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "document",
                    "source": {"type": "url", "url": "https://example.com/report.pdf"},
                },
                {"type": "text", "text": "這份文件的主要結論是什麼?"},
            ],
        }
    ],
)
print(message.content[0].text)
網址必須是伺服器能訪問到的公開地址。
二、方式二:base64
文件在本地時,讀取後編碼:
python
import base64

with open("report.pdf", "rb") as f:
    pdf_base64 = base64.standard_b64encode(f.read()).decode("utf-8")

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "document",
                    "source": {
                        "type": "base64",
                        "media_type": "application/pdf",
                        "data": pdf_base64,
                    },
                },
                {"type": "text", "text": "請列出文件中所有的日期和金額。"},
            ],
        }
    ],
)
TypeScript 裏讀文件的寫法是 await readFile("report.pdf", { encoding: "base64" })(來自 node:fs/promises),請求結構完全一樣。注意 base64 會讓請求體變大,要留意前面說的 128 MB 總量。
三、方式三:先上載,再引用 file_id
同一份 PDF 要問很多次,或者文件很大時,官方建議用 Files API 先上載,之後只引用編號:
python
uploaded = client.files.upload(
    file=("report.pdf", open("report.pdf", "rb"), "application/pdf"),
)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "document", "source": {"type": "file", "file_id": uploaded.id}},
                {"type": "text", "text": "請總結這份文件。"},
            ],
        }
    ],
)
上載、刪除、過期等管理方法見 /guides/claude-api-files-api。
四、它到底“看”到了什麼
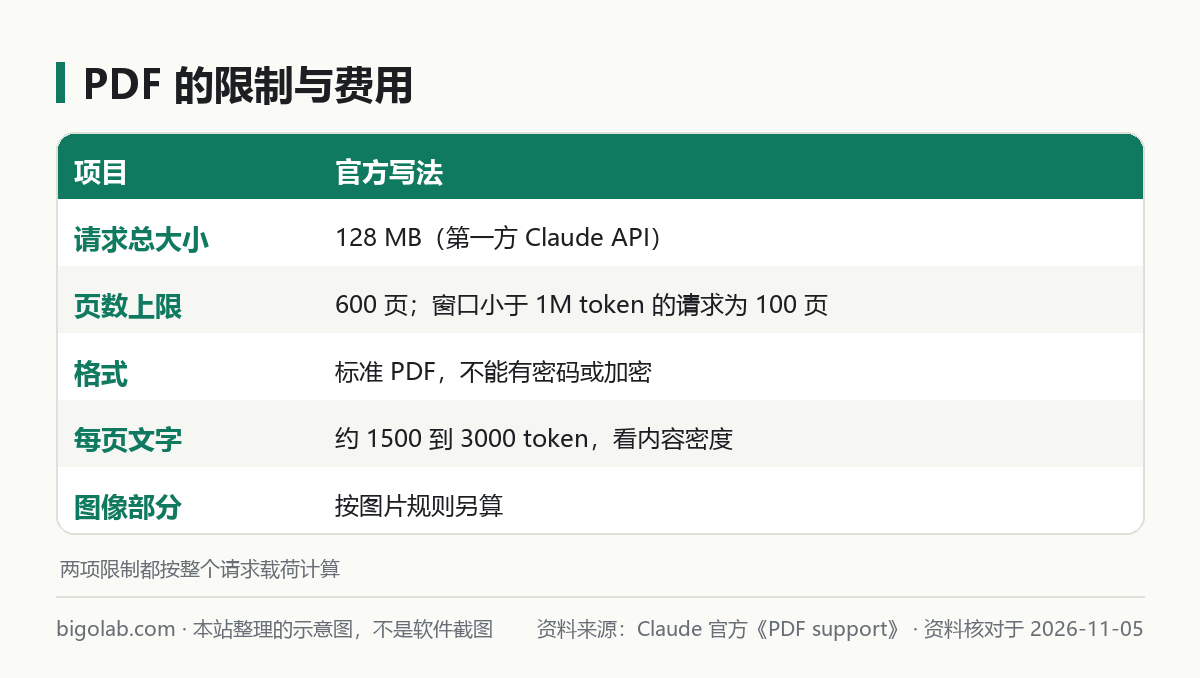
圖:本站根據 Claude 官方《PDF support》 整理的示意圖
官方描述的處理過程有三步:
- 系統把 PDF 的每一頁轉成一張圖像,同時提取每頁的文字;
- 文字和圖像一起交給 Claude,所以圖表、示意圖、版面也能被理解;
- Claude 回答時可以引用文字內容,也可以引用視覺內容。
這帶來兩個直接後果:
- 費用是兩部分之和:文字 token(官方估算每頁約 1500 到 3000,看內容密度)加上圖像 token(按圖片規則計算,見 /guides/claude-api-image-input)。官方強調標準 API 價格適用,沒有額外的 PDF 費用;
- 文字多、圖表多的 PDF 會很快佔滿上下文窗口,可能還沒到頁數上限就失敗。官方的建議是把大文件拆成幾段;每頁都按圖像處理,所以降低內嵌圖片的解像度也有幫助。
想事先知道一份 PDF 會用多少 token,可以用 token 計數接口,但它對 PDF 只接受 base64 來源,不接受 url 或 file,詳見 /guides/claude-api-count-tokens。
五、官方的幾條性能建議
- 把 PDF 放在文字提問之前;
- 使用標準字體,文字要清晰可讀;
- 頁面方向要擺正,掃描件先把頁面旋轉好;
- 在提示詞裏用 PDF 閱讀器裏顯示的“邏輯頁碼”來指頁,不要用印在頁面上的頁碼;
- 大文件分塊處理;
- 重複分析同一份文件時開啟提示詞緩存。
六、規模化:緩存與批量
- 提示詞緩存:對同一份 PDF 多次提問,可以給
document塊加緩存標記,之後的請求讀緩存,節省輸入成本和延遲。緩存的完整寫法見 /guides/claude-prompt-caching; - 批量處理:幾百份 PDF 要一起處理又不趕時間,可以用 Message Batches,官方文檔裏有現成的 PDF 批量示例,批量接口的用法見 /guides/claude-api-message-batches。
七、不是 PDF 的文件怎麼辦
document 塊不接受 xlsx、docx 這類二進制格式。官方的建議:
- txt、csv、md 這類純文本,可以直接讀出文字放進
text塊,或用text/plain上載到 Files API 後引用; - docx、xlsx 先轉成文字,或者轉成 PDF;官方特別提醒,含圖片的 docx 先轉 PDF,才能用上 PDF 的圖像解析和引用功能。
八、一個實用的小流程
把上面的內容串起來,處理一份新 PDF 時可以這樣走:
- 先看文件大小和頁數,超過限制就先拆分;
- 只問一次的小文件用
url或base64,要反覆提問的大文件先傳到 Files API; - 請求裏把
document塊放在text塊之前,問題裏用邏輯頁碼指明範圍,例如“只看第 3 到 5 頁”; - 先在少量樣本上試,用返回的
usage字段核對實際 token 用量,再決定要不要批量跑; - 同一份文件的後續提問加上緩存標記,省下重複讀取的成本。
這些都是把官方各條建議串起來的做法,不是官方規定的固定流程,你可以按自己的文件情況調整。
常見問題
Q:為什麼提示請求太大或頁數超限?
對照上面的限制:128 MB、600 頁(窗口小於 1M token 的請求是 100 頁)。拆分文件,或改用 Files API 減小請求體。整體排查見 /guides/claude-api-error-codes。
Q:加密或設了密碼的 PDF 能讀嗎?
官方要求是標準 PDF,不能有密碼或加密。
Q:能讓回答附上出處嗎?
document 塊有可選的 citations 字段,啟用後可以獲得引用,細節官方有專門頁面,本文不展開。
Q:費用怎麼算?
文字和圖像都按輸入 token 計,價格以官方價格頁當天為準。
參考資料
- Claude 官方:PDF support — https://platform.claude.com/docs/en/build-with-claude/pdf-support
- Claude 官方:Files API — https://platform.claude.com/docs/en/build-with-claude/files
- Claude 官方:Token counting — https://platform.claude.com/docs/en/build-with-claude/token-counting
0 條評論
還沒有評論,來搶沙發~