
結論先說
- 官方沒有「暗中降智」的說法,最常見的原因是推理強度落在低檔。 官方文檔寫明:在支持的個人套餐上,新建會話預設以
GPT-6.2 Sol的 Light(輕度)檔起步,複雜任務不手動調高就會想得淺。 - 命令行裏先跑
/status看底牌。 它會直接列出當前生效的模型、審批策略、可寫目錄和剩餘上下文容量,不用猜。 - 長對話會被自動壓縮,工具超長輸出也會被截斷。 同一個會話拖得太長,早期細節會被摘要替代;做完一件事用
/new開新會話最穩。 - 項目規則沒生效,先查
AGENTS.md有沒有超過 32 KiB 或項目未被信任。 超出上限的文件和未信任倉庫的.codex/配置都會被跳過。 - 模型換代後檔位不完全等價。 官方明確提醒不同代模型之間的推理檔位不能機械對號,升級模型後要重新調檔。普通網頁版 ChatGPT 的同類排查見 ChatGPT 為什麼感覺變笨了。
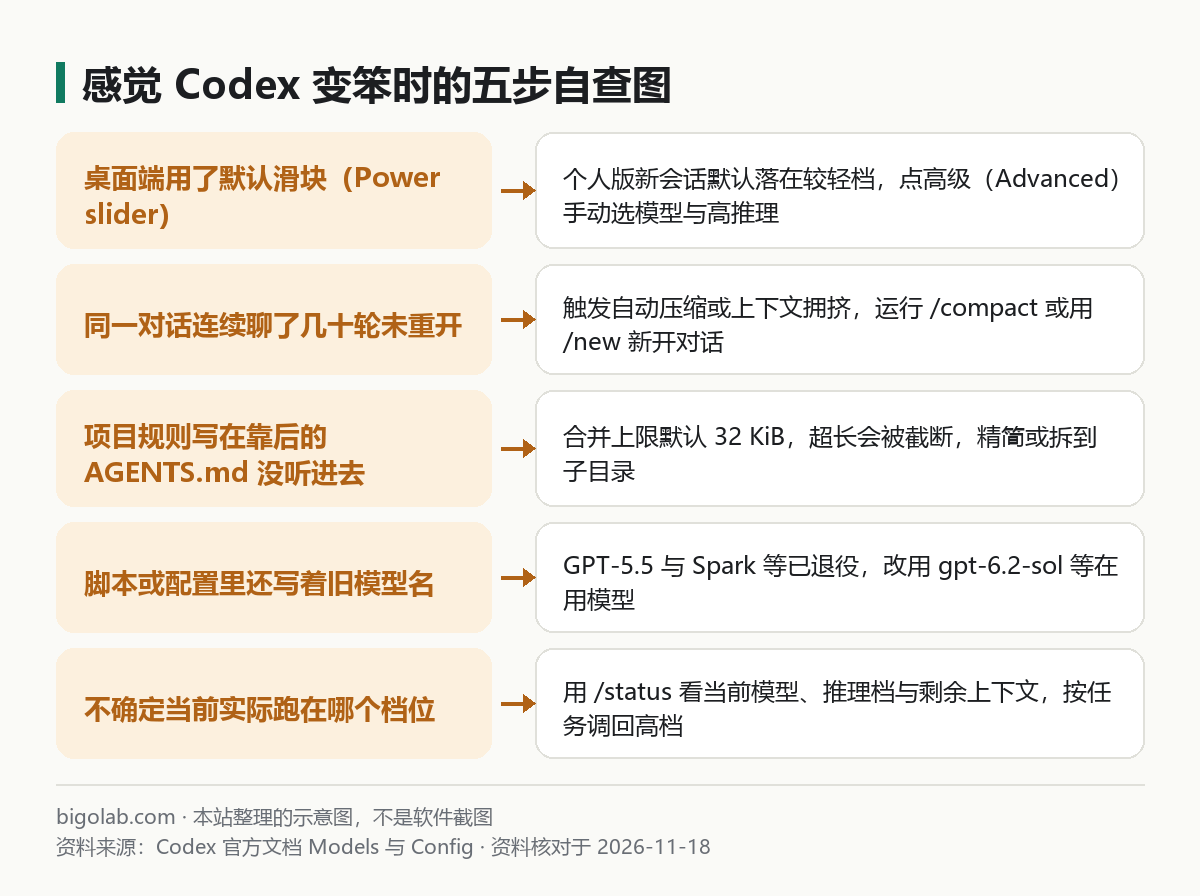
圖:本站根據 Codex 官方文檔:Models 與示例配置整理的示意圖
本文根據 Codex 官方文檔《Models》《Sample Configuration》《Slash commands in Codex CLI》和《Custom instructions with AGENTS.md》整理,資料核對於 2026-11-18。OpenAI 官方文檔沒有「降智」這一說法,本文把官方文檔中會直接改變推理深度和可見上下文的設定逐項列出,供你對照自查。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 搜「codex模型降智」,感覺最近 Codex 寫代碼愛漏邊界條件、不按指令改文件的人;
- 同一個項目剛開始挺聰明,聊了幾十輪之後突然開始胡改或忘掉前文約束的人;
- 想搞清楚哪些配置項在限制 Codex 思考深度和上下文容量的人。
一、先查當前模型與推理強度:是不是跑在 Light / Low 檔
很多用戶感覺「變笨」,是因為用了預設檔位去啃跨文件重構。官方文檔在《Models》裏寫得很明確:
- 桌面端與網頁版功率滑塊(Power slider):在支持的個人套餐上,新開會話預設使用
GPT-6.2 Sol的 Light 檔(企業工作區預設 Medium)。滑塊往 Faster 推是求快省額度,往 Smarter 推才是加深推理;點開 高級(Advanced) 才能精確指定GPT-6.2 Astra以及 High、Extra High、Max 或 Ultra。 - 命令行 CLI:輸入
/model查看或切換;想在底部狀態欄隨時盯住當前模型與推理檔位,輸入/statusline,把model+reasoning和context stats勾上,避免跑在低檔還不自知。 - 計劃模式單獨設高檔:官方示例配置提供了
plan_mode_reasoning_effort = "high",可以讓日常編碼保持medium,切到/plan規劃方案時自動用high深想一層。
官方同時說明,不同代模型之間推理檔位並不一一對應,換代後要拿熟悉的任務重新對比。具體切換步驟見 Codex 怎麼切換模型和思考強度。
二、再查上下文:長對話自動壓縮與工具輸出上限
即使模型和推理檔位拉滿,塞進對話的材料變殘缺了,回答質素一樣會掉下來。官方配置參考揭示了三處截斷與壓縮機制:
- 長對話自動壓縮:當上下文接近
model_auto_compact_token_limit(未設定時按模型預設值)或觸發回合末壓縮閾值model_post_turn_compact_threshold_percent時,Codex 會把較早的輪次替換成簡短摘要以騰出空間。摘要能留主幹,但早先提過的細枝末節可能丟失。 - 單次工具輸出上限:
tool_output_token_limit限制每次命令返回結果保留多少 token(官方示例裏為12000)。一次打印幾萬行日誌時,超出部分不會完整保留。 - 手動整理比硬撐好:剩餘上下文不多時,主動執行
/compact做一次乾淨總結;換了另一個子需求就直接輸/new開新對話。覺得慢或頻繁重連時的排查見 Codex 為什麼總是先重連幾次才回答、為什麼這麼慢。
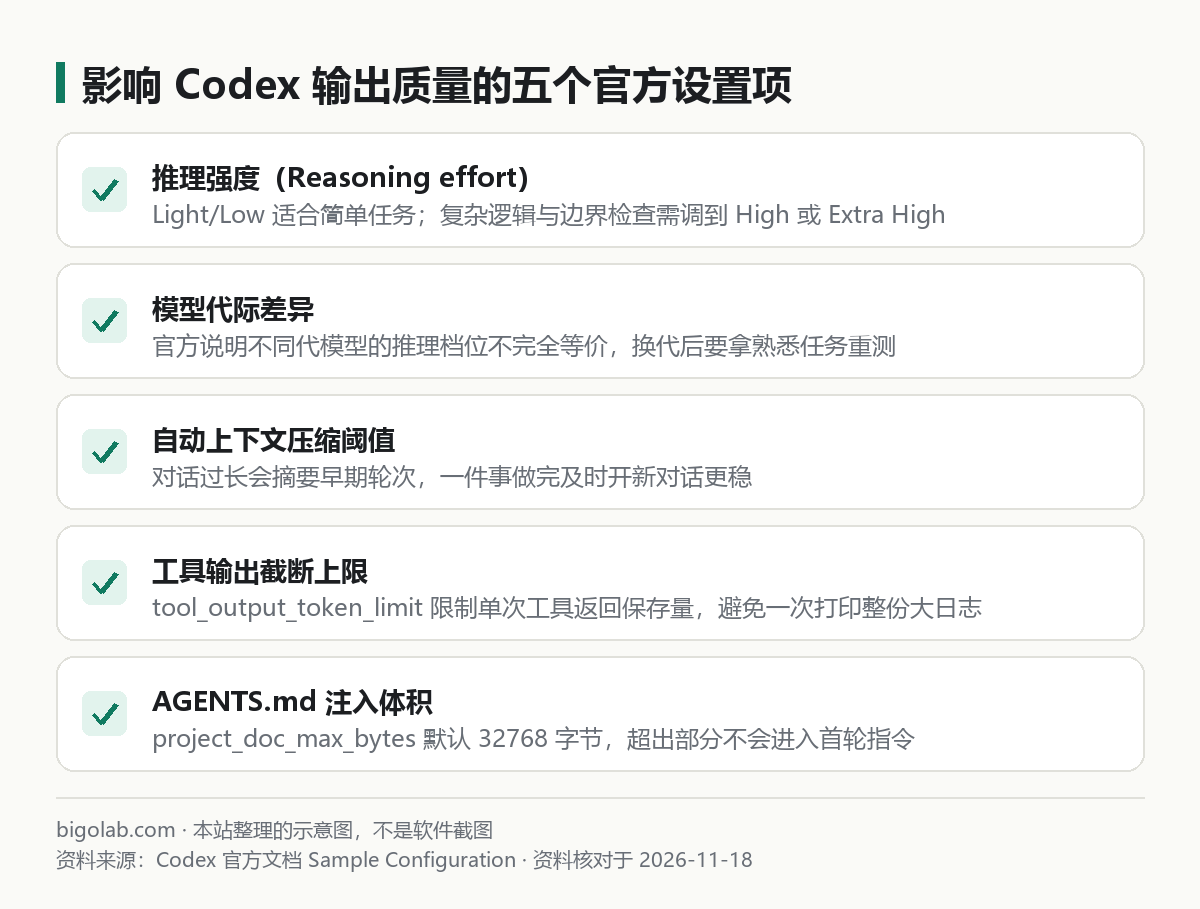
圖:本站根據 Codex 官方文檔:Sample Configuration 整理的示意圖
三、查 AGENTS.md 字節上限、信任狀態與額度提醒
如果你覺得 Codex「老寫出不符合倉庫規範的代碼」,再查四件事:
project_doc_max_bytes預設 32768 字節(32 KiB):Codex 從~/.codex/AGENTS.md到倉庫根目錄再到當前子目錄逐層拼接指令,達到 32 KiB 就停止往後添加,靠後的規則根本沒進提示詞(詳見 Codex 怎麼讀 AGENTS.md)。- 倉庫未標記為受信任(trusted):未信任目錄會跳過項目內的
.codex/config.toml;在 CLI 裏輸入/debug-config可查看配置覆蓋層,跑codex debug prompt-input可直接打印模型實際收到的完整提示詞 JSON。 - 接近額度上限或鎖了輕量模型:高檔推理和 Astra 消耗套餐額度更快。如果你因為怕 5 小時窗口見底而長期不敢開高檔,可看本站 ChatGPT Plus 充值說明 或無 5 小時窗口限制的 ChatGPT Pro 充值說明。
- 舊模型殘留:
gpt-5.5、gpt-5.3-codex-spark等已退役,請換用在用模型,選型對比見 Codex 用哪個模型好。
常見問題
問:開了 /fast(Fast 模式)會讓 Codex 變笨嗎?
答:官方說明 Fast 模式是用更高倍率的額度消耗換取更快的生成速度,並不是靠調低推理檔位湊速度;但若你順手把推理強度改成了 Low,複雜任務質素就會下降。
問:怎麼在不污染主對話上下文的前提下臨時問個旁支問題?
答:在 CLI 裏輸入 /side(或 /btw)開啟旁支對話,它的記錄與主對話隔離。
問:改完 AGENTS.md 後為什麼當前對話沒變化?
答:指令鏈在會話啟動時構建,改完後請重啟 Codex 或用 /new 新開會話再試。
相關教學
- Codex 用哪個模型好:按任務推薦
- Codex 怎麼切換模型和思考強度
- Codex 怎麼讀 AGENTS.md
- Codex 為什麼總是先重連幾次才回答、為什麼這麼慢
- ChatGPT 為什麼感覺變笨了(降智)
參考資料
- Codex 官方文檔:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文檔:Sample Configuration — https://learn.chatgpt.com/docs/config-file/config-sample
- Codex 官方文檔:Slash commands in Codex CLI — https://learn.chatgpt.com/docs/reference/slash-commands
- Codex 官方文檔:Custom instructions with AGENTS.md — https://learn.chatgpt.com/docs/agent-configuration/agents-md
0 條評論
還沒有評論,來搶沙發~