
結論先說
- 「先重連 5 次」沒有官方的單獨解釋。 能對上的只有配置參考裏一條:自定義模型提供方的流式重試次數
stream_max_retries,預設值是 5。這只是數字對應,不能直接當成原因。 - 連接問題和算得慢是兩類問題。 前者看網絡、狀態頁和連接方式;後者看模型、推理強度、對話長度和速度檔位。
- 推理強度越高,越慢,也越費 token。 官方原話要點:更高的推理強度會增加響應時間和 token 用量,可能提高複雜任務的質素。
- Fast 模式能提速,但要多耗額度。 官方說明對支持的模型,Fast 模式使用的訂閱額度是標準速率的 2.5 倍。
- 對話越長越要整理。 用
/compact把前面的內容壓縮成摘要,釋放上下文。
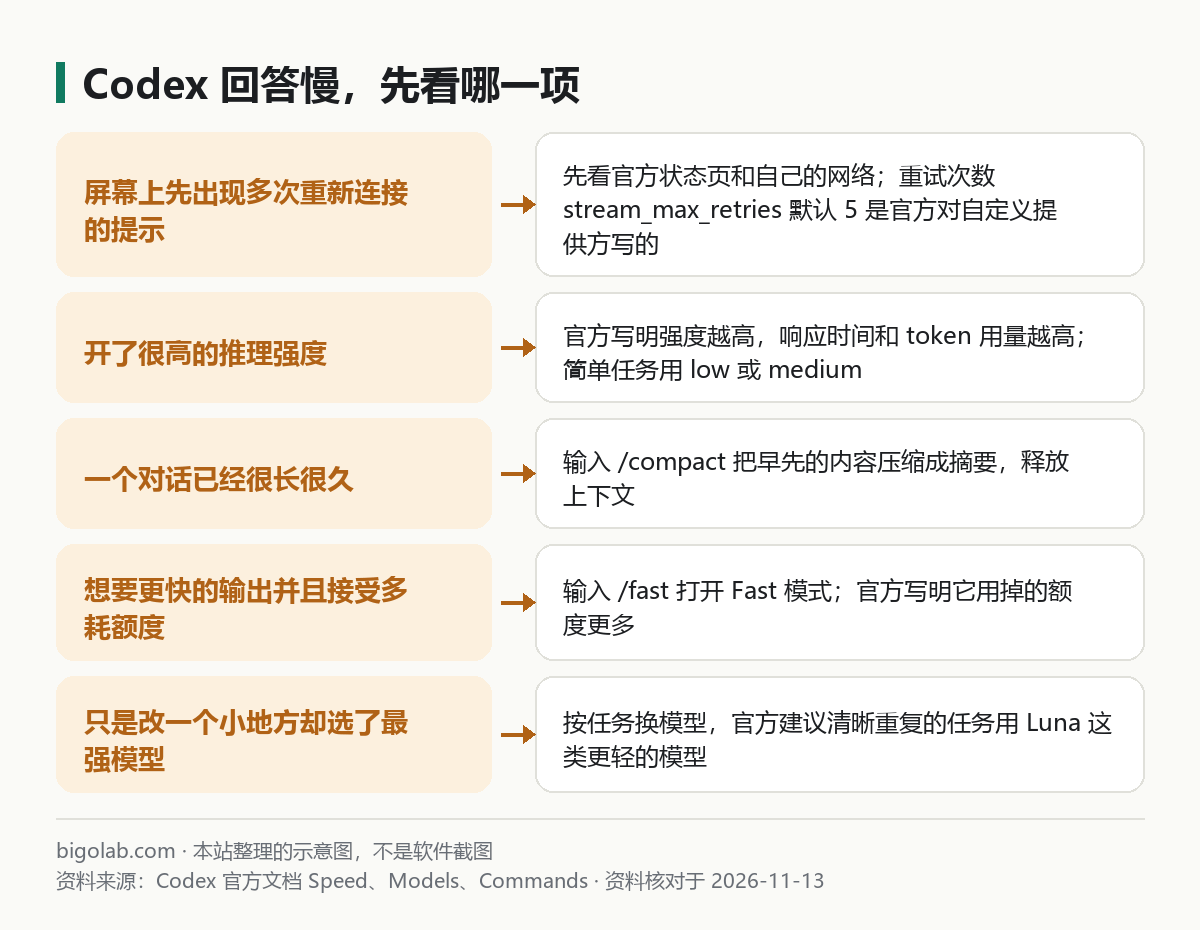
圖:本站根據 Codex 官方文檔《Speed》 整理的示意圖
本文根據 Codex 官方文檔《Configuration Reference》《Speed》《Models》和命令頁整理,資料核對於 2026-11-13。官方沒有單獨解釋「為什麼總是先重連 5 次才回答」,也沒有給「為什麼慢」一個單一答案,所以本文把官方文檔裏和速度、重試有關的內容拆開列出,幫你按順序排查。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 每次發問題,Codex 先顯示幾次重新連接,才開始輸出的人;
- 感覺 Codex 整體很慢,想知道哪些設定能讓它快一些的人;
- 擔心「調快」會多花額度,想先弄清代價的人。
一、先重連幾次:官方能確認的只有這些
先說官方有的:配置參考裏,自定義模型提供方 [model_providers.<id>] 下有這幾項和重試有關的設定:
request_max_retries:對提供方發起 HTTP 請求的重試次數,預設 4;stream_max_retries:流式輸出(SSE)被打斷後的重試次數,預設 5;stream_idle_timeout_ms:流式輸出的空閒超時,預設 300000 毫秒,也就是 5 分鐘。
所以如果你看到的是「重試 5 次後才出結果」,數字上和 stream_max_retries 的預設值一致。但是:官方把這些字段寫在「自定義提供方」的配置裏,沒有寫明用 ChatGPT 帳號直接登入時的連接是否使用同樣的次數,更沒有說每次重連的原因是什麼。所以這裏只能說「可能相關」,不能說「就是它」。
連接中途斷開的整套排查(流式連接、代理證書、狀態頁),已經有專門的教學:/guides/codex-stream-disconnected-before-completion,裏面按官方幫助中心的網絡建議排了順序。本文不重複,只給出分流的思路:
- 先看官方狀態頁 status.openai.com 有沒有 Codex 或 ChatGPT 的故障;
- 如果只有你這邊慢,檢查網絡是否穩定、是否經過公司代理或需要自定義證書的網絡;
- 如果你配置了自定義模型提供方,檢查
base_url、密鑰和上面的重試、超時設定是否合理。
二、算得慢:先看推理強度
推理強度決定模型想多久再回答。官方在多代理相關的說明裏給了各檔的使用場景:
low:任務很直接、速度最重要時用;medium:速度和深度比較均衡;high:需要梳理複雜邏輯、檢查假設、處理邊界情況時用,例如審查類任務;xhigh、max、ultra:用在特別吃推理的場景,且要所選模型支持這些檔位。
官方同時寫明:更高的推理強度會增加響應時間和 token 用量,但可能提高複雜任務的質素。所以改一個按鈕文案、寫一行註釋這種小事,沒必要開到高檔。
在命令行裏可以用命令直接改當前會話:
text
/model --reasoning=high
官方說明這條命令會保持當前模型,只把推理強度設為高(前提是該模型支持)。換成 --reasoning=low 就是降下來。完整的切換方法見 /guides/codex-switch-model-reasoning-effort。
三、再看模型:按任務選
官方模型頁給出的選擇思路是:先拿一個你熟悉的任務試,比較結果、等待時間和用量,再決定。各模型的定位,按官方寫法:
- Astra:最難的端到端工作;
- GPT-6.1 Sol:重複的、長時間運行的工作,成本也要考慮時;
- GPT-6.1 Terra:日常寫作和視覺類工作;
- Luna:清晰、可重複的任務,例如提取、分類、轉換和結構化摘要。
另外官方在 Codex 文檔裏還寫明,GPT-6.1 Sol 在 Codex 和 ChatGPT Work 裏預設的上下文窗口是 500,000 個 token。對話裏塞進去的內容越多,每一輪要處理的內容就越多,這是下一節要說的。
四、對話太長:用 /compact
官方命令頁對 /compact 的描述是:總結當前可見的對話以釋放 token,建議在長時間運行之後使用,讓 Codex 保留關鍵點而不撐爆上下文窗口。執行後,早先的輪次會被一段簡明的摘要取代,同時保留關鍵細節。
另外,配置參考裏有自動壓縮的閾值設定 model_auto_compact_token_limit,說明是「觸發自動壓縮歷史的 token 閾值,未設定時使用模型預設值」。一般情況下不需要動它。
經驗上,換了新任務就開新的對話,比在一個對話裏無限延長更利於保持速度和質素,這條是本站建議,不是官方原話。對話怎麼歸檔和刪除見 /guides/codex-delete-archive-chats。
五、Fast 模式:快一點,但額度也快一點
官方速度頁說明:可以用更高的額度消耗換更快的模型速度。
- 開關:命令行裏輸入
/fast切換,再輸入一次關閉;也可以用/statusline把它顯示在底部狀態欄; - 持久設定:在
config.toml裏寫service_tier = "fast",並把[features]下的fast_mode設為true; - 適用範圍:官方說明在你用 ChatGPT 帳號登入的桌面 App、命令行和 IDE 擴展裏可用,並且要當前模型支持。當前模型不提供 Fast 檔位時,Codex 不會顯示
/fast; - 代價:對支持的模型,Fast 模式使用的訂閱額度是標準速率的 2.5 倍;購買的額度(credits)和企業按量計費是標準的 2 倍。官方寫明對 GPT-5.6 的提速是 1.5 倍。
官方還有更快的 Ultrafast 檔,但官方寫明它目前只對 Pro $500 和符合條件的企業、教育版開放,其他自助訂閱在發佈時即使購買了額度也不能用。具體名單會變,以官方速度頁為準。
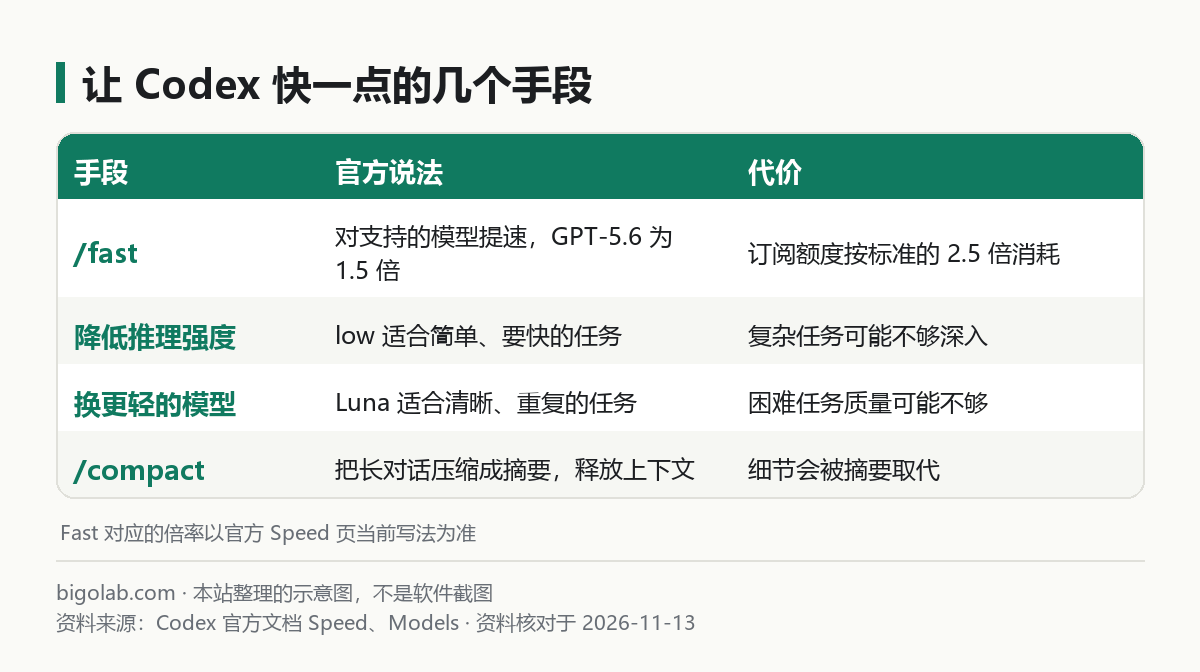
圖:本站根據 Codex 官方文檔《Speed》 整理的示意圖
六、一個排查順序
- 看狀態頁和網絡:重連頻繁、斷線,先查這一步;
- 看是不是長對話:很長就
/compact或開新對話; - 看推理強度:小任務降到 low 或 medium;
- 看模型:任務清晰且重複,換更輕的模型;
- 最後才考慮 Fast 模式,並清楚它會多耗額度;
- 額度不夠用時,先弄清楚自己的套餐,見 /guides/codex-usage-limits。
常見問題
Q:開了 Fast 還是慢?
Fast 只是提高生成速度,如果慢在連接或排隊,它幫不上忙。先看第一節。
Q:想用更多額度跑重任務怎麼辦?
Codex 隨 ChatGPT 套餐提供,高強度或 Fast 模式用得多,額度會消耗得更快。需要更多額度時,可以看看本站的 ChatGPT Plus 充值說明 或 ChatGPT Pro 充值說明,價格和額度以官方頁面當前顯示為準。
Q:為什麼同一個問題時快時慢?
官方沒有給出統一解釋。負載、網絡、對話長度和模型選擇都會影響,沒有哪一條是官方保證的。
Q:ChatGPT 網頁版轉圈很久,是同一個問題嗎?
不是,網頁版的排查見 /guides/chatgpt-slow-spinner-single-answer。
相關教學
- /guides/codex-stream-disconnected-before-completion:連接中途斷開怎麼辦
- /guides/codex-switch-model-reasoning-effort:怎麼切換模型和思考強度
- /guides/codex-usage-limits:額度與使用限制
參考資料
- Codex 官方文檔:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- Codex 官方文檔:Speed — https://learn.chatgpt.com/docs/agent-configuration/speed
- Codex 官方文檔:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文檔:Commands(CLI) — https://learn.chatgpt.com/docs/developer-commands?surface=cli
0 條評論
還沒有評論,來搶沙發~