
結論先說
- 官方高級配置頁有 Azure 的配置示例:在
config.toml裏寫一個[model_providers.azure]塊,用base_url、env_key、query_params和wire_api = "responses"描述連接方式。 - 提供方 id 自己起,但有保留名。 官方說明
openai、ollama、lmstudio、amazon-bedrock、amazon-bedrock-runtime和gcp是內置提供方,不能被覆蓋。 - 協議只支持 Responses。 官方參考寫明
wire_api唯一支持的值是responses,省略時預設就是它。也就是說,你要連的服務必須提供兼容的 Responses 接口。 - 密鑰放環境變量,不寫進文件。 官方的做法是
env_key指定變量名;雖然有experimental_bearer_token可以直接寫,但官方標註「不建議」。 - Bedrock 和 Vertex AI 有內置寫法,認證走 AWS 或 Google 自己的機制,和 Azure 的做法不同。
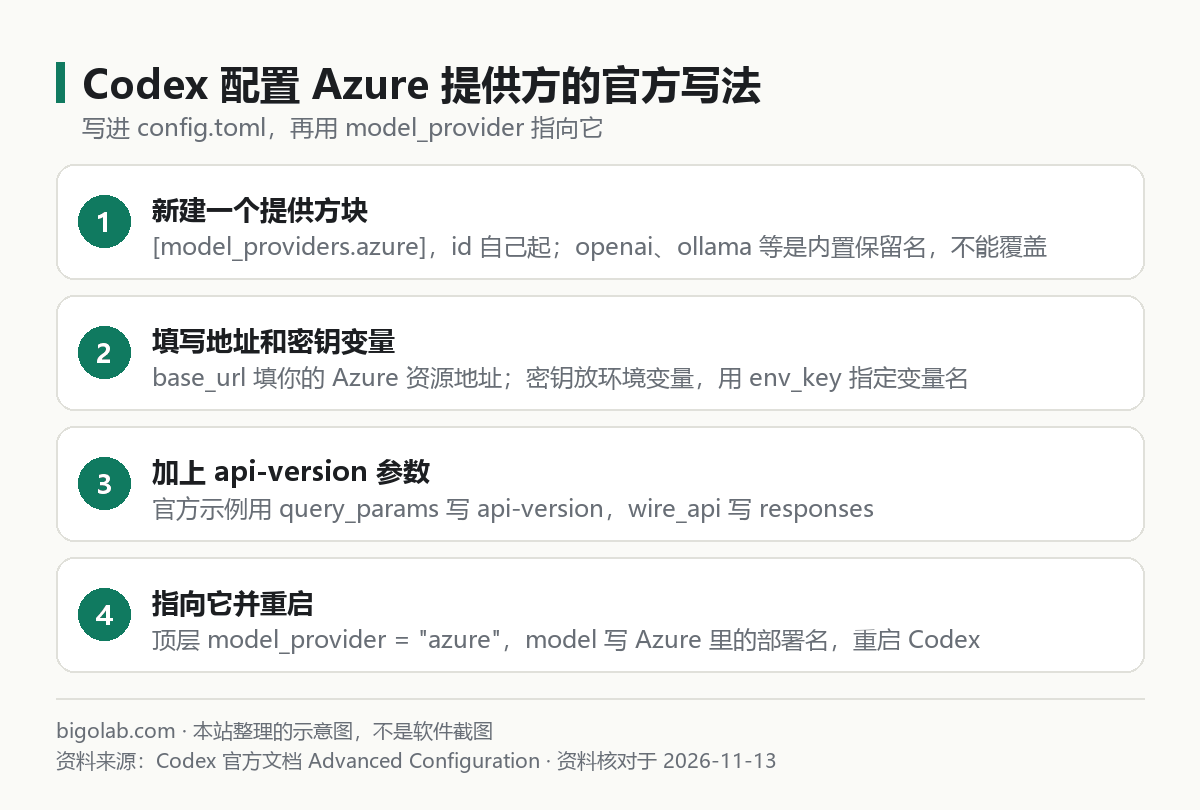
圖:本站根據 Codex 官方文檔《Advanced Configuration》 整理的示意圖
本文根據 Codex 官方文檔《Advanced Configuration》《Configuration Reference》和《Use ChatGPT Work and Codex with Amazon Bedrock》整理,資料核對於 2026-11-13。只寫官方文檔列出的模型提供方,不涉及任何第三方轉發或中轉服務。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。第三方模型怎麼接的總覽見 /guides/codex-third-party-models-deepseek-gemini-grok。
適用於誰
- 公司已經在用 Azure OpenAI,想讓 Codex 走公司的 Azure 資源的人;
- 想知道官方還支持哪些雲上提供方(Amazon Bedrock、Google Vertex AI)的人;
- 想用本地 Ollama 或 LM Studio 跑模型的人。
如果你只想直接用 ChatGPT 訂閱裏的 Codex,不需要讀這篇,見 /guides/codex-getting-started。
一、配置文件在哪
官方說明本地客戶端讀取 ~/.codex/config.toml(Windows 上是用戶目錄下的 .codex,設定了 CODEX_HOME 則以它為準)。桌面 App、命令行、IDE 擴展和 SDK 讀的是同一套本地配置層。改完儲存後,重啟 Codex 再試。
二、Azure 的官方示例
官方高級配置頁「Azure provider and per-provider tuning」一節給出的塊是這樣的:
toml
[model_providers.azure]
name = "Azure"
base_url = "https://YOUR_PROJECT_NAME.openai.azure.com/openai"
env_key = "AZURE_OPENAI_API_KEY"
query_params = { api-version = "2025-04-01-preview" }
wire_api = "responses"
request_max_retries = 4
stream_max_retries = 10
stream_idle_timeout_ms = 300000
逐項解釋(來自官方配置參考):
name:給這個提供方起的顯示名;base_url:提供方的接口地址,YOUR_PROJECT_NAME換成你自己的 Azure 資源名;env_key:提供 API 密鑰的環境變量名。你需要在運行 Codex 的環境裏設定這個變量,沒設定會報「缺少環境變量」,排查見 /guides/codex-missing-environment-variable;query_params:附加在每個請求後面的查詢參數,這裏用來帶上api-version;wire_api:使用 Responses 協議;request_max_retries:HTTP 請求的重試次數,預設 4;stream_max_retries:流式輸出被打斷後的重試次數,預設 5,示例裏調成了 10;stream_idle_timeout_ms:流式輸出的空閒超時,預設 300000 毫秒。
然後在配置文件的頂層指向它:
toml
model_provider = "azure"
model = "<你在 Azure 裏要用的模型或部署名>"
關於 model 要寫什麼:官方高級配置頁沒有說明。 Azure 的部署名、區域和模型是否可用,屬於 Azure 一側的文檔範圍,請在 Azure 的控制檯核對,再填進來。也不要原樣照抄示例裏的 api-version,它是官方示例當天的寫法,Azure 的版本會更新。
官方還在這一節末尾提醒:如果只是想改內置 OpenAI 提供方的地址,用頂層的 openai_base_url,不要新建 [model_providers.openai],因為內置提供方的 id 不能覆蓋。
三、認證相關的幾個鍵
官方配置參考列出的認證相關設定:
env_key:用環境變量提供 API 密鑰(推薦);env_key_instructions:給用戶看的、關於如何設定這個密鑰的提示,可選;experimental_bearer_token:直接寫令牌,官方標註不建議使用;requires_openai_auth:該提供方是否使用 OpenAI 的認證,預設false;[model_providers.<id>.auth]:讓 Codex 調用外部的憑據助手命令來獲取令牌,官方說明這個命令不接收標準輸入,要把令牌打印到標準輸出,並且不能和env_key、experimental_bearer_token、requires_openai_auth同時使用;http_headers和env_http_headers:給請求加固定的頭,或用環境變量提供頭的值。
如果你的公司用的是統一的模型網關,而不是直接訪問 Azure,請向管理員要提供方配置;官方有「Connect to a gateway」頁面,面向這類場景。
密鑰不要寫進提交到倉庫的文件,也不要貼給別人,檢查清單見 /guides/ai-privacy-data-safety-checklist。
四、官方內置的其他提供方
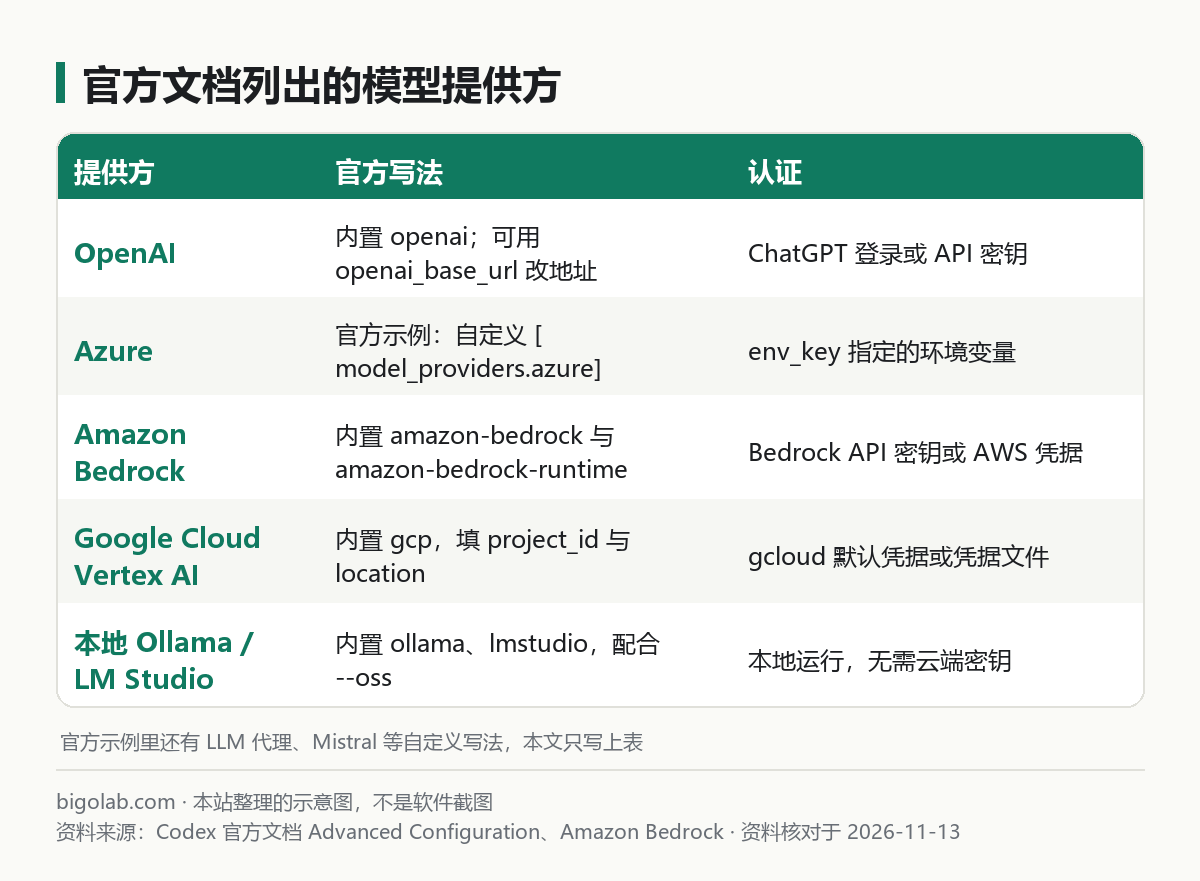
圖:本站根據 Codex 官方文檔《Advanced Configuration》 整理的示意圖
Amazon Bedrock
官方寫法:把 model_provider 設為 amazon-bedrock(Bedrock Mantle 端點)或 amazon-bedrock-runtime(Runtime 端點),再用 model 指定 Bedrock 的模型 id,必要時用 [model_providers.amazon-bedrock.aws] 指定 profile 和 region。官方 Bedrock 頁建議新配置使用 Runtime,認證有兩條路,按順序檢查:Bedrock API 密鑰(環境變量 AWS_BEARER_TOKEN_BEDROCK,必須同時指定區域),然後是 AWS 的憑據鏈(共享配置文件、訪問密鑰、SSO 命名配置、聯合身份等)。桌面 App 和 IDE 擴展可能繼承不到 shell 裏的環境變量,官方建議把需要的值寫進 ~/.codex/.env 再重啟。
Google Cloud Vertex AI
官方寫法:
toml
model_provider = "gcp"

[model_providers.gcp]
project_id = "my-project"
location = "global"
省略 project_id 或 location 時,會分別讀取 GOOGLE_CLOUD_PROJECT 和 GOOGLE_CLOUD_LOCATION,位置預設是 global。預設認證要在運行 Codex 的機器上安裝 Google Cloud CLI,本地用 gcloud auth application-default login 登入;也可以用 credential_file 指定憑據文件。
本地 Ollama 和 LM Studio
官方的「OSS mode」寫明:傳 --oss 時,Codex 可以對本地的 Ollama 或 LM Studio 運行;用 --local-provider 為一次運行指定,或用 oss_provider = "ollama"(或 "lmstudio")設預設值。都沒設定時,交互命令行會提示你選,codex exec 則直接報錯退出。一條命令接入的做法見 /guides/ollama-launch-claude-code-codex。
數據駐留
如果你的 API 組織啟用了數據駐留,官方示例是建一個提供方,把 base_url 改成帶正確前綴的地址。官方同時說明:對啟用了數據駐留的 ChatGPT 工作區,不需要自定義提供方,Codex 在你用 ChatGPT 登入時會遵循工作區的駐留設定。
五、選之前要想清楚的事
- 功能和訂閱不是一回事。 用 ChatGPT 帳號登入時用的是訂閱裏的額度;改用自定義提供方後,用量按那個提供方的規則計費,和 ChatGPT 訂閱額度無關。官方也寫明,用 API 密鑰時按 API 令牌計價。
- 有些功能依賴提供方支持。 官方有
supports_websockets、supports_standalone_web_search等能力開關,預設對自定義提供方是關的,需要提供方真的支持才有意義。Codex 雲端任務要求用 ChatGPT 登入,見官方認證頁。 - 出了問題,先區分是誰的問題。 官方 Bedrock 頁明確寫了支持邊界:Codex 客戶端的設定和行為找 OpenAI,AWS 的憑據、權限、配額等問題找 AWS。Azure 同理:連接、配額和部署問題要查 Azure 一側。
- 報錯對號入座。 401 見 /guides/codex-401-unauthorized-error,Bad Request 見 /guides/codex-detail-bad-request-error。
如果你沒有現成的雲上資源,只是想穩定使用 Codex,直接用 ChatGPT 訂閱登入通常更省事,可以看看本站的 ChatGPT Plus 充值說明,價格和額度以官方頁面當前顯示為準。
常見問題
Q:能寫 [model_providers.openai] 來改地址嗎?
不能。官方明確寫了內置提供方 id 不能覆蓋,改內置 OpenAI 提供方的地址用 openai_base_url。
Q:配置寫好了沒生效?
先確認頂層的 model_provider 指向了你的 id,且頂層鍵沒有誤放進提供方的表裏;官方在網關排查表裏把這點列在第一條。還要檢查當前使用的 profile 和配置的優先級。
Q:wire_api 能寫 chat 嗎?
官方配置參考寫明 responses 是唯一支持的值。
相關教學
- /guides/codex-third-party-models-deepseek-gemini-grok:自定義模型提供方總覽
- /guides/codex-missing-environment-variable:缺少環境變量怎麼辦
- /guides/codex-common-errors-summary:Codex 常見報錯總表
參考資料
- Codex 官方文檔:Advanced Configuration — https://learn.chatgpt.com/docs/config-file/config-advanced
- Codex 官方文檔:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- Codex 官方文檔:Use ChatGPT Work and Codex with Amazon Bedrock — https://learn.chatgpt.com/docs/amazon-bedrock
0 條評論
還沒有評論,來搶沙發~