
结论先说
- Fast 和 Ultrafast 不是缩水小模型,而是「同一个底层模型的高速推理通道」:代码生成质量与标准档一致,纯粹用更高的算力配额倍率换取更快的吐字速度。
- 官方公布的速度提升幅度:在 GPT-6.2 Astra 等主力模型上,Fast 生成速度约为标准档的 1.5 倍;Ultrafast 在 GPT-6.2 Astra 与 GPT-6.2 Sol 上最高可达标准档的 4.5 倍(在特定前代模型如 GPT-6 Astra 上最高可达 8 倍)。
- 开启与切回都很顺手:桌面与网页端直接点输入框底部的闪电图标;Codex CLI 里直接敲
/fast或/ultrafast,再重复敲一次相同命令就会退回 Standard 标准档。 - 注意额度账单:只要开启加速档,每生成相同字数就会按更高倍率消耗你套餐内的包含配额或购买积分——后台无人值守任务切记关回 Standard。
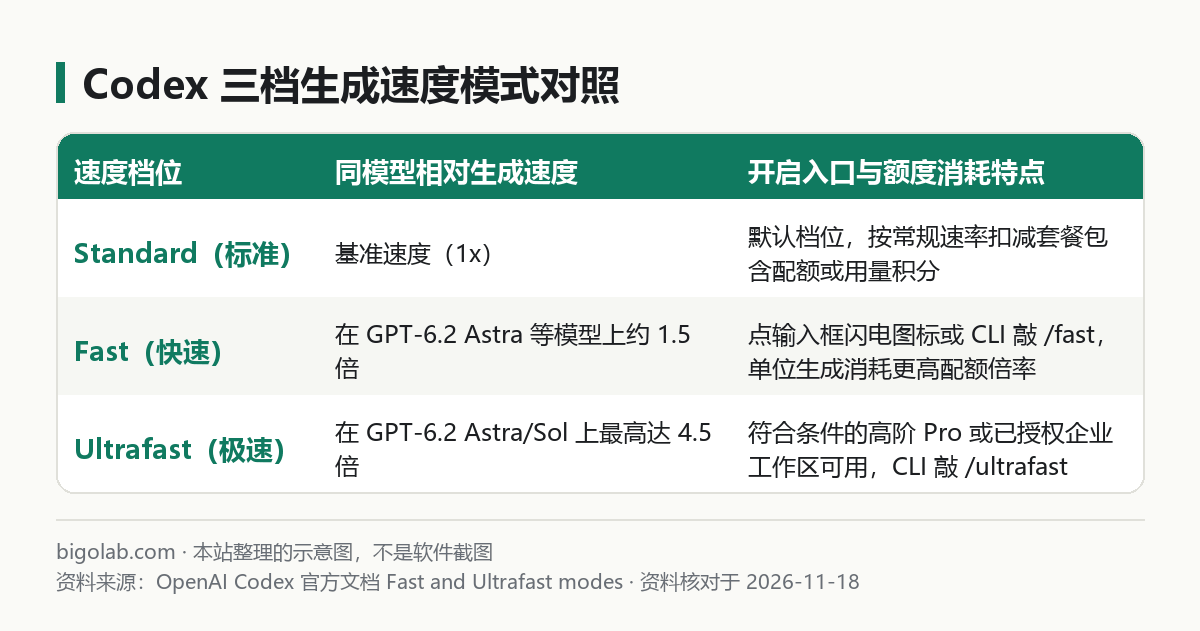
图:本站根据 OpenAI Codex 官方文档 Fast and Ultrafast modes 整理的示意图
本文根据 OpenAI Codex 官方文档《Fast and Ultrafast modes》《Pricing》整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 搜「codex fast 模式怎么开」「codex ultrafast 是什么」「codex 闪电图标扣多少额度」的开发者;
- 在紧急线上排错现场紧盯终端,嫌高推理档位旗舰模型流式生成太慢、但又不敢降级成轻量模型怕掉质量的人;
- 明明买了团队或企业工作区席位,却在输入框速度菜单里找不到 Ultrafast 选项的人。
如果你想调的是模型「想多深」(推理强度 effort)而不是「吐字多快」,请看 /guides/codex-switch-model-reasoning-effort;各模型家族本身的定位对比见 /guides/codex-which-model-to-choose-by-task。
一、桌面端、IDE 插件与 CLI 分别怎么开关
1. 桌面 App 与网页端操作
打开输入框(Composer)底部的模型选择器区域,找到旁边的闪电图标(Lightning bolt):
- 如果你当前账号与所选模型只开放了 Standard 和 Fast 两档,点击闪电图标就会直接在开关之间一键切换;
- 如果你的套餐支持 Ultrafast,点击闪电图标会弹出三档速度菜单(Standard / Fast / Ultrafast)供你挑选,也可以在高级模型选择器里的 Speed 栏修改。
2. Codex CLI 命令行操作
使用 ChatGPT 账号登录 CLI 后,在会话输入框敲 / 可以看到当前模型支持的速度命令:
text
/fast
/ultrafast
/statusline- 输入
/fast或/ultrafast立即切换,并且 CLI 会自动记住你的选择带入后续会话; - 很多人开了加速忘了关,导致后面几天日常闲聊也一直按高倍率扣配额——建议顺手运行
/statusline把速度状态固定显示在终端底部状态栏里,用完再敲一次/fast(或/ultrafast)恢复为 Standard。
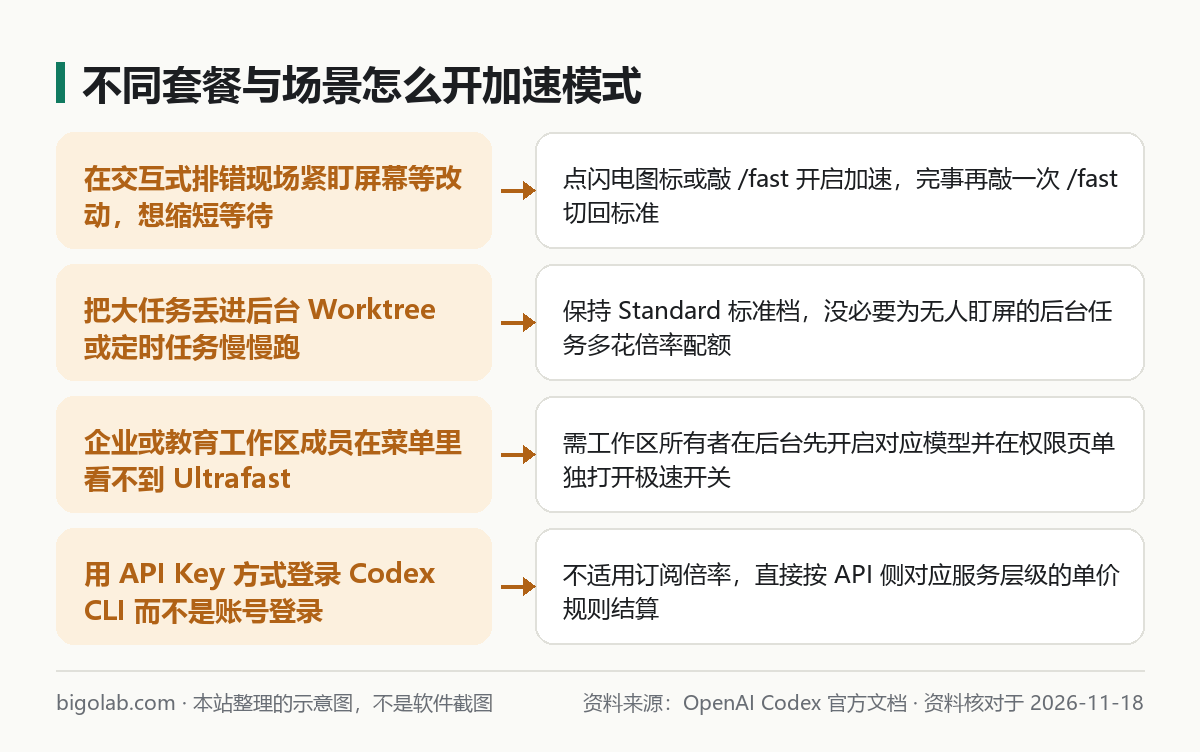
图:本站根据 OpenAI Codex 官方文档 整理的示意图
二、配额扣减规则与套餐开放门槛
加速模式是典型的「拿额度换时间」,搞清计费逻辑才能把好钢用在刀刃上(订阅、积分与 API 三套账本的关系详见 /guides/codex-pricing-subscription-credits-api-key 与 /guides/codex-usage-limits):
- 用 ChatGPT 账号登录时:无论是 Fast 还是 Ultrafast,都会优先按对应的速度乘数(Speed multiplier)扣减你当前周期的套餐包含额度,包含额度用尽后再扣可用积分(Credits);
- 用 API Key 登录 CLI 时:不走 ChatGPT 积分乘数规则,而是直接按 OpenAI API 侧对应高速服务层级的 Token 费率计费;
- Ultrafast 的高阶准入要求:Fast 模式覆盖面较广,而极速 Ultrafast 仅面向符合条件的高阶 Pro 订阅档位,以及签有积分制或按量协议的 Enterprise / Edu 工作区开放。个人高频重度开发者如需对比 Plus 与 Pro 各档位的包含配额和高速模型支持差异,可查阅 /chongzhi/chatgpt-pro 与 /chongzhi/chatgpt-plus 的整理说明。
常见问题
Q:我们公司是 Enterprise 企业工作区,为什么所有人点开闪电图标都看不到 Ultrafast?
按官方管理文档,企业工作区里的 Ultrafast 是一个默认关闭的独立权限开关。需要工作区所有者(Owner)做两步配置:先在模型可用性后台启用对应的 GPT-6.2 模型,再去「角色与工作区权限(Workspace permissions)」里为指定成员或全员勾选开启 Ultrafast 权限(同时留意数据驻留地区要求:部分模型极速推理目前仅支持特定区域如美国的数据驻留)。
Q:把任务放到后台工作树或云端异步跑时,有必要开 Fast 吗?
完全没必要。当你已经切出去干别的活、等跑完再收通知时,早两分钟跑完和晚两分钟跑完体感没有区别,保持默认的 Standard 能让同样的套餐额度多跑不少任务。只有你在结对盯屏实时一问一答调试时,开加速才真正值回票价。
相关教程
- /guides/codex-switch-model-reasoning-effort:Codex 切换模型与调整推理强度(effort)指南
- /guides/codex-which-model-to-choose-by-task:Codex 各模型家族按任务选型建议
- /guides/codex-pricing-subscription-credits-api-key:Codex 订阅额度、积分与 API Key 计费详解
- /guides/codex-usage-limits:Codex 用量限制与恢复时间说明
参考资料
- OpenAI Codex 官方文档:Fast and Ultrafast modes — https://learn.chatgpt.com/docs/fast-and-ultrafast-modes
- OpenAI Codex 官方文档:Pricing & Speed multipliers — https://learn.chatgpt.com/docs/pricing
0 条评论
还没有评论,来抢沙发~