
结论先说
- 所有主流多 Agent 框架底层的编排拓扑,拆开来都不出四种基本模式:编排者-工作者(中心主管)、去中心化交接(Handoffs)、并行化(分片与投票)、生成-评估循环。
- 需要一个中心大脑统揽全局、动态拆题并汇总多方结果时,选「编排者-工作者」(OpenAI 称为 Manager / Agents as Tools)。
- 对话主题已经彻底转向另一个专业领域、前序节点无需再插手时,选「交接(Handoffs)」,直接把当前会话控制权移交给下游专家。
- 子任务彼此无依赖、只想缩短总等待时间或交叉核验时,选「并行化」,在应用代码层并发调用再合并结果。
- 复杂工程里四种模式常常嵌套组合——比如中心主管在底层并发派出三个检索工作者,拿到汇总初稿后再走一轮评估代理质检。
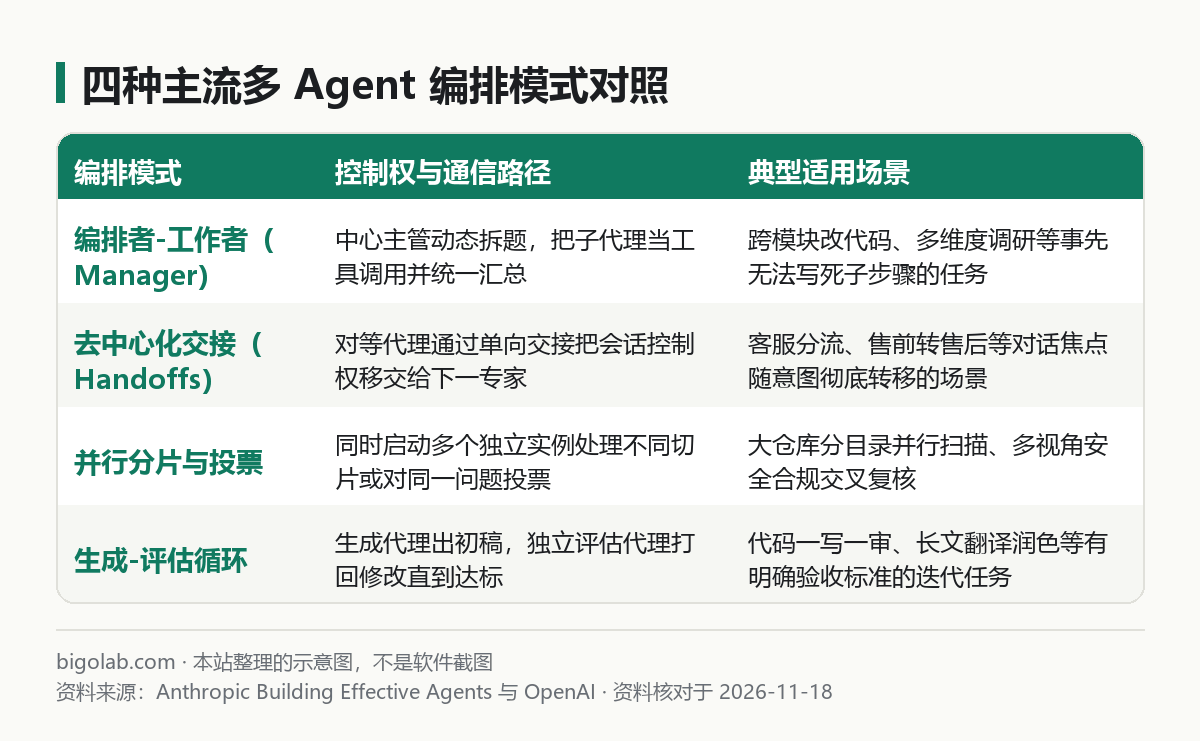
图:本站根据 Anthropic Building Effective Agents 与 OpenAI 指南 整理的示意图
本文根据 Anthropic 官方工程指南《Building effective agents》与 OpenAI 官方指南《A practical guide to building agents》整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方网站。
适用于谁
- 搜「multi-agent orchestration 中文」「多 agent 编排模式」的人;
- 已经决定要做多智能体(判断依据见 /guides/multi-agent-what-is-when-to-use),但不知道代理之间该设成「上下级汇报」还是「平级转交」的开发者;
- 看不同开源框架文档时,被 Supervisor、Manager、Swarm、Handoffs、Fan-out 等名词搞混的人。
一、模式一:编排者-工作者(Orchestrator-Workers / Manager)
这是软件研发与深度研究助手里最常用的主从结构。中心有一个编排者(Orchestrator / Manager),手下挂载若干专职工作者(Workers)。
它的关键特征是「动态拆解 + 控制权不外放」:
- 子步骤不是写死的:面对用户一句话需求(比如「重构鉴权模块并补齐受影响接口的测试」),事先没法在代码里硬编码到底要改几个文件。中心编排者先读现场情况,再动态决定派哪几个工作者、传什么任务描述;
- 子代理表现为一个工具调用:工作者在自己的隔离上下文里干完活,把结果作为工具返回值交回中心编排者,始终由编排者跟用户对话并负最终合成责任。
落地提示:编排者负责全局判断,建议配强推理模型;底下的只读检索或格式提取工作者配轻量模型即可,模型分级思路见 /guides/openai-multi-model-routing-cheap-vs-strong。
二、模式二:去中心化交接(Decentralized / Handoffs)
OpenAI 在指南里把「交接(Handoffs)」与上面的中心主管模式并列为两大核心多代理拓扑(SDK 代码级对比见 /guides/openai-agents-sdk-handoffs-vs-agents-as-tools)。
在这套拓扑里,各个代理是对等节点(Peers),没有高高在上的总管:
- 前台接待代理先识别用户来意;
- 一旦确认用户要办「退订退款」,接待代理调用一次交接函数,单向把活跃会话的控制权和必要历史转移给售后专员代理,自己随即退出本轮执行;
- 接下来用户的追问直接由售后专员代理接住,不再每次绕回前台传话。
这种模式省掉了中心主管每轮中转复述的延迟和 Token 开销,特别适合多轮客服分流、按业务线切分的企业内网门户。但设计时必须防住一个坑:避免 A 交接给 B、B 觉得不归自己管又交接回 A 的死循环,务必在运行器上设最大跳转次数并加好输入输出护栏(见 /guides/openai-agents-sdk-guardrails-tracing)。
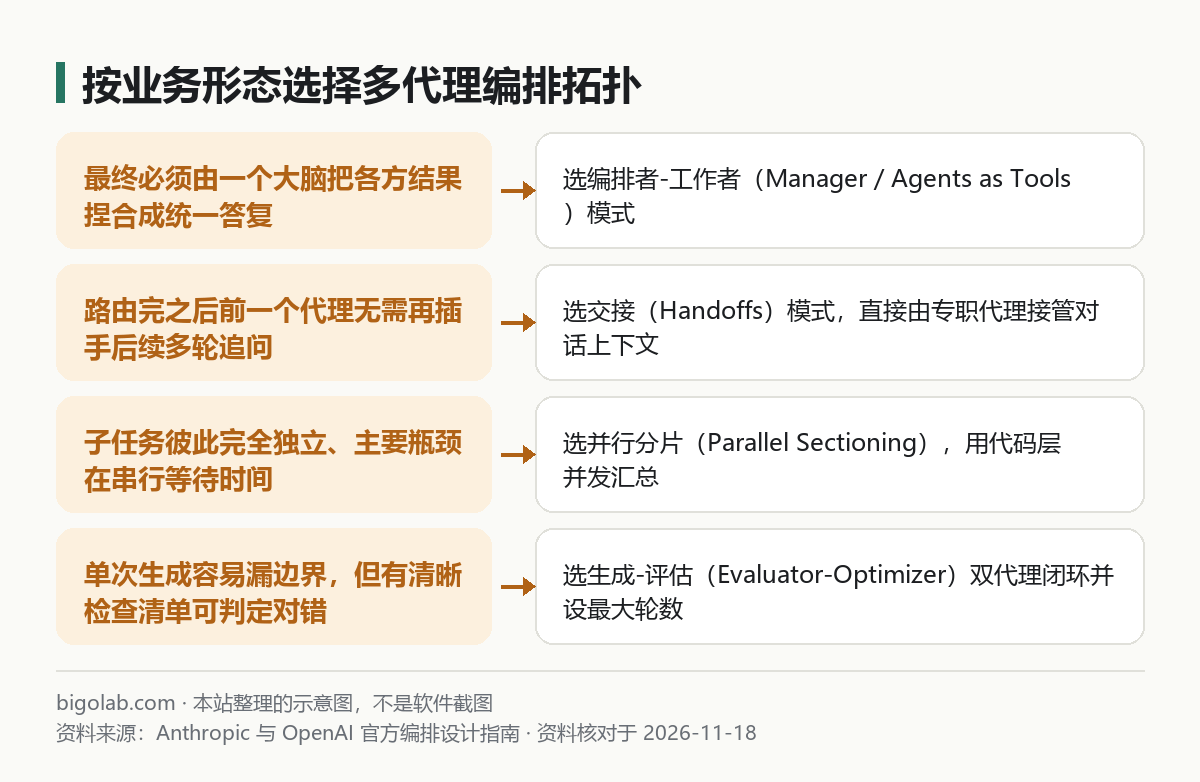
图:本站根据 Anthropic 与 OpenAI 官方编排设计指南 整理的示意图
三、模式三:并行化(Parallelization:分片与投票)
Anthropic 把并行模式细分为两种截然不同的用法,它们的共同点是不靠大模型临时想怎么拆,而是由你写好的确定性代码并发发出请求(例如 Python 的 asyncio.gather 或 TypeScript 的 Promise.all):
- 分片(Sectioning):把一件大事按固定维度切成互不干扰的几块同时跑。比如审阅一份 Pull Request 时,代码同时发给三个专职提示词:一个只查 SQL 注入与鉴权安全,一个只查性能慢查询,一个只核对接口命名规范,最后合并成一份评审列表,总耗时只取决于最慢的那一路;
- 投票(Voting):把同一道高风险判断题同时发给多个不同视角或不同提示词的调用,按多数票或「一票否决」做决断。常见于内容合规筛查或高危线上变更审批,用几倍的输入成本换取更低的漏报率。
四、模式四:生成-评估循环(Evaluator-Optimizer)
当你发现单次提示词无论怎么调,模型写出来的长代码或复杂翻译总是顾此失彼时,可以把「创作者」和「挑刺者」拆成两个独立代理形成反馈闭环:
- 生成代理(Generator) 按需求给出第一版产出;
- 评估代理(Evaluator) 对照一份明确的验收清单逐项打分,如果未通过,给出具体的缺陷位置和修改方向(但不自己动手重写);
- 生成代理拿到反馈改出第二版,直到评估通过或达到你设定的最大迭代轮数(通常设 2 到 3 轮即可,再多边际收益递减)。
平时在网页端或客户端验证这套多角色提示词、对比不同主力模型的指令遵循度时,若需要稳定的个人订阅环境,可参考 /chongzhi/claude-pro 或 /chongzhi/chatgpt-plus 的官方套餐说明。
常见问题
Q:「路由(Routing)」和「交接(Handoffs)」是一回事吗?
路由通常是单轮入口处的轻量分类器(识别问题类型后分发给一条独立链路,做完即结束);而交接面向的是持续多轮的有状态智能体对话,即使在对话中途需求变了,当前专家也能再次把控制权交接给下一个专家。
Q:编排者-工作者和并行分片怎么区分?
看「子任务清单是谁定的」。如果每次固定拆成安全、性能、规范三路,代码直接并发调就行,这是并行分片;如果必须先让大模型读完用户问题才能决定今天要派几个代理、各查哪张表,这就是编排者-工作者。
Q:真实项目里要把这四种全用上吗?
千万别为了凑模式而堆叠层级。每多套一层编排,端到端延迟和排查难度就会翻一截。每次只针对当前最卡脖子的那个痛点引入一种模式,用追踪日志验证确有提升后再保留。
相关教程
- /guides/multi-agent-what-is-when-to-use:多智能体是什么、什么时候值得用
- /guides/openai-agents-sdk-handoffs-vs-agents-as-tools:OpenAI Agents SDK 交接与工具化代理代码对比
- /guides/openai-agents-sdk-guardrails-tracing:多代理护栏拦截与链路追踪实战
- /guides/openai-multi-model-routing-cheap-vs-strong:多模型分级路由与成本优化
参考资料
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI:A practical guide to building agents — https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
0 条评论
还没有评论,来抢沙发~