
结论先说
- LangGraph 的核心思想只有一句话:把智能体工作流写成一张「共享状态(State)在函数节点(Node)之间顺着边(Edge)循环流转」的有向图。
- Python 安装需要拆成「核心图引擎 + 模型集成包」两部分:先装
langgraph,再按你手里的密钥装langchain-openai、langchain-anthropic或本地langchain-ollama。 - 关于「中文文档」的避坑提醒:官方唯一实时维护的主文档在
docs.langchain.com(英文)。看第三方中文搬运教程时,凡是还在教旧版MessageGraph而不用StateGraph+START/END的,说明版本已经落后,照抄容易报弃用警告。 - 写第一个带工具的图只需四个固定积木:
MessagesState(存对话)、模型调用节点、ToolNode(跑工具)和tools_condition(判断继续循环还是结束)。
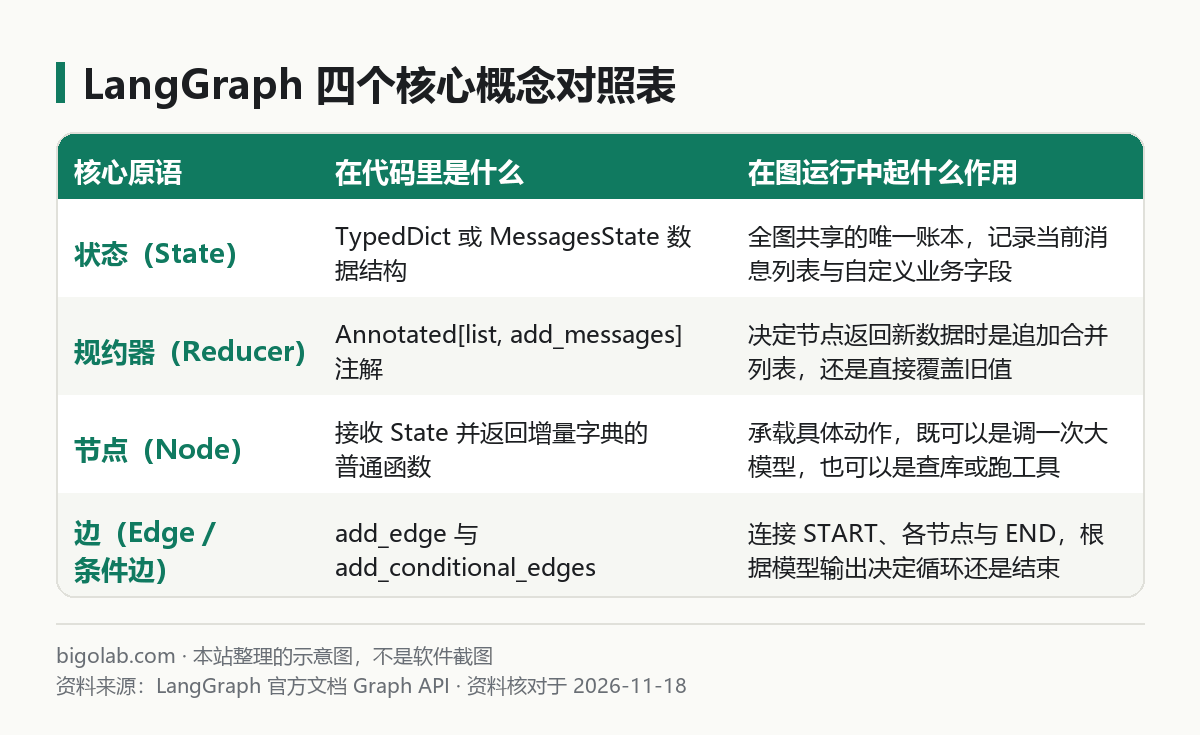
图:本站根据 LangGraph 官方文档 Graph API 整理的示意图
本文根据 LangChain / LangGraph 官方文档与langchain-ai/langgraph官方 GitHub 仓库整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 LangChain 官方网站。
适用于谁
- 搜「python 安装 langgraph」「langgraph 中文 文档」「langgraph 入门教程」的人;
- 想摆脱黑盒框架封装,用清晰的图节点与条件边自己控制智能体每一步流转的 Python 开发者;
- 在网上搜到过时教程(还在用废弃类或跑不通导入语句),需要一份对齐新版
StateGraph标准写法的最小可运行模板的人。
如果你还不确定项目该选代码级状态图还是选现成引擎,可先对比 /guides/claude-agent-sdk-vs-langchain-how-to-choose 与 /guides/multi-agent-what-is-when-to-use。
一、Python 环境准备与安装命令
建议使用 Python 3.10 及以上版本,并在独立的虚拟环境里安装,避免和全局旧版 langchain 包产生依赖冲突:
bash
mkdir lg-demo && cd lg-demo
python -m venv .venv
# macOS / Linux 激活:
source .venv/bin/activate
# Windows PowerShell 激活:
# .venv\Scripts\Activate.ps1

pip install -U langgraph langchain-core langchain-openai
如果你使用的是 Claude 官方 API Key,把最后一行的 langchain-openai 换成 langchain-anthropic 即可。接着在终端设置好对应的环境变量(例如 OPENAI_API_KEY 或 ANTHROPIC_API_KEY)。
二、动手前先读懂四个核心原语
在敲代码之前,先把 LangGraph 图里的四个角色对上号,后面多复杂的编排(见 /guides/multi-agent-orchestration-patterns)都是这四样东西的排列组合:
- 状态(
State):整张图流转时唯一传递的字典数据结构。对于聊天与工具智能体,官方内置了开箱即用的MessagesState,里面自带一个配好了add_messages追加规则的messages列表; - 节点(
Node):就是一个普通的 Python 函数——输入是当前State,输出是「这一步新增或修改的字典字段」(而不是整份旧状态); - 普通边(
add_edge):无条件从节点 A 走到节点 B,例如工具跑完后固定回到大模型节点汇报结果; - 条件边(
add_conditional_edges):相当于图里的红绿灯。检查大模型上一句回复里有没有发起工具调用(tool_calls),有就拐去工具节点执行,没有就直接走向终点END。
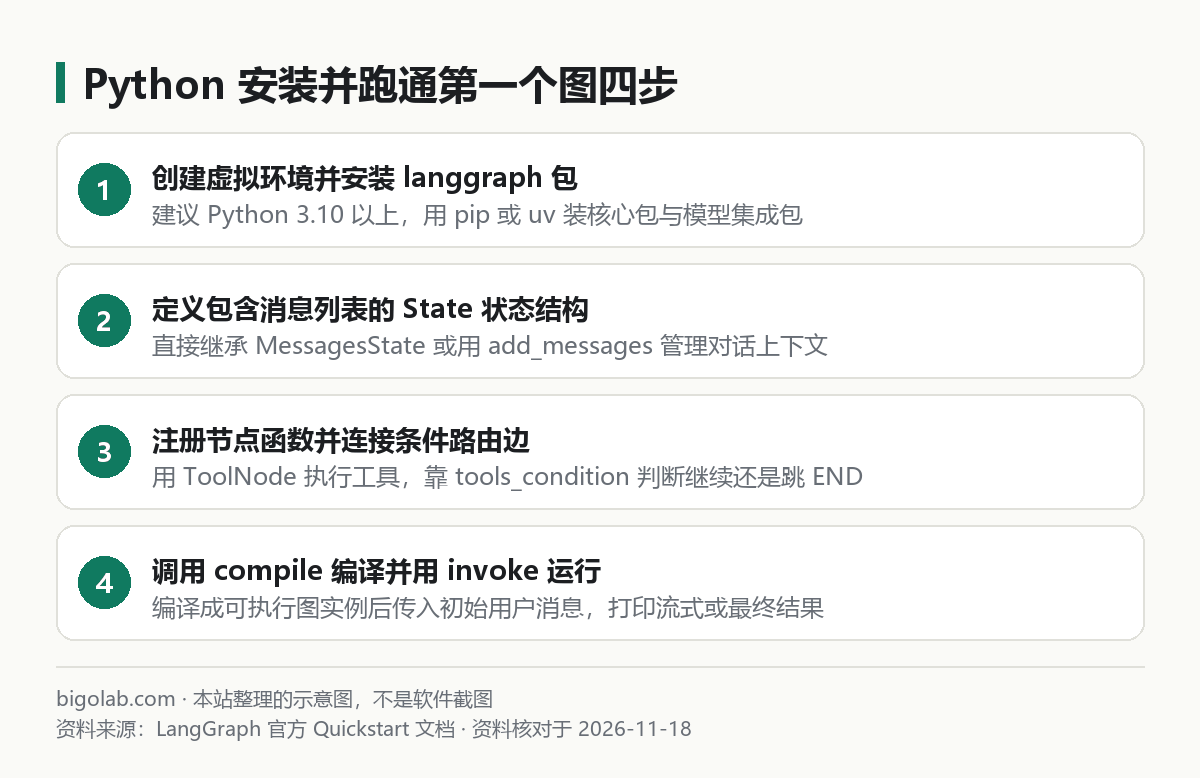
图:本站根据 LangGraph 官方 Quickstart 文档 整理的示意图
三、完整代码:从零跑通第一个工具调用图
新建 first_graph.py,粘贴下面这段不到 50 行的标准 Graph API 代码。它定义了一个简单的单位换算工具,并构建「模型思考 → 调工具 → 再思考 → 输出最终答案」的完整闭环:
python
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode, tools_condition

# 1. 定义一个带清晰类型注解和文档注释的工具函数
@tool
def convert_celsius_to_fahrenheit(celsius: float) -> float:
    """将摄氏温度换算为华氏温度。"""
    return celsius * 9 / 5 + 32

tools = [convert_celsius_to_fahrenheit]

# 2. 初始化大模型并绑定工具表
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0).bind_tools(tools)

# 3. 定义大模型推理节点:接收当前消息历史,返回新生成的回复
def chatbot_node(state: MessagesState):
    response = llm.invoke(state["messages"])
    return {"messages": [response]}

# 4. 组装状态图
builder = StateGraph(MessagesState)
builder.add_node("chatbot", chatbot_node)
builder.add_node("tools", ToolNode(tools))

builder.add_edge(START, "chatbot")
# 如果模型发起了工具调用就去 tools 节点,否则跳向 END 结束
builder.add_conditional_edges("chatbot", tools_condition)
builder.add_edge("tools", "chatbot")

# 5. 编译并运行
graph = builder.compile()

if __name__ == "__main__":
    result = graph.invoke({
        "messages": [("user", "今天室温 25 摄氏度,换算成华氏度是多少?")]
    })
    for msg in result["messages"]:
        msg.pretty_print()
运行 python first_graph.py,你会依次看到四条消息轨迹:人类提问 → 模型发出 convert_celsius_to_fahrenheit(celsius=25.0) 工具请求 → ToolNode 算出 77.0 返回 → 模型汇总输出最终中文答复。
四、加三行代码开启多轮对话记忆
上面的 graph.invoke 默认是无状态的——第二次调用 invoke 时它不记得上一句聊了什么。想在本地开启多轮会话记忆,只需引入内置的内存检查点保存器 InMemorySaver 并传入 thread_id:
python
from langgraph.checkpoint.memory import InMemorySaver

memory = InMemorySaver()
graph_with_memory = builder.compile(checkpointer=memory)

config = {"configurable": {"thread_id": "demo-user-1"}}
graph_with_memory.invoke({"messages": [("user", "我叫小周,住在北京")]}, config)
res = graph_with_memory.invoke({"messages": [("user", "刚才说我叫什么?")]}, config)
print(res["messages"][-1].content)
如果团队希望不写 Python 代码、直接通过拖拽画布先验证节点流程,也可以对比无代码工作流工具 /guides/dify-how-to-use-cloud-getting-started;日常借助网页端 ChatGPT 或 Claude 辅助阅读官方英文源码文档时,个人账号订阅说明可参考 /chongzhi/chatgpt-plus。
常见问题
Q:安装时报错找不到 langgraph.prebuilt 或版本冲突怎么办?
多半是因为旧项目环境里残留了很老版本的 langchain-core。新建干净的 .venv 虚拟环境,执行 pip install -U langgraph langchain-core 统一升到最新稳定版即可解决。
Q:什么时候用高层快捷函数、什么时候手写 StateGraph?
如果只是做标准「单模型 + 一组工具」循环,用官方预置封装几行就能跑起来;但一旦你需要在图里插入自定义业务字段(比如记录重试次数、审批状态)或编排多个不同职责的节点,上面这种显式手写 StateGraph 的方式最直观、最好改。
Q:InMemorySaver 能直接用在正式生产环境吗?
不能。内存保存器只活在当前 Python 进程里,服务一重启所有历史对话就清空了。生产上线时应切换到官方提供的持久化检查点包(例如基于 PostgreSQL 或 SQLite 的保存器),节点代码完全不用改,只替换 compile(checkpointer=...) 传入的对象即可。
相关教程
- /guides/claude-agent-sdk-vs-langchain-how-to-choose:Claude Agent SDK 与 LangChain / LangGraph 怎么选
- /guides/multi-agent-orchestration-patterns:多 Agent 四大编排拓扑详解
- /guides/multi-agent-what-is-when-to-use:多智能体适用场景判断标准
- /guides/dify-how-to-use-cloud-getting-started:Dify 可视化工作流快速入门
参考资料
- LangChain / LangGraph 官方文档 — https://docs.langchain.com/
langchain-ai/langgraph官方 GitHub 仓库 — https://github.com/langchain-ai/langgraph
0 条评论
还没有评论,来抢沙发~