
结论先说
- 先分清「记笔记(Memory)」和「连续聊天(Multi-turn Chat)」:
Crew(memory=True)解决的是让团队自动检索过往片段与实体特征;而像聊天机器人一样一问一答维护历史消息列表,靠的是 CrewAI Flows(状态流)加@persist持久化。 - 一行
memory=True会同时激活三层存储:基于本地向量库(ChromaDB)的短期记忆与实体记忆,加上基于本地 SQLite 的跨次长期经验记忆。 - 非 OpenAI 用户必看避坑点:CrewAI 的向量记忆默认使用 OpenAI 的嵌入接口算向量;如果你主模型用的是 Anthropic 或本地 Ollama,必须显式配置
embedder字段,否则一开记忆就会报缺密钥。 - 单次任务中途只需人工拍板一句话时,不用搭多轮聊天架构,直接在对应
Task上设human_input=True即可暂停等你在终端补充意见。
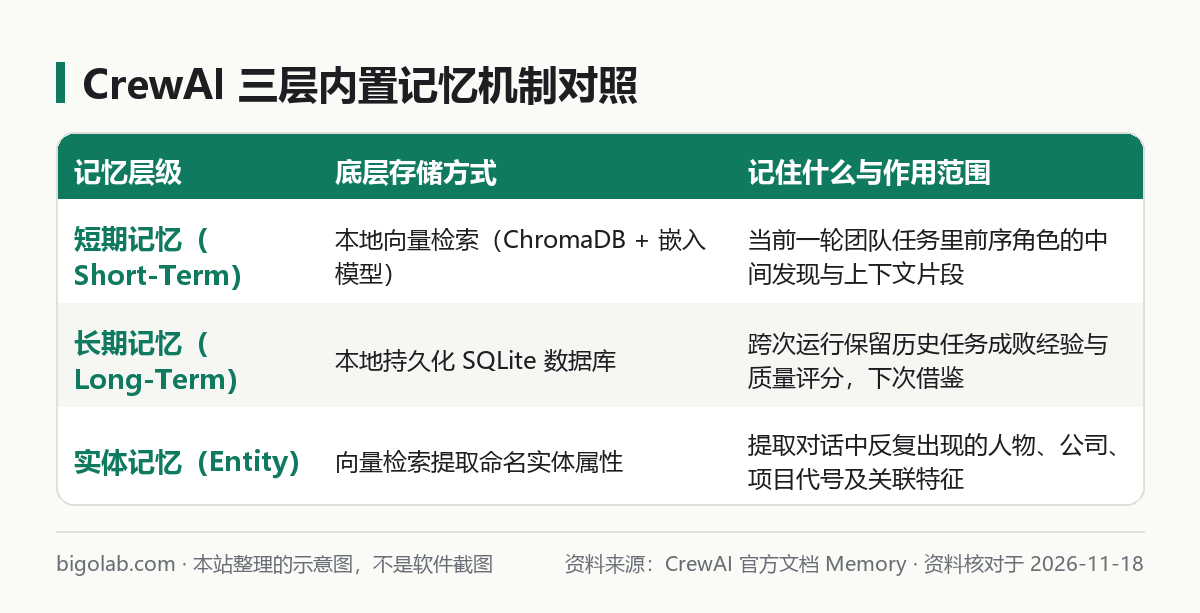
图:本站根据 CrewAI 官方文档 Memory 整理的示意图
本文根据 CrewAI 官方文档《Memory》《Flows》整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 CrewAI 官方网站。
适用于谁
- 搜「crewai 多 轮 对话」「crewai memory 怎么配置」的人;
- 已经跑通了单次
crew.kickoff()批处理任务(基础写法见 /guides/crewai-quickstart-roles-tasks-processes),想把它改造成能记住上一轮上下文、跟用户反复追问的对话式应用的开发者; - 加上
memory=True后突然报OPENAI_API_KEY缺失错误(明明主模型配的是 Claude 或本地 Ollama),正在查原因的人。
一、memory=True 背后自动开启了哪三层记忆
在默认不传参数的 Crew 里,每次运行 kickoff() 都是从零开始。当你把开关打开后,框架会在本机自动建起三套互补的记忆库:
- 短期记忆(Short-Term Memory):基于向量相似度检索,让排在后面的角色能按相关性召回当前这一轮协作中前序角色查到的关键上下文,而不必硬塞全部原始文本;
- 长期记忆(Long-Term Memory):存入本机 SQLite 数据库,记录每次任务跑完后的自我评估与经验教训。下次再跑同类任务时,角色会先参考上次哪里做得好、哪里踩了坑;
- 实体记忆(Entity Memory):专门提取并追踪对话里反复出现的具体名词(客户名、产品代号、技术组件名)及其属性关系。
自定义 embedder(不用 OpenAI 密钥也能开记忆)
因为短期记忆和实体记忆底层要算文本向量,当你的主力模型是 Claude 或本机 Ollama 时,请在 Crew 里一并指定 embedder,避免默认去找 OpenAI 接口报错:
python
from crewai import Crew, Process

my_crew = Crew(
    agents=[analyst, writer],
    tasks=[research_task, write_task],
    process=Process.sequential,
    memory=True,
    embedder={
        "provider": "ollama",
        "config": {
            "model": "nomic-embed-text",
            "url": "http://127.0.0.1:11434/api/embeddings",
        },
    },
)
如果你想清空某次测试污染的旧记忆,可以直接在命令行运行 crewai reset-memories --all 按类型重置本地数据库。
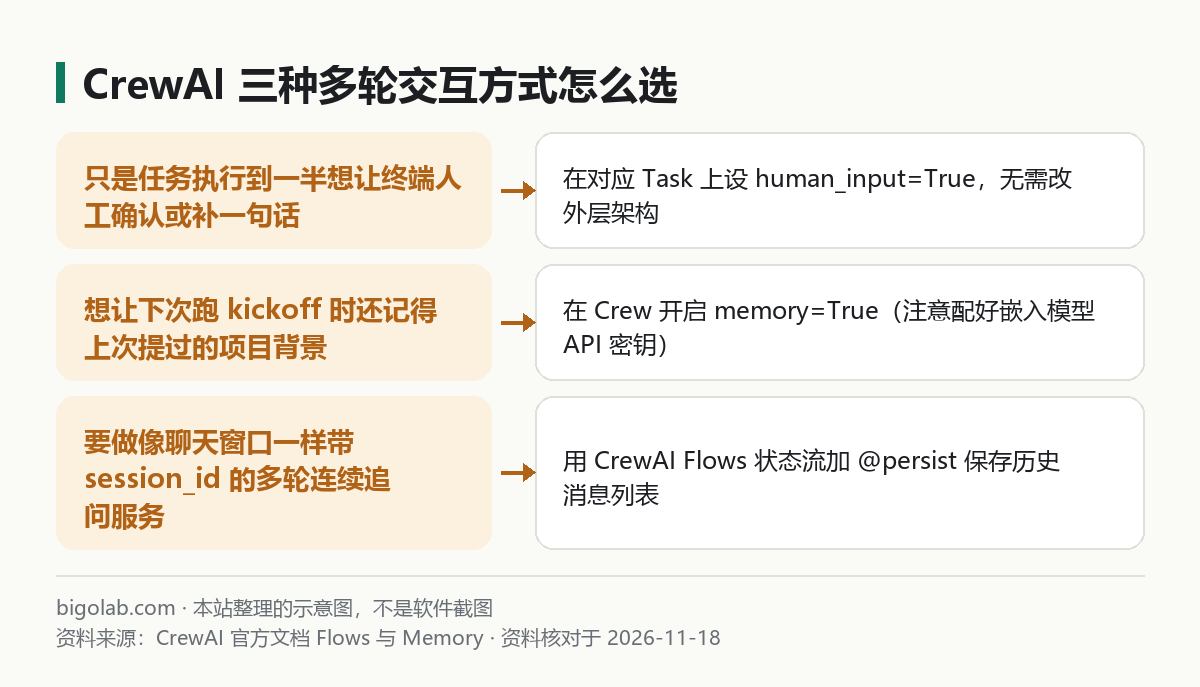
图:本站根据 CrewAI 官方文档 Flows 与 Memory 整理的示意图
二、真正的多轮对话怎么做:用 Flows 状态流管历史记录
很多新手试图在一个 while True: 循环里死磕同一个批处理 Crew,每次只塞最新一句用户输入,结果发现团队根本接不上话。原因很简单:Crew 天生是为「给定目标 → 多角色协作交付一份产物」设计的批处理单元。
要做带会话 ID 的多轮连续对话,官方推荐在 CrewAI Flows 里维护结构化状态(包含 history 消息列表),并在需要深度协作的回合按需调起底层的 Crew,或者配合 @persist() 装饰器自动按状态 ID 落盘恢复:
python
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class ChatState(BaseModel):
    history: list[dict] = []
    latest_user_msg: str = ""

@persist()  # 自动将每次执行后的 ChatState 持久化到默认 SQLite 存储
class SupportChatFlow(Flow[ChatState]):

    @start()
    def handle_turn(self):
        # 1. 追加本轮用户提问到持久化的对话历史
        self.state.history.append({"role": "user", "content": self.state.latest_user_msg})

        # 2. 将最近几轮精简上下文格式化后传入你的专职 Crew(避免无限堆叠)
        recent_context = "\n".join(
            f"{m['role']}: {m['content']}" for m in self.state.history[-6:]
        )
        crew_output = support_crew.kickoff(inputs={
            "chat_history": recent_context,
            "question": self.state.latest_user_msg,
        })

        reply = crew_output.raw
        self.state.history.append({"role": "assistant", "content": reply})
        return reply

# 同一个 id 跨多次请求自动恢复上一轮保存的 history
flow = SupportChatFlow()
ans1 = flow.kickoff(inputs={"id": "session-1001", "latest_user_msg": "我们后端用的是 PostgreSQL 16"})
ans2 = flow.kickoff(inputs={"id": "session-1001", "latest_user_msg": "针对刚才说的数据库版本,升级连接池要注意什么?"})
注意代码里的一个小细节:我们只截取了 history[-6:] 喂给下一轮 kickoff,同时配合 memory=True 召回更早的关键实体——既实现了连贯追问,又防止几十轮长聊把每个 Agent 的输入 Token 翻倍撑爆(控费逻辑见 /guides/multi-agent-token-cost-why-high-how-to-control)。
三、和 LangGraph 的多轮记忆对比怎么选
对比我们在 /guides/langgraph-quickstart-install-first-graph 里写过的 MessagesState + Checkpointer 可以看出:如果你的核心产品形态从第一天起就是一个高并发、随时中途打断转向的多轮对话机器人(编排差异见 /guides/multi-agent-orchestration-patterns),LangGraph 原生以消息流为中心的检查点机制更直接;而如果你的核心是「对话收集完需求后,触发后台三四个专家角色合写一份深度方案」,用 CrewAI 的 Flows + Crew 组合写起来更省心。日常借助网页端 ChatGPT 或 Claude 调试复杂多轮提示词模板时,个人官方订阅渠道可参考 /chongzhi/chatgpt-plus。
常见问题
Q:本地存储的记忆文件默认放在电脑什么位置?部署多实例容器会丢吗?
CrewAI 默认把 ChromaDB 与 SQLite 记忆文件存在操作系统的用户应用数据目录下(可通过设置环境变量 CREWAI_STORAGE_DIR 改到指定挂载卷)。容器化部署时务必把该目录挂载到持久化存储卷,或接入外部托管记忆后端,否则容器重建后长期记忆会清空。
Q:只想要角色在交付最终稿前问我一句「还需不需要补充」,怎么开最简单?
不用写 Flow,直接在最后一个把关 Task 里加上 human_input=True。任务跑完初稿后会在控制台停住等待你的键盘输入:你敲回车确认满意即结束,如果输入修改意见,当前 Agent 就会结合你的反馈重改一版再交付。
相关教程
- /guides/crewai-quickstart-roles-tasks-processes:CrewAI 角色、任务与顺序/层级流程快速入门
- /guides/langgraph-quickstart-install-first-graph:LangGraph 状态图与
InMemorySaver多轮记忆对比 - /guides/multi-agent-orchestration-patterns:多 Agent 四大编排模式与交接逻辑
- /guides/multi-agent-token-cost-why-high-how-to-control:多轮多代理系统的上下文裁剪与控费
参考资料
- CrewAI 官方文档:Memory 与 Flows — https://docs.crewai.com/
crewAIInc/crewAI官方开源仓库 — https://github.com/crewAIInc/crewAI
0 条评论
还没有评论,来抢沙发~