
结论先说
- LangGraph 把记忆明确拆成两套各司其职的组件:Checkpointer(检查点) 管「当前这一个对话窗口(
thread_id)聊到了哪一步」,Store(长期存储) 管「同一个用户(user_id)打开新窗口也该记住的长期偏好」。 - 上线生产首选开源免费的
langgraph-checkpoint-postgres:无需购买商业托管平台(费用边界见 /guides/langgraph-pricing-open-source-vs-platform),直接连你们自己的 PostgreSQL 即可支撑多节点无状态扩容。 - 首次连上空数据库后必须先调一次
.setup():用于自动创建存放快照与记忆键值所需的系统数据表。 - FastAPI 异步生产服务请统一用异步版
AsyncPostgresSaver与AsyncPostgresStore,避免同步数据库驱动阻塞整个异步事件循环。
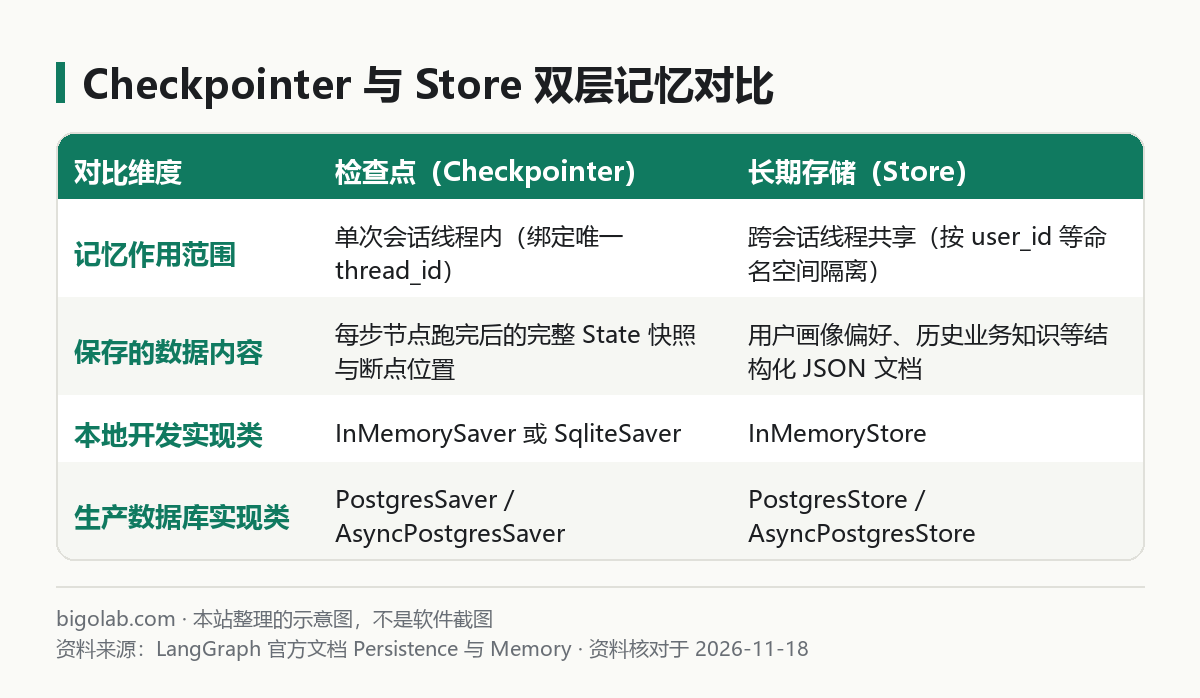
图:本站根据 LangGraph 官方文档 Persistence 与 Memory 整理的示意图
本文根据 LangChain / LangGraph 官方文档《Persistence》《Memory》与langgraph-checkpoint-postgres仓库文档整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 LangChain 官方网站。
适用于谁
- 搜「langgraph postgres checkpointer」「langgraph 长期记忆 store」「langgraph 持久化」的后端开发者;
- 在入门示例(见 /guides/langgraph-quickstart-install-first-graph)里用通了内存保存器,准备把服务搬上多实例生产容器、解决重启丢记录问题的人;
- 发现用户开一个新对话窗口(换了新
thread_id)后,智能体就把该用户的老习惯全忘了,想知道怎么跨会话共享用户画像的人。
一、先彻底分清:什么时候查 Checkpointer、什么时候读写 Store
很多人在做聊天应用时只配了 checkpointer,上线后马上遇到一个典型尴尬:用户小张昨天在「会话 A」里交代过「我是素食主义者、报告一律用表格展示」;今天小张点左上角「新建对话」开启了「会话 B」(分配了全新的 thread_id),智能体瞬间把这两条偏好忘得一干二净。
原因就在于两层存储的键维度完全不同:
- Checkpointer(按
thread_id隔离):保存的是每一次节点跳转后的完整State快照。它的本职工作是支撑多轮追问、人工审批挂起恢复(见 /guides/langgraph-human-in-the-loop-interrupt-guide)与断点时间旅行。不同thread_id之间互不可见; - Store(按自定义命名空间如
("memories", user_id)组织):它是一个独立于具体线程之外的跨会话文档库(还可选配向量语义检索)。无论小张新建多少个聊天窗口,只要节点按他的user_id去store里查,就能读出他之前沉淀下来的个人档案。
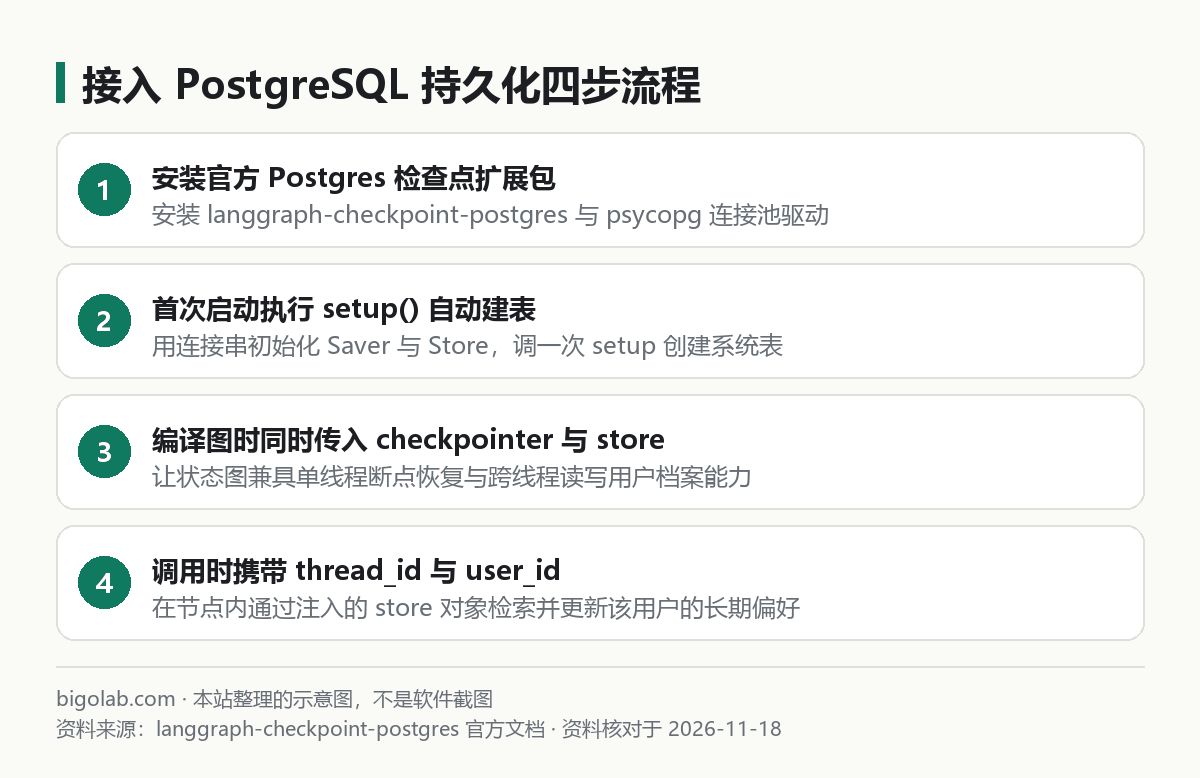
图:本站根据 langgraph-checkpoint-postgres 官方文档 整理的示意图
二、安装依赖与连接 PostgreSQL 双层存储示例
如果你只是在单机写桌面小工具,装 langgraph-checkpoint-sqlite 落盘成单个本地文件就够用;如果是多实例后端服务,直接安装官方的 PostgreSQL 包与底层 psycopg(v3)驱动:
bash
pip install -U langgraph langgraph-checkpoint-postgres "psycopg[binary,pool]"
下面的异步代码展示了如何同时启用 AsyncPostgresSaver 和 AsyncPostgresStore,并在节点函数里通过类型注解自动拿到 BaseStore 实例读写跨会话记忆:
python
import asyncio
import uuid
from langchain_core.runnables import RunnableConfig
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver
from langgraph.store.postgres.aio import AsyncPostgresStore
from langgraph.store.base import BaseStore

DB_URI = "postgresql://postgres:[email protected]:5432/agent_db"

async def chat_node(state: MessagesState, config: RunnableConfig, *, store: BaseStore):
    user_id = config["configurable"]["user_id"]
    namespace = ("user_profiles", user_id)

    # 1. 跨线程读取该用户过往保存的所有长期偏好
    saved_items = await store.asearch(namespace)
    prefs = [item.value.get("note", "") for item in saved_items]

    last_text = state["messages"][-1].content
    # 2. 若用户本轮明确交代记住某事,写入跨会话 Store
    if "请记住:" in last_text:
        await store.aput(namespace, str(uuid.uuid4()), {"note": last_text})

    summary = ";".join(prefs) if prefs else "暂无历史偏好"
    reply = f"已读取您的跨会话档案({summary}),收到本轮消息:{last_text}"
    return {"messages": [("assistant", reply)]}

async def main():
    async with (
        AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer,
        AsyncPostgresStore.from_conn_string(DB_URI) as store,
    ):
        # 首次连接空库时执行建表迁移(幂等操作)
        await checkpointer.setup()
        await store.setup()

        builder = StateGraph(MessagesState)
        builder.add_node("chat", chat_node)
        builder.add_edge(START, "chat")
        builder.add_edge("chat", END)

        graph = builder.compile(checkpointer=checkpointer, store=store)

        # 会话 1:写入一条长期偏好
        cfg_thread_1 = {"configurable": {"thread_id": "t-001", "user_id": "u_zhang"}}
        await graph.ainvoke({"messages": [("user", "请记住:报表统一用周度口径")]}, cfg_thread_1)

        # 会话 2:换了全新的 thread_id,依然能从 store 读出刚才存下的偏好
        cfg_thread_2 = {"configurable": {"thread_id": "t-002", "user_id": "u_zhang"}}
        out = await graph.ainvoke({"messages": [("user", "帮我生成本周汇总")]}, cfg_thread_2)
        print(out["messages"][-1].content)

if __name__ == "__main__":
    asyncio.run(main())
三、生产环境连接池与 CLI 部署避坑提醒
- 手动建连接池必配两个参数:
from_conn_string适合快速测试;在长生命周期的 FastAPI 应用生命周期(lifespan)里自建AsyncConnectionPool时,官方文档特别强调必须在连接参数里打开autocommit=True和row_factory=dict_row,否则.setup()建表事务不提交或读取行字段时报键错误; - 与
langgraph.json托管模式区分开:如果你是用官方 CLI 服务启动(配置见 /guides/langgraph-json-config-guide),服务端框架会自动接管底层的checkpointer与store注入,节点函数里照常声明*, store: BaseStore即可直接用,不需要在compile()时手工传连接串; - 控制检查点表体积膨胀:高频工具循环每走一步都会写一行快照,对已经完结超过几十天的陈旧临时会话,建议定期按
thread_id清理归档。日常用大模型辅助编写数据库清理脚本或排查连接池异常时,个人官方订阅说明也可参考 /chongzhi/chatgpt-plus。
常见问题
Q:Store 支持按自然语言语义搜索几百条历史记忆吗?
支持。在初始化 PostgresStore(或 InMemoryStore)时传入 index={"embed": 嵌入模型, "dims": 向量维度} 并确保 PostgreSQL 开启了 pgvector 扩展后,store.asearch(namespace, query="饮食习惯") 就会自动执行向量相似度检索,只召回最相关的几条记忆省下上下文。
Q:报 psycopg.OperationalError 连不上本地数据库怎么查?
先确认连接串里的端口、库名是否已提前手动 CREATE DATABASE agent_db;(.setup() 只负责在已有库内建表,不会替你新建数据库本身),并核对密码含特殊符号时是否做了 URL 编码。
相关教程
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安装与基础
InMemorySaver用法 - /guides/langgraph-human-in-the-loop-interrupt-guide:依赖 Checkpointer 实现人工审批挂起与恢复
- /guides/langgraph-pricing-open-source-vs-platform:自建开源 PostgreSQL 持久化与商业平台对比
- /guides/langgraph-json-config-guide:
langgraph.json服务端配置详解
参考资料
- LangChain / LangGraph 官方文档:Persistence & Memory Store — https://docs.langchain.com/
langchain-ai/langgraph官方 GitHub 仓库 — https://github.com/langchain-ai/langgraph
0 条评论
还没有评论,来抢沙发~