
结论先说
- 想半小时搭出「中心主管 + 几个专职代理」的原型,装官方扩展包
langgraph-supervisor,调用create_supervisor即可自动生成调度边。 - 上正式生产环境,更推荐用原生「隔离子图(Subgraph)」写法:把每个专家团队编译成拥有独立私有
State的子图,父图通过一个薄包装函数调用它,只传精简指令、只拿回最终结论。 - 检查点保存器(Checkpointer)千万别在父图和子图里重复传:只需在最外层父图
parent.compile(checkpointer=...)传一次,LangGraph 会自动向下传播持久化能力。 - 想看清嵌套子图内部长什么样,导出流程图时加上
xray=True参数就能一键把黑盒展开。
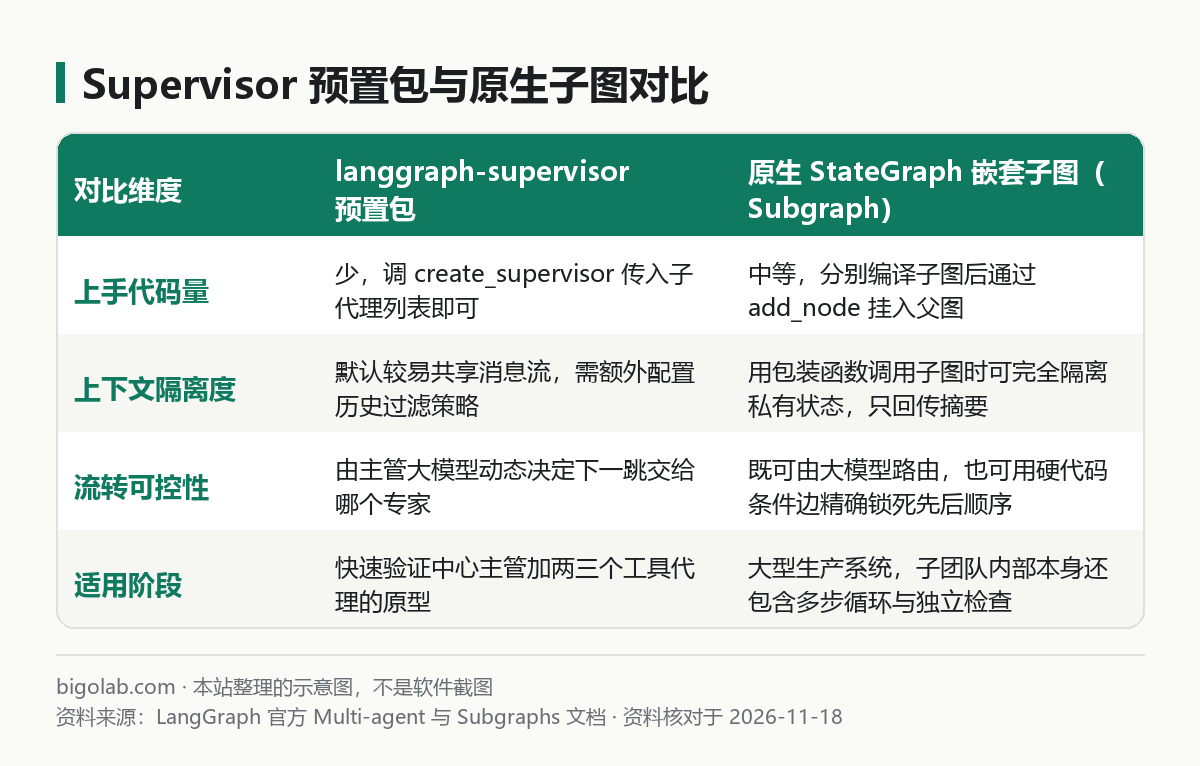
图:本站根据 LangGraph 官方 Multi-agent 与 Subgraphs 文档 整理的示意图
本文根据 LangChain / LangGraph 官方文档《Multi-agent systems》《Subgraphs》与langgraph-supervisor-py官方仓库整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 LangChain 官方网站。
适用于谁
- 搜「langgraph 多智能体」「langgraph supervisor 怎么用」「langgraph subgraph 子图」的开发者;
- 已经写顺了单个
StateGraph(基础见 /guides/langgraph-quickstart-install-first-graph),准备把臃肿的二十个工具拆给「检索专家」「分析专家」等多个角色协同的工程师; - 把所有子代理全塞进同一个
MessagesState后,发现前一个代理的几十条查库报错把后一个代理彻底绕晕的人。
一、路线一:用 langgraph-supervisor 快速搭中心主管模式
如果你的业务正好是标准的「编排者-工作者」拓扑(原理见 /guides/multi-agent-orchestration-patterns),不想自己手写主管的路由工具,可以直接安装官方维护的预置包:
bash
pip install -U langgraph langgraph-supervisor langchain-openai
只需先把底下的专职工作者建好(记得给每个工作者起清晰的英文 name),再交给 create_supervisor 汇总编译:
python
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent
from langgraph_supervisor import create_supervisor

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# 定义两个职责分明的底层工作者
sql_worker = create_react_agent(
    model=model,
    tools=[],  # 此处挂载只读数据库查询工具
    name="sql_expert",
    prompt="你只负责查询订单与库存统计数字,如实返回数据结果。",
)

doc_worker = create_react_agent(
    model=model,
    tools=[],  # 此处挂载内部退换货规则检索工具
    name="policy_expert",
    prompt="你只负责核对公司售后条款细则,给出明确条款依据。",
)

# 组装中心主管工作流
workflow = create_supervisor(
    [sql_worker, doc_worker],
    model=ChatOpenAI(model="gpt-4o", temperature=0),
    prompt="你是客服主管,先视需求调度 sql_expert 与 policy_expert 收集事实,最后统一作答。",
)

app = workflow.compile()
注意主管模式的一个调优参数:默认情况下如果把子代理内部的中间工具调用全摊进主对话流,Token 消耗会涨得很快(原因见 /guides/multi-agent-token-cost-why-high-how-to-control),建议检查 output_mode 参数只向主管保留子代理的最后一条总结消息。
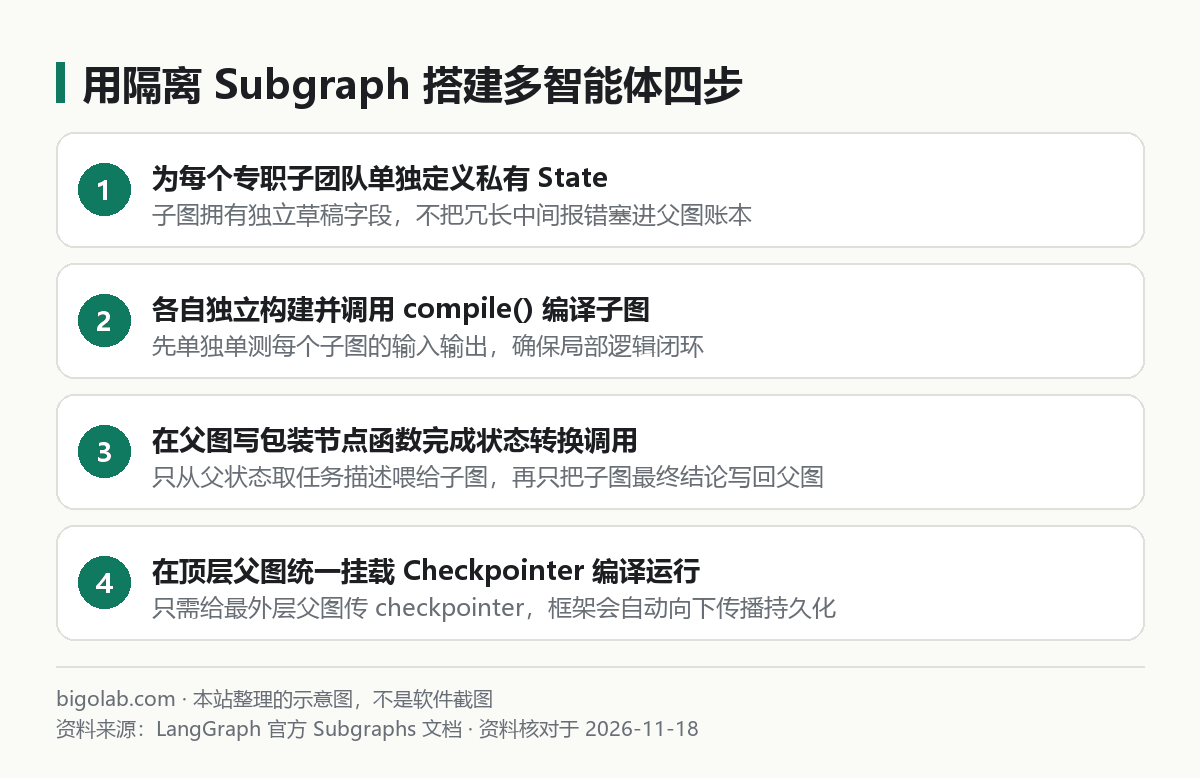
图:本站根据 LangGraph 官方 Subgraphs 文档 整理的示意图
二、路线二:用原生 Subgraph(子图)实现彻底的上下文隔离
当某个专家角色内部本身就需要走三四个固定步骤(比如「生成 SQL → 校验语法 → 跑查询 → 脱敏汇总」),并且你希望它内部的 raw_rows、retry_count 等脏草稿绝不污染顶层父图的共享账本时,原生子图是上限最高的写法。
官方文档给出了两种挂载子图的方式:
- 共享键名直接挂载:父子
State包含同名字段时,直接parent.add_node("team_a", compiled_sub); - 包装函数转换状态(强烈推荐):父子
State完全独立,在父图节点函数里手动调用compiled_sub.invoke(...),做好输入输出的「上下文防火墙」。
下面是一个完整的「私有状态子图」代码骨架:
python
from typing import TypedDict
from langgraph.graph import StateGraph, START, END

# 1. 子图拥有完全私有的内部状态字段(父图看不见 scratchpad)
class AuditSubState(TypedDict):
    target_text: str
    scratchpad: str
    verdict: str

def scan_risk_node(state: AuditSubState):
    # 模拟子团队内部多步分析,中间草稿留在 scratchpad
    found = "含外部未核实链接" if "http" in state["target_text"] else "无异常"
    return {"scratchpad": f"内部扫描日志: {found}", "verdict": found}

sub_builder = StateGraph(AuditSubState)
sub_builder.add_node("scan", scan_risk_node)
sub_builder.add_edge(START, "scan")
sub_builder.add_edge("scan", END)
# 注意:子图直接无参 compile(),不要单独传 checkpointer
audit_subgraph = sub_builder.compile()

# 2. 顶层父图状态干净清爽,只存业务主干数据
class MainState(TypedDict):
    draft_article: str
    audit_summary: str

# 3. 用包装函数连接父图与子图,实现精确的输入输出裁剪
def call_audit_team(state: MainState):
    sub_out = audit_subgraph.invoke({
        "target_text": state["draft_article"],
        "scratchpad": "",
        "verdict": "",
    })
    # 只把精简结论带回父图,丢弃子图内部的冗长 scratchpad
    return {"audit_summary": sub_out["verdict"]}

parent_builder = StateGraph(MainState)
parent_builder.add_node("audit_team", call_audit_team)
parent_builder.add_edge(START, "audit_team")
parent_builder.add_edge("audit_team", END)

main_graph = parent_builder.compile()
三、子图调试与持久化注意事项
- 展开查看嵌套连线:调用
main_graph.get_graph(xray=True).draw_mermaid()时,如果子图是直接挂入节点的,Mermaid 图会把子图内部拓扑一并展开(可视化与 Studio 调试方法见 /guides/langgraph-debug-visualize-studio-guide); - 子图内同样支持
interrupt()人工审批:只要顶层父图编译时挂载了checkpointer,子图深处触发的断点也能被外层正常捕获并用同一个thread_id恢复;除非你明确需要某个子图维护脱离父会话的独立记忆,否则不要给子图设checkpointer=True。
平时研发阶段借助前沿大模型快速拆分父子状态 Schema 与编写单测用例时,个人官方订阅参考信息可见 /chongzhi/chatgpt-plus。
常见问题
Q:包装函数里调子图时,怎么让外层的流式输出也能实时看到子图内部的进度?
在父图的 stream 或 astream 调用里传入 subgraphs=True 参数(例如 main_graph.stream(inputs, subgraphs=True)),流事件就会带上命名空间前缀把子图内部每一步的变化一并吐出来。
Q:一张父图底下最多适合挂多少个子图?
工程上单层主管直接调度的子代理或子图建议控制在 3 到 6 个以内;如果业务模块超过十个,建议先在入口用确定性分类节点分流到对应二级主管,避免单个主管在十几个相似角色描述之间摇摆选错。
Q:两个平级子图之间可以直接用 Command(goto=...) 互相跳转做交接吗?
可以。新版 LangGraph 支持在子图节点返回 Command(goto="另一个节点名", graph=Command.PARENT),不需要中心主管居中传话就能把执行控制权直接移交给父图里的下一个平级专家节点,适合多阶段顺序或按需转办流程。
相关教程
- /guides/langgraph-quickstart-install-first-graph:LangGraph Python 安装与第一个状态图
- /guides/multi-agent-orchestration-patterns:编排者-工作者与去中心化交接原理
- /guides/multi-agent-token-cost-why-high-how-to-control:为什么隔离上下文能大幅压低多代理成本
- /guides/langgraph-debug-visualize-studio-guide:用
xray=True与 Studio 调试复杂状态图
参考资料
- LangChain / LangGraph 官方文档:Subgraphs & Multi-agent — https://docs.langchain.com/
langchain-ai/langgraph-supervisor-py官方仓库 — https://github.com/langchain-ai/langgraph-supervisor-py
0 条评论
还没有评论,来抢沙发~