
结论先说
- 多 Agent 费额度不是错觉,而是架构决定的:Anthropic 工程团队公开披露,普通单智能体消耗的 Token 约为单轮聊天的 4 倍,而多智能体协同系统可放大到普通聊天的约 15 倍。
- 账单翻倍的四个最大黑洞:每个子代理重复加载全套系统规则与 MCP 工具表、把整段聊天历史原样拷给下游、子代理默认继承昂贵旗舰模型、动态拼装提示词打断了提示词缓存(Prompt Caching)。
- 最立竿见影的两招是「上下文防火墙」和「主强从轻」:子代理只接收精简任务单、只回传几百字摘要,且把搜索、跑单测、提字段的工作节点显式降到轻量模型(如 Haiku 或低推理档模型)。
- 按角色裁剪工具列表能省掉大量隐形底座消耗:不要让每个微型子代理都挂着几十个用不上的 MCP 工具定义。
- 所有无人值守多代理循环必须设硬上限(如最大轮数
max_turns与单次预算上限),防止两个代理意见不一致陷入死循环。
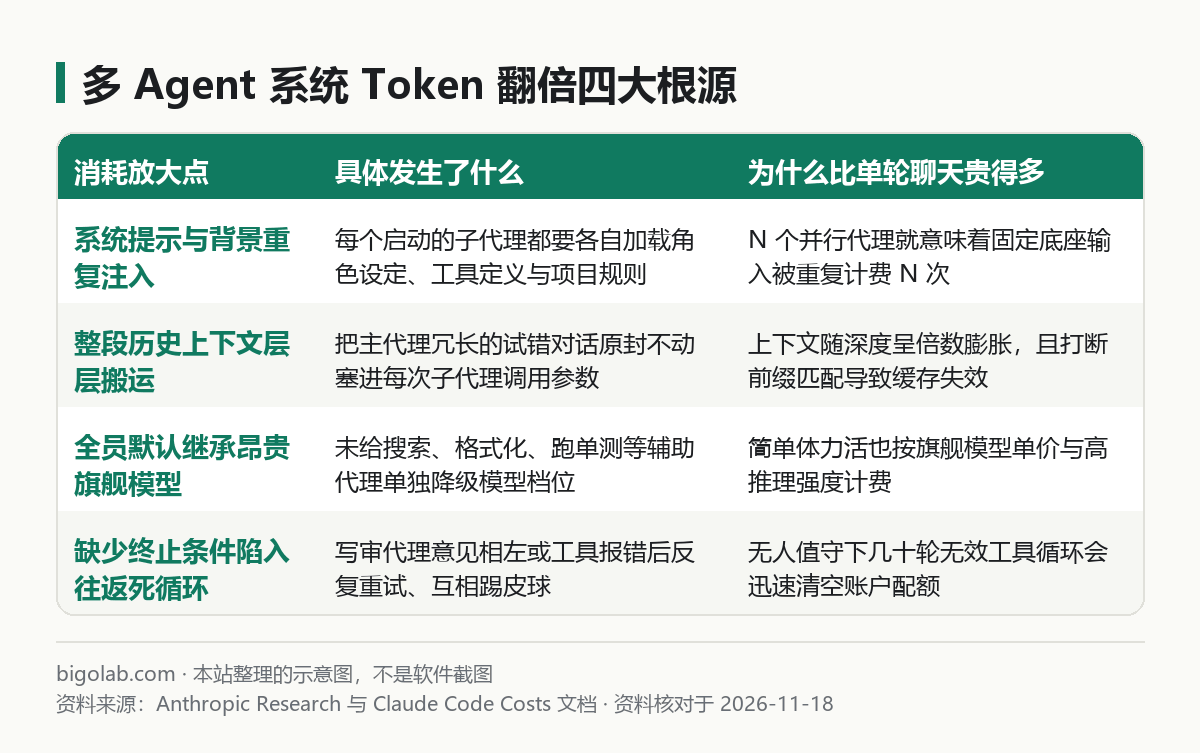
图:本站根据 Anthropic Research 与 Claude Code Costs 文档 整理的示意图
本文根据 Anthropic《How we built our multi-agent research system》、Claude Code 官方《Manage costs effectively》以及 OpenAI 提示词缓存文档整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方网站。
适用于谁
- 搜「多 agent 成本怎么控」「为什么多智能体这么费 token」的人;
- 在 Claude Code、Codex 里开子代理或智能体团队,发现半天就触及订阅滚动限额的开发者;
- 用 Agent SDK 搭建多代理后台服务,上线前想算清账单放大系数并加上熔断保护的团队。
一、算一笔明白账:Token 到底是怎么翻倍的
很多人以为「把 1 万字的工作拆给 3 个代理做,总量不还是 1 万字吗?」。实际上大模型的计费是按每一轮请求携带的完整输入上下文累加的,多代理会在四个地方产生乘法效应:
1. 底座提示词与工具表被重复收了 N 份
每当你唤醒一个独立的子代理或队友会话,它都要重新装载自己的系统提示词、项目指令文件(如 CLAUDE.md),以及当前启用的所有工具 JSON Schema。如果你挂了五六个重型 MCP 服务器,光工具定义就可能占掉上万 Token——并发派 4 个代理,这上万底座 Token 就先乘以 4。
2. 多轮工具循环里的「滚雪球」计费
一个子代理在内部查代码时往往要连调 6 到 8 次工具。第 1 轮发 5 千 Token,第 2 轮要带着第 1 轮的结果发 8 千 Token……8 轮跑下来累计输入轻松突破五六万。如果主编排器还犯了大忌——把主对话攒了几万字的聊天记录全量塞给每个子代理,消耗就会呈指数级失控。
3. 子代理静默继承了最贵的旗舰模型
无论在编码终端还是自建 SDK 里,如果不显式指定子代理模型,很多工具默认都是跟随主会话(inherit)。你主会话开着顶级旗舰模型做架构规划,顺手派三个子代理去翻日志、查拼写,相当于用最贵的算力干最简单的检索体力活。
4. 频繁拼接动态变量导致提示词缓存失效
Anthropic 和 OpenAI 的提示词缓存都依赖「从头开始的精确前缀匹配」。如果代码在系统提示词最开头塞了动态时间戳、随机会话 ID,或者每轮频繁更换模型,就会导致昂贵的长前缀无法命中缓存折扣,每次都按全价重新计算。
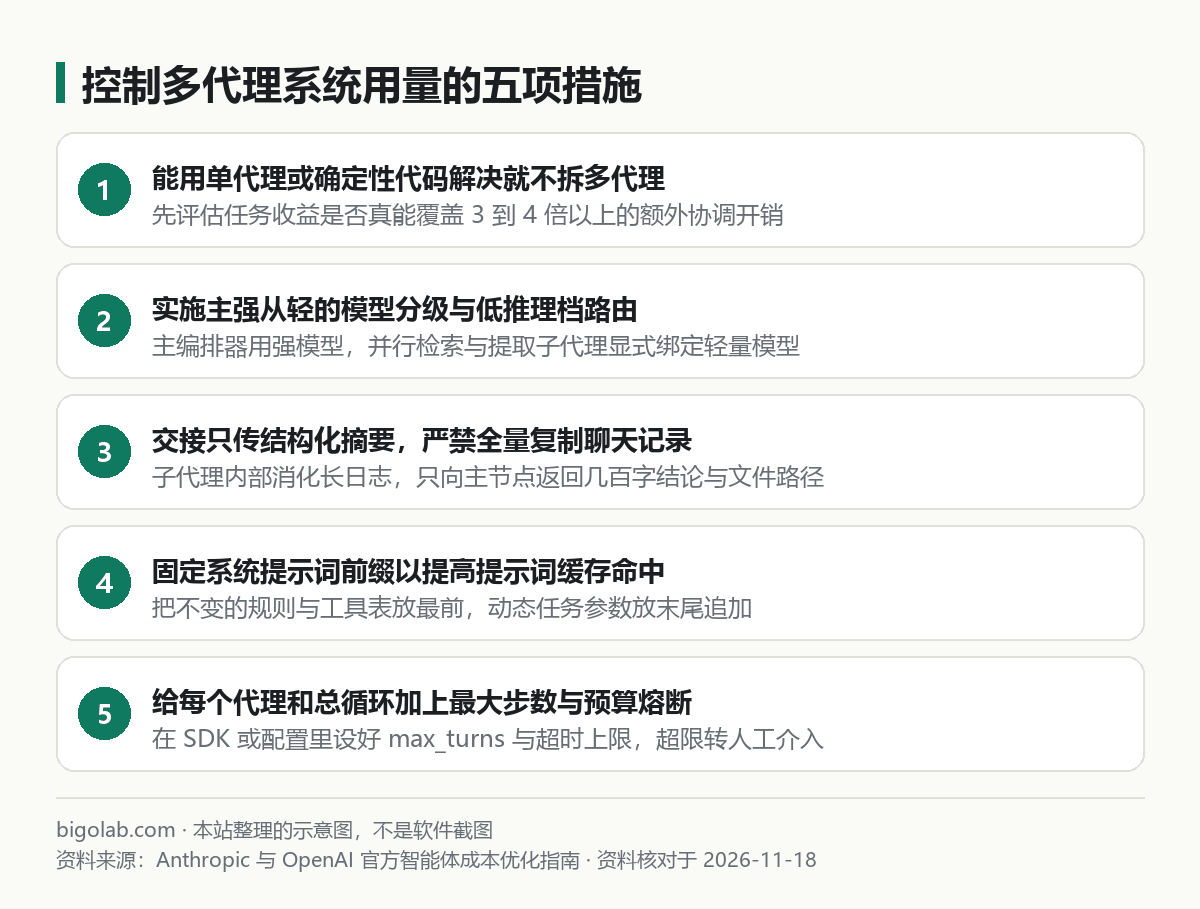
图:本站根据 Anthropic 与 OpenAI 官方智能体成本优化指南 整理的示意图
二、五项实操控费措施
措施一:守住拆分门槛,不该拆的坚决不拆
先对照 /guides/multi-agent-what-is-when-to-use 自检:如果固定脚本加一两次单模型调用就能稳定跑通,直接砍掉多余的协调代理,这是降本幅度最大的一步。
措施二:严格执行「主强从轻」的模型分级
把模型档位按角色锁死:只有中心编排器和最终疑难仲裁用高阶模型;所有负责翻文档、搜目录、跑测试、转格式的子代理,一律显式绑定轻量模型或调低推理强度。Claude Code 里的具体配法见 /guides/claude-code-multi-model-opusplan-advisor-subagents,OpenAI 体系分级策略见 /guides/openai-multi-model-routing-cheap-vs-strong。
措施三:建立「上下文防火墙」,只传任务单与浓缩摘要
把子代理当成「上下文过滤器」来用,而不是传声筒:
- 往下派活时:只传本次子任务必需的目标路径、约束条件和验收格式,不传无关闲聊历史;
- 往上汇报时:在子代理提示词里硬性规定「严禁原样粘贴整段命令输出或大段源码,只返回不超过 300 字的结论与精确文件路径行号」;
- 阶段边界主动压缩:主会话完成一大块里程碑后,及时用
/compact清理历史包袱(用法见 /guides/claude-code-context-compact)。
措施四:按代理角色最小化开放工具白名单
在定义子代理时(例如 .claude/agents/*.md 的 tools 字段或 SDK 的 Agent(tools=[...])),只给该角色真正用得到的那两三个工具。一个只读代码检查员只需要 Read、Grep、Glob,没必要把浏览器自动化、数据库和设计稿 MCP 全挂载进去白占上下文。
措施五:保护缓存前缀,并加上轮数与预算熔断
- 固定前缀顺序:自研智能体时,把固定不变的角色规范、工具定义放在最前面,每次变化的当前任务参数放在最末尾,最大化命中提示词缓存;
- 加硬熔断开关:跑非交互命令或 SDK 循环时,务必设置最大轮数(如 Claude Code CLI 的
--max-turns、以及 API 模式下支持的--max-budget-usd预算上限参数),一旦异常卡死立即停机告警。
对于长期重度使用多代理并行研发、订阅配额经常不够用的开发者,除了做好上述五项节流配置,也可以在 /chongzhi/claude-max 对比高倍率订阅方案与按量 API 计费哪一种更契合自己的月度节奏。
常见问题
Q:在 Claude Code 里怎么看当前会话到底花了多少 Token?
按 API 计费登录时,在会话里输入 /cost 可以查看当前会话累计消耗与按模型拆分的明细;使用 Pro 或 Max 订阅登录时,输入 /status 或在官方设置用量页查看当前滚动窗口与周限额占用比例。
Q:为什么有时候拆成子代理反而比单会话更省主窗口额度?
当某个子任务需要翻阅几十页测试报错日志时,如果放在主会话里做,这几十页日志会一直留在主会话历史里,后面你每聊一句都要为这段旧日志重复买单;派一个 haiku 轻量级子代理在独立窗口里看完并丢弃原始日志、只带回三行报错根因,主会话后续几十轮反而轻装上阵。
相关教程
- /guides/multi-agent-what-is-when-to-use:多智能体什么时候值得用、什么时候别硬拆
- /guides/claude-code-multi-model-opusplan-advisor-subagents:Claude Code 子代理绑定轻量模型与多模型分工
- /guides/openai-multi-model-routing-cheap-vs-strong:OpenAI 多模型路由与提示词缓存省钱方案
- /guides/claude-code-context-compact:Claude Code 上下文压缩
/compact详解
参考资料
- Anthropic Engineering:How we built our multi-agent research system — https://www.anthropic.com/engineering/multi-agent-research-system
- Claude Code 官方文档:Manage costs effectively — https://code.claude.com/docs/en/costs
- Claude Code 官方文档:How Claude Code uses prompt caching — https://code.claude.com/docs/en/prompt-caching
- OpenAI API 文档:Prompt caching — https://platform.openai.com/docs/guides/prompt-caching
0 条评论
还没有评论,来抢沙发~