
结论先说
- 多智能体(Multi-Agent)的本质是「拆分上下文窗口与职责边界」:不再让同一个会话把所有搜索、执行、核验硬扛到底,而是让多个拥有独立系统提示词、独立工具集和独立上下文窗口的智能体分工协作。
- 两家官方给出的第一原则完全一致:先从最简单的方案起步。 能用单次调用或固定代码工作流(Workflow)解决的,不要上自主智能体;能用单智能体解决的,不要拆多智能体。
- 真正值得上多智能体的只有三类信号:广度并行调研超出单窗口承载力、工具太多太杂导致单智能体频繁选错工具、复杂条件分支让单份系统提示词互相打架。
- 多智能体是用算力换上限,Token 消耗会大幅增加:Anthropic 工程团队公开统计,单智能体消耗约为普通聊天的 4 倍,而多智能体系统可达到普通聊天的约 15 倍。
- 强耦合读写同一份状态的任务不适合拆多智能体——比如多个人同时改同一个代码文件,拆分后的协调冲突往往大于并行收益。
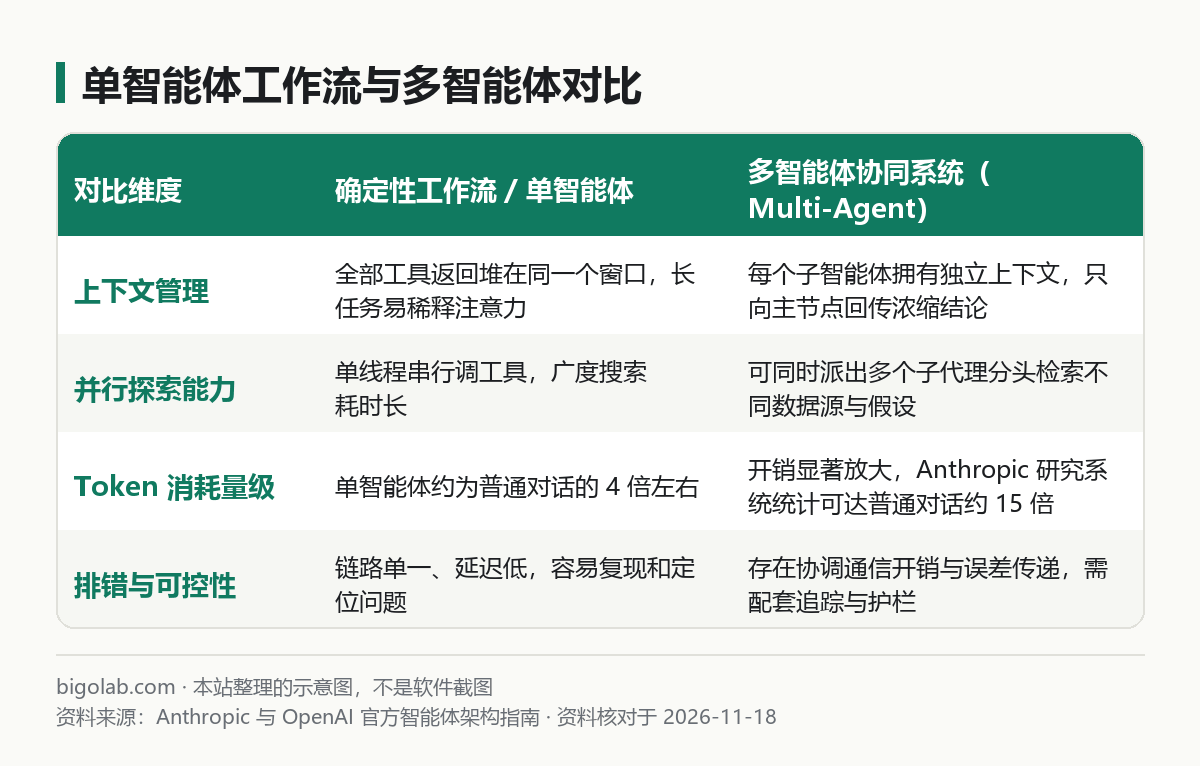
图:本站根据 Anthropic 与 OpenAI 官方智能体架构指南 整理的示意图
本文根据 Anthropic 官方工程文章《How we built our multi-agent research system》《Building effective agents》与 OpenAI 官方指南《A practical guide to building agents》整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方网站。
适用于谁
- 搜「多智能体协同框架」「多智能体是什么」「什么时候需要 multi-agent」的人;
- 准备搭建 AI 应用或自动化工作流,纠结「一个大模型配十几个工具」还是「拆成三四个专职 Agent 协作」的开发者与产品经理;
- 跟风搭了多代理流水线,结果发现响应慢、报错难排查、Token 账单翻了好几倍的人。
一、先分清三个层次:工作流、单智能体、多智能体
很多团队一上来就找「多智能体协同框架」,其实把三个不同复杂度的概念混在了一起。按 Anthropic 在《Building effective agents》里的界定:
- 确定性工作流(Workflows):大模型和工具按开发者事先写好的代码路径一步步走(例如先提纲、再分段生成、最后格式校验)。链路固定、最稳、最省钱;
- 单智能体(Single Agent):一个模型在循环里自己决定下一步调哪个工具、根据环境反馈自己修正,直到完成目标;
- 多智能体系统(Multi-Agent System):把工作拆给多个独立运行的智能体实例,通过「中心主管调度」或「对等交接」配合完成单窗口装不下的大任务。
OpenAI 在《A practical guide to building agents》里同样建议:绝大多数业务场景应该先把单个智能体跑通并压榨到极限(通过加工具、优化指令),只有撞上明显瓶颈时再拆分。
二、什么时候才真正该用多智能体
综合 Anthropic 和 OpenAI 两份指南,出现下面三个具体痛点之一时,升级多智能体才有正向收益:
1. 需要广度优先的并行探索与「上下文压缩」
这是 Anthropic 构建 Claude Research 多智能体系统的核心原因。面对开放式深度调研,事先根本不知道答案藏在哪几个方向;如果让单个智能体串行搜几十个网页,前面塞进来的海量无关正文会迅速污染上下文,导致模型遗忘最初目标。
换成主从多智能体后,主节点(例如 Opus)负责拆解调查方向,同时派出多个子智能体(例如 Sonnet)在各自干净的上下文窗口里翻资料,最后每个子智能体只把几百字的提炼结论递回主节点。在这类重度并行压缩信息噪声的场景下,Anthropic 内部评测显示多智能体显著优于单智能体。
2. 工具数量膨胀且参数相似,单智能体频繁调错
OpenAI 官方指南给出了一个非常实用的拆分阈值:当你往同一个智能体里塞了十几个甚至几十个工具,尤其是存在多个名称相近、参数重叠的工具(比如同时挂了五套不同业务线的查询接口)时,单靠改写提示词已经很难阻止模型调错。把工具按业务域拆给不同的专职智能体,每个智能体只看自己那三五个工具,准确率会稳得多。
3. 指令逻辑里充满复杂的 if-else 分支与角色切换
如果一份系统提示词既要求模型「热情引导售前咨询」,又要求「严格核验退费风控条款」,还要求「生成排查脚本」,篇幅超过上千字且语气规则互相牵制,拆成独立节点按阶段交接会清晰很多。
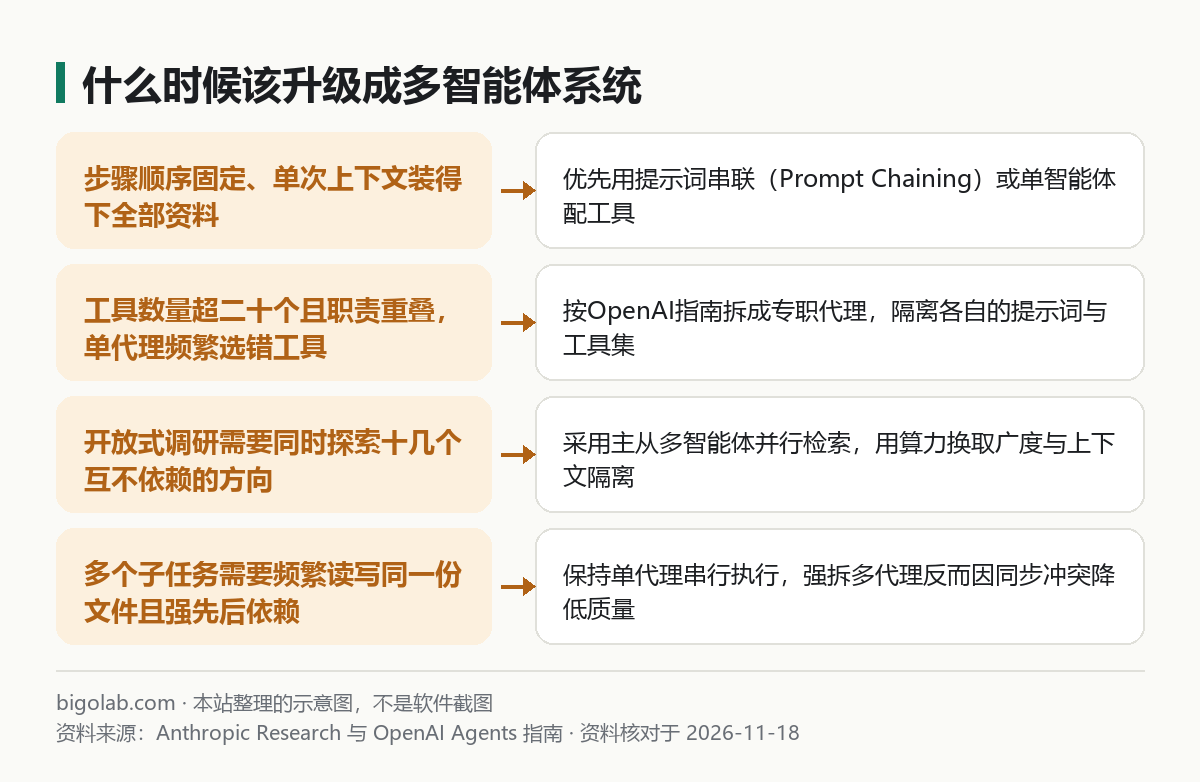
图:本站根据 Anthropic Research 与 OpenAI Agents 指南 整理的示意图
三、哪些场景千万别硬拆多智能体
Anthropic 团队在复盘多智能体研发踩坑时专门指出了典型的反面场景:子任务之间存在紧密共享状态和强先后依赖——最具代表性的就是常规写代码。
如果让三个没有共享实时上下文的子智能体分头改同一个模块的不同部分,它们各自的假设很容易对不上,最后拼在一起到处是接口不匹配和合并冲突。因此在编码工具里(如 Claude Code 子代理或 Codex 子代理,见 /guides/claude-code-subagents 与 /guides/codex-multi-agent-subagents-guide),稳妥的拆法都是「并行只读探索与独立验证、串行集中改写」,而不是让一群代理同时改同一份源码。
四、动手搭建前的两项基础准备
确定业务真的需要多智能体后,落地前先定好两件事:
- 选对官方 SDK 原语:偏代码与终端工具链自主循环可看 /guides/claude-agent-sdk-quickstart;偏客服分流、主管调度与护栏追踪可看 /guides/openai-agents-sdk-handoffs-vs-agents-as-tools;
- 先算清楚额度账:多智能体每次并发都会成倍消耗配额。无论是在本地跑编码多代理还是调试重度研究工作流,高频使用者如果遇到基础套餐限额瓶颈,可对照 /chongzhi/claude-max 或 /chongzhi/chatgpt-pro 提前了解高额度套餐与 API 计费的差异。
常见问题
Q:提示词写两个角色「让模型自己在一条回复里扮演甲和乙吵架」,算多智能体吗?
不算。那只是单次上下文里的角色扮演提示词技巧,既没有隔离上下文窗口,也没有分拆工具集或实现真正并发,解决不了长上下文污染和工具过多的问题。
Q:多智能体一定每个节点都得用最强模型吗?
不需要,官方推荐「主强从轻」:负责拆解全局方案与最终汇总的主节点用强推理模型,负责分头检索、提取字段的工作节点用高性价比主力或轻量模型。
Q:初学者应该直接学重型多智能体框架,还是先写原生调用?
Anthropic 在指南里明确建议先直接调基础接口或轻量 SDK 把最小闭环跑通,看清提示词与工具交互的真实报文;等确认需要复杂持久化图状态或可视化编排时,再引入专门的编排框架,排错成本最低。
相关教程
- /guides/claude-agent-sdk-quickstart:Claude Agent SDK 入门与第一个智能体
- /guides/openai-agents-sdk-handoffs-vs-agents-as-tools:OpenAI Agents SDK 多代理分工实战
- /guides/claude-code-subagents:Claude Code 子代理创建与使用
- /guides/codex-multi-agent-subagents-guide:Codex 多 Agent 与子代理配置详解
参考资料
- Anthropic Engineering:How we built our multi-agent research system — https://www.anthropic.com/engineering/multi-agent-research-system
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI:A practical guide to building agents — https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
0 条评论
还没有评论,来抢沙发~