
结论先说
- 当前版本的 Codex 默认已开启多代理(Subagents)功能(
agents.enabled默认为true),支持同时拉起多个专职子代理并行干活,再由主线程汇总结果。 - 核心价值是防「上下文污染(Context pollution)」:把翻代码、跑单测、读长堆栈这类吵闹的中间过程剥离到子线程,只把精炼结论传回主对话。
- 内置三种角色:
explorer(偏只读搜索)、worker(偏动手实现与修复)、default(通用兜底);还可在~/.codex/agents/或项目.codex/agents/下写独立.toml文件定义专属角色。 - 怎么触发与查看:在提示词里直接写明并行拆分要求(或开启 Ultra 推理档让系统主动委派);CLI 里输
/subagents随时查看和切换活动线程。 - 沙箱与审批严格继承父会话:自定义子代理可以单独换模型或关掉 Shell 工具,但不能绕开父会话当前的沙箱和审批策略。
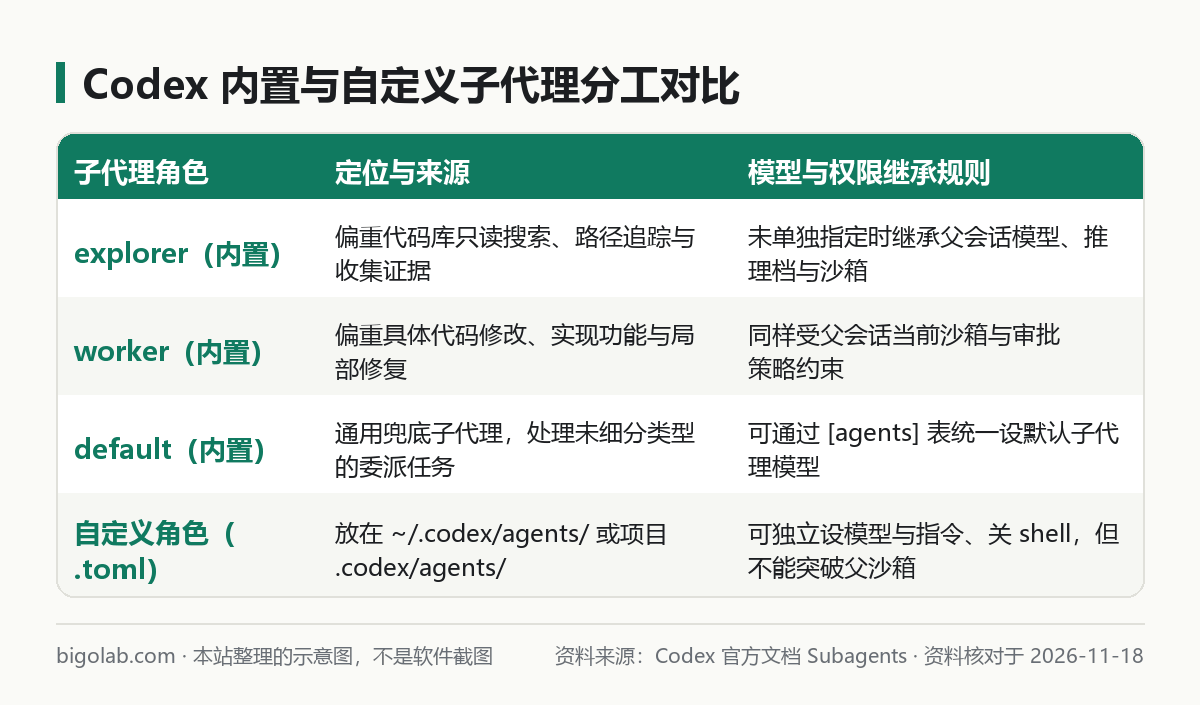
图:本站根据 Codex 官方文档:Subagents 整理的示意图
本文根据 Codex 官方文档《Subagents》《Sample Configuration》《Slash commands in Codex CLI》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。Claude Code 的同类机制可对比 Claude Code Subagents(子代理)怎么用。
适用于谁
- 在大仓库里让单个会话既搜代码、又看几千行测试日志、又改逻辑,结果聊到后面主线上下文越来越糊涂的人;
- 想让 Codex 同时派出三个子代理分别查安全漏洞、缺测分支和可维护性,最后汇总成一份报告的人;
- 想给扫描探索子代理单独配便宜快速的
gpt-6-luna,而主代理保持强模型的开发者。
一、怎么触发子代理并行工作、在哪看进度
官方文档建议:读多写少的任务(如代码库探索、PR 多维度审查、故障分流、长文档分块摘要)最适合上并行子代理;而多个代理同时改同一批文件的「写密集」任务容易产生代码冲突,要谨慎拆分。
触发方式有两种:
- 常规档位显式点名:直接在提示词(或仓库
AGENTS.md、技能文件)里交代清楚「拆几个子代理、各自查什么、要不要等齐再汇总」。例如官方推荐的分支审查写法:
text
请用并行子代理审查当前分支:派一个子代理查安全风险,一个查测试缺口,一个查代码可维护性。等三个全部完成后,按类别汇总问题并附上文件路径与行号。- Ultra 档位主动委派:在支持 Ultra 档位的账号与模型上,无需每次手写拆分指令,系统判断并行能明显提速或提质时会自动派发子代理。
运行过程中各端查看入口不同:
- 命令行 CLI:输入
/subagents回车,即可在活动线程选择器里切换查看某个子代理正在干什么;如果某个后台子线程触发了命令审批弹窗,遮罩层会标明来源线程名,按键盘o键就能先打开那个子线程看清上下文再决定放行或拒绝。 - 桌面端与 IDE 扩展:桌面端直接在主对话活动流里点开对应子代理线程;IDE 扩展在输入框上方展开后台代理面板查看状态或停止子代理。
二、配置全局并发上限与自定义 .toml 角色
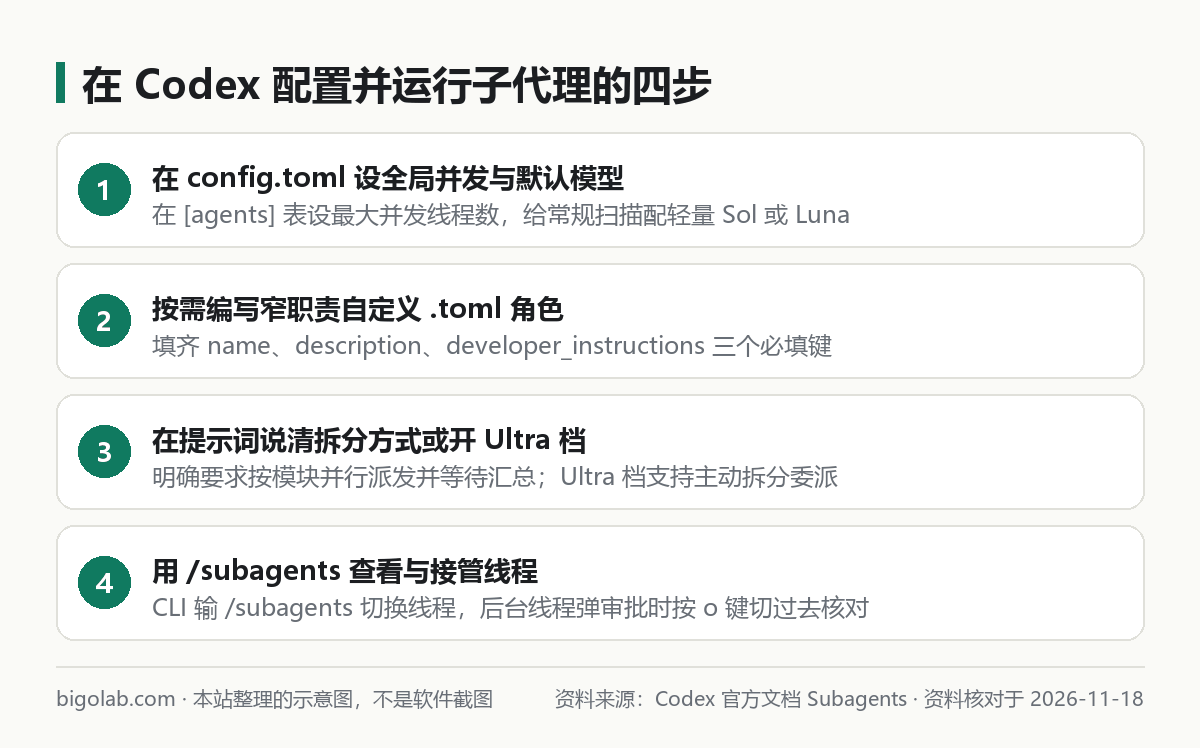
图:本站根据 Codex 官方文档:Subagents 整理的示意图
1. 在 config.toml 的 [agents] 表设全局默认值
不想让所有子代理都跟着父会话用最贵的模型,可以在 ~/.codex/config.toml 或受信任项目的 .codex/config.toml 里配置 [agents] 表(配置优先级见 Codex config.toml 完整详解,模型差异见 Codex 用哪个模型好):
toml
[agents]
enabled = true
max_concurrent_threads_per_session = 6        # 除主线程外的最大并发子线程数
default_subagent_model = "gpt-6.2-sol"        # 子代理默认模型
default_subagent_reasoning_effort = "medium"  # 子代理默认推理强度
2. 在 .codex/agents/ 新建专属角色文件
个人通用角色放 ~/.codex/agents/,项目共享角色放仓库 .codex/agents/。每个 .toml 文件定义一个角色,必填 name、description、developer_instructions 三个字段。例如按官方范例写一个只读搜索员 .codex/agents/pr-explorer.toml:
toml
name = "pr_explorer"
description = "只读代码库探索员,在提出修改方案前负责收集调用链与文件证据。"
model = "gpt-6-luna"
model_reasoning_effort = "high"
developer_instructions = """
保持只读探索模式,不要修改任何文件。
追踪真实执行路径,准确引用文件路径与函数符号;除非父代理明确要求,否则不要自行编写修复代码。
"""

[features]
shell_tool = false
上面这个例子用了两个官方省钱又防乱改的技巧:把高频翻文件的探索员指定为轻量快速的 gpt-6-luna(配 high 推理),同时用 features.shell_tool = false 关掉它的 Shell 执行能力,只让它安心读代码。
三、权限边界与套餐额度消耗说明
- 安全边界不可越权:官方明确规定,写在自定义代理
.toml里的sandbox_mode、approval_policy、model_provider和mcp_servers不会生效,一律严格继承父会话当前的设置(沙箱规则见 Codex 权限与沙箱设置)。想让子代理用某个 MCP 工具,必须在父会话里配好该 MCP 服务。 - 关注并行额度消耗:一次派 4 个子代理出去,就等于同时跑了 4 轮独立的模型推理和工具读取,消耗套餐限额的速度显著高于单代理。如果团队日常大量使用并行子代理或 Ultra 模式,个人升级可看本站 ChatGPT Plus 充值说明 或无 5 小时窗口限制的 ChatGPT Pro 充值说明。
常见问题
问:自定义角色取名叫 explorer,会和内置的 explorer 冲突报错吗?
答:不会报错。官方文档写明,当你的自定义角色 name 与内置角色(如 explorer、worker)重名时,优先采用你定义的版本。
问:在 codex exec 非交互脚本里跑子代理,中途子代理请求人工审批会怎样?
答:非交互环境无法弹出审批框。官方说明凡是需要新人工审批的动作都会直接失败,并把错误返回给父工作流处理;因此在自动化里请提前给父命令设好合适的 --sandbox。
问:归档主会话时,它派生出来的子代理会话记录还在吗?
答:运行 codex archive 或 /delete 处理父会话时,Codex 会一并归档或删除它所派生的子代理会话及其后代记录。
相关教程
参考资料
- Codex 官方文档:Subagents — https://learn.chatgpt.com/docs/agent-configuration/subagents
- Codex 官方文档:Sample Configuration — https://learn.chatgpt.com/docs/config-file/config-sample
- Codex 官方文档:Slash commands in Codex CLI — https://learn.chatgpt.com/docs/reference/slash-commands
0 条评论
还没有评论,来抢沙发~