
结论先说
- 官方能力排序从强到轻依次是:GPT-6.2 Astra、GPT-6.2 Sol、GPT-6.1 Terra、GPT-6 Luna。 在软件工程、数据分析、三维与设计、研究决策等六个官方维度上,排序完全一致。
- 日常写代码优先选
GPT-6.2 Sol(或账号内可用的GPT-6.1 Sol)。 官方将它定位于日常编码、审阅改动与整合多份资料,同等付费套餐下比 Astra 能跑完更多任务。 - 跨服务疑难排错和开放式方案权衡选
GPT-6.2 Astra。 它的推理最深,但单次消耗额度和等待时间也最高。 - 看截图查界面、桌面操作选
GPT-6.1 Terra;提取字段、格式转换等重复小活选GPT-6 Luna。 - 模型要和推理强度配着用。 官方建议拿一个熟悉的代表性任务对比,保留「能达到质量要求的最低档设置」。具体切换步骤见 Codex 怎么切换模型和思考强度。
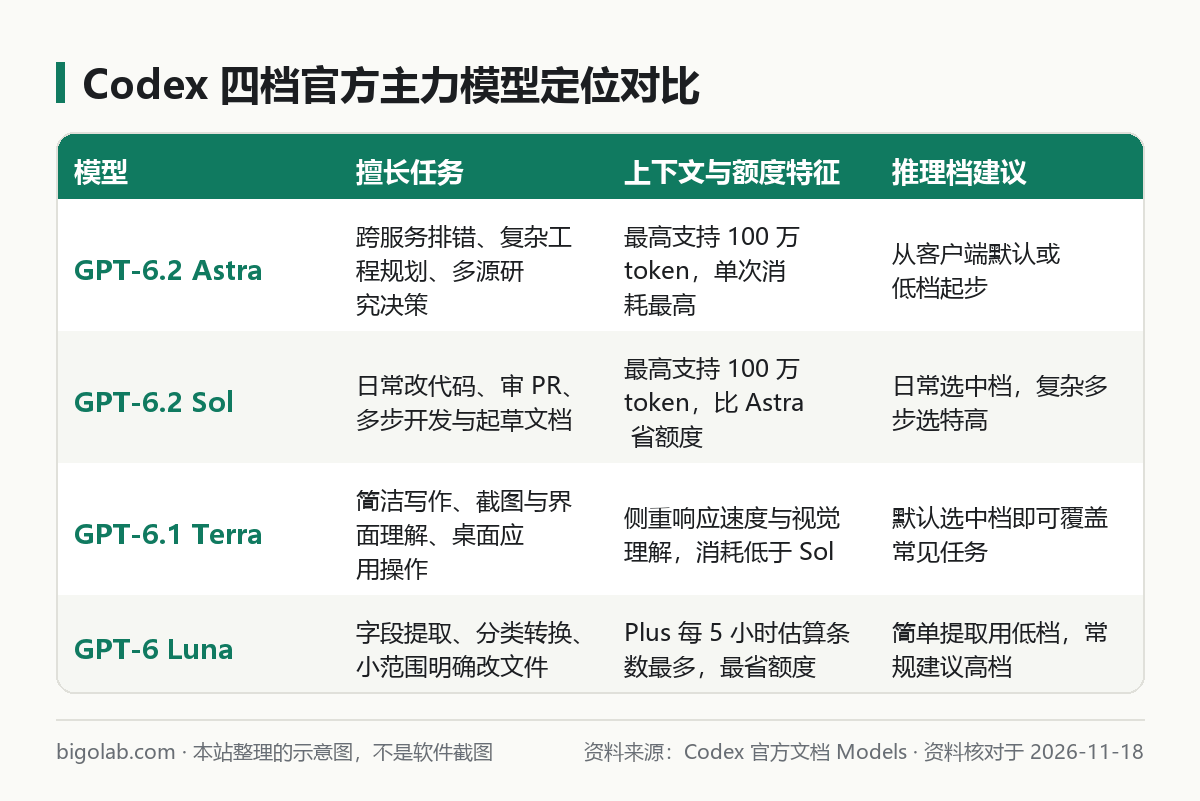
图:本站根据 Codex 官方文档:Models 整理的示意图
本文根据 Codex 官方文档《Models》《GPT-6.2》《Pricing》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 搜「codex模型推荐」「codex模型排行」,面对模型列表不知道日常写代码该选哪一个的人;
- 想在推理深度、等待时间和套餐额度消耗之间找到平衡的人;
- 旧脚本或配置里还写着已退役模型名,需要换到当前在用模型的人。
一、四个主力模型各自擅长什么
按官方文档对当前主力模型的划分,不要只看谁最强,而是看任务需不需要持续的多步推理:
- GPT-6.2 Astra(及 GPT-6 Astra):面向最难的端到端工作。适合跨多个服务追踪故障根因、修复并跑通关联测试,或在多份冲突方案之间权衡利弊。它与 GPT-6.2 Sol 一样支持最高 100 万 token 的上下文窗口(详见 Codex App 怎么设置 1M 上下文)。
- GPT-6.2 Sol(及 GPT-6.1 Sol):面向日常主力开发。适合在现有代码库里修 Bug、加功能、审阅合并请求(PR)、按评审意见改代码,以及把会议纪要整理成实施计划。标准速度下,它的每百万 token 点数消耗只有 GPT-6.2 Astra 的四分之一。
- GPT-6.1 Terra:面向日常写作、视觉理解与电脑操作。适合看仪表盘或网页截图总结变化、核对界面元素、按源文档填表,以及范围明确的小修小补。命令行使用需 Codex CLI 0.159.0 及以上版本。
- GPT-6 Luna:面向清晰、可重复的高频任务。适合提取字段、做分类、转成固定表格,或做预期结果一目了然的文件小改动。
二、官方给出的「模型 + 推理强度」八组搭配
官方文档将常见工作对应到了八组起始档位,拿不准时可照着起步:
| 组合 | 官方推荐的典型场景 |
|---|---|
| GPT-6 Luna · Low | 预期结果明确的小文件修改、字段提取 |
| GPT-6 Luna · Extra high | 跨应用查找更新、排定跟进优先级、解决边界清晰的规则问题 |
| GPT-6.1 Terra · Medium | 操作桌面应用、更新记录、做容易验证的局部修复 |
| GPT-6.2 Sol · Medium | 在现有代码库修 Bug、加功能,或起草待审阅文档 |
| GPT-6.2 Sol · Extra high | 需要边写边跑测试、反复修正的多步开发任务 |
| GPT-6.2 Astra · Low | 把一份写得很清楚的需求简报直接变成可交付成品 |
| GPT-6.2 Astra · Medium | 规划并推进复杂工程,在执行中根据新信息调整方案 |
| GPT-6.2 Astra · Extra high | 处理开放式难题,需要权衡取舍并逐一验证假设 |
关于更高档位,官方单独区分了 Max(拉长单线推理时间,Luna 最高支持到 Max)和 Ultra(自动拆分子代理并行处理复杂任务的不同部分)。桌面端滑块没看到 Ultra 时,去 设置(Settings)> 配置(Configuration) 打开 Ultra in model picker slider;CLI 里输入 /model 选好模型后再选 More reasoning…。
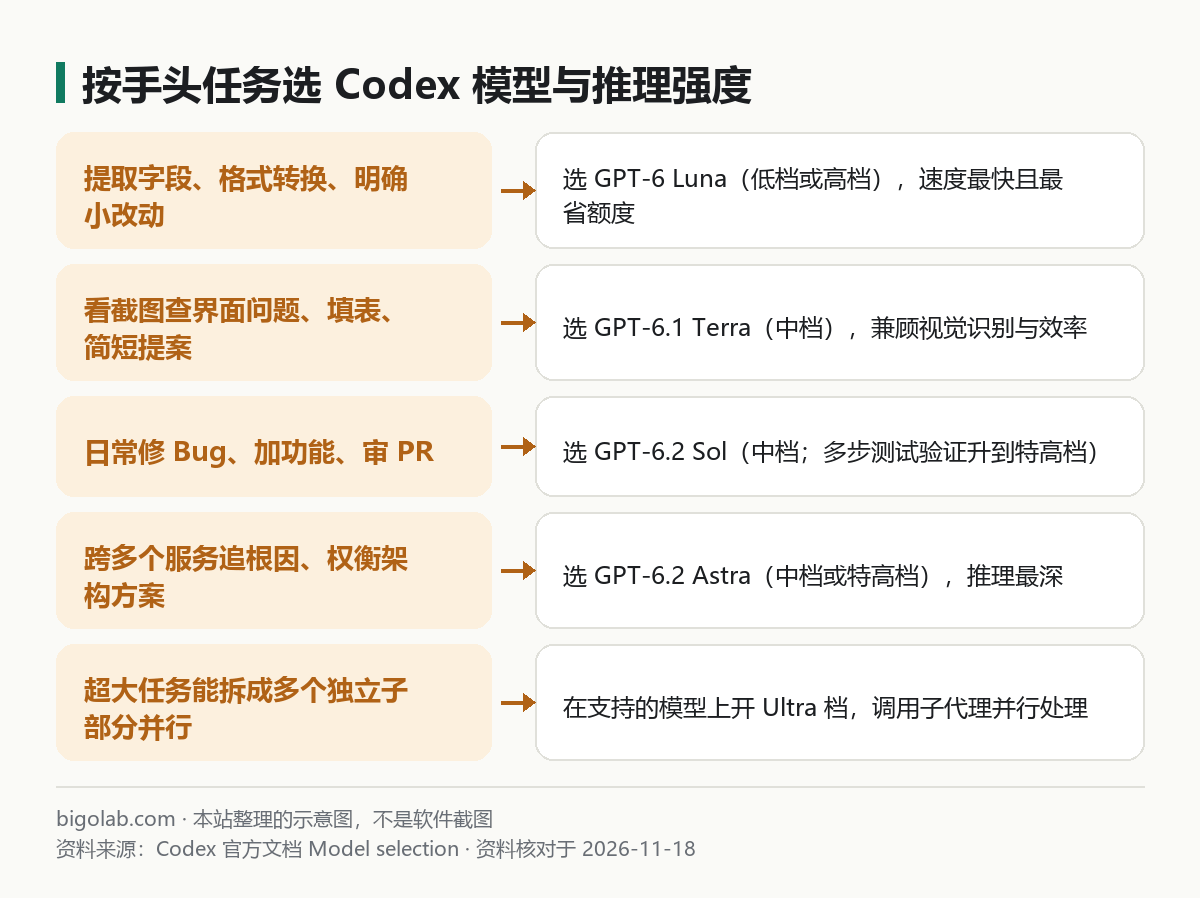
图:本站根据 Codex 官方文档:Models 整理的示意图
三、结合套餐额度看性价比与退役模型替换
按官方定价页对 Plus 和 Business 标准席位的每 5 小时本地消息估算区间:
- GPT-6.2 Astra:约 6–50 条;
- GPT-6.2 Sol:约 17–180 条;
- GPT-6.1 Terra:约 35–285 条;
- GPT-6 Luna:约 350–3,000 条。
日常用 Sol 中档、琐碎整理用 Luna、遇到卡壳难题再切 Astra,同一份套餐能撑起多得多的工作量。免费版与 Go 目前仅在桌面端逐步开放 GPT-6 Luna 且不含云端任务。想用上 Sol 与 Astra 跑完整开发,可看本站 ChatGPT Plus 充值说明 或无 5 小时限制的 ChatGPT Pro 充值说明,窗口细则见 Codex 额度与使用限制。
同时请检查 ~/.codex/config.toml(见 Codex config.toml 完整详解)和自动化脚本,把已从 ChatGPT 登录方式退役的旧模型名换掉:gpt-5.3-codex-spark(2026-09-14 退役,见 GPT-5.3 Codex Spark 退役说明)、gpt-5.5(2026-10-14 退役)、gpt-5.4 与 gpt-5.4-mini(2026-08-31 退役)以及已弃用的 gpt-5.2、gpt-5.3-codex。
常见问题
问:为什么我在桌面端或 CLI 的 /model 里看不到 GPT-6.2 Astra 或 Sol?
答:先更新客户端到最新版;若在 Enterprise 或 Edu 工作区,这两个模型默认关闭,需管理员在工作区模型设置里开启。
问:普通 ChatGPT 网页聊天里能选 GPT-6.2 Sol 吗?
答:官方说明 GPT-6.2 Astra、GPT-6.2 Sol、GPT-6.1 Sol 和 GPT-6.1 Terra 在 ChatGPT Work 与 Codex 中提供,普通 Chat 列表与它们独立。
问:多端共用 config.toml 时,model 默认值写哪个最稳?
答:官方建议填写你所有常用客户端(桌面端、CLI、IDE 扩展)都已开放的模型名,如 gpt-6.2-sol 或 gpt-6.1-sol。
相关教程
- Codex 怎么切换模型和思考强度
- Codex 额度与使用限制
- Codex App 怎么设置 1M 上下文
- GPT-5.3 Codex Spark 退役与替换说明
- Codex config.toml 完整详解
参考资料
- Codex 官方文档:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文档:GPT-6.2 — https://learn.chatgpt.com/docs/whats-new/gpt-62-astra-sol
- Codex 官方文档:Pricing — https://learn.chatgpt.com/docs/pricing
0 条评论
还没有评论,来抢沙发~